Lanzamiento de nuestro Dashboard de evolución del coronavirus
Cuando empezamos a ver los efectos del coronavirus en China empezamos a pensar en formas de interpretación de los datos que iban apareciendo. Finalmente nos centramos en los datos y estadísticas que la Universidad Johns Hopkins (JHU) estaba compartiendo mediante un panel de control que reflejaba la evolución referente a la cantidad de casos, muertos y recuperados especialmente en China vs el resto del mundo. Con posterioridad surgieron otros sitios web que mostraban la misma información con diferentes visualizaciones y tecnologías pero desde nuestro punto de vista no representaban ciertos puntos que podían de ser de interés. Así que nos pusimos manos a la obra para generar nuestro dashboard.
El resultado ha sido fiel a lo que inicialmente esperábamos buscando dar un enfoque analítico para poder ver tendencias, estimaciones futuras y comparativas entre países alineando en el eje temporal.
Nota de 2026: el dashboard estuvo publicado en keliam.com/covid-19 mientras las fuentes de datos originales siguieron actualizándose. La Universidad Johns Hopkins cerró su repositorio de datos y nosotros retiramos el panel poco después, porque un cuadro de mando que no se alimenta deja de ser útil y pasa a ser engañoso. Mantenemos este artículo como registro del proyecto y, sobre todo, de lo que aprendimos construyéndolo.
Actualización — Septiembre 2026
Nuestro dashboard de evolución del coronavirus fue una respuesta ágil a una necesidad social urgente, construido con tecnologías open source y datos públicos. Hoy, esa misma filosofía de desarrollo rápido y orientado a datos la aplicamos en proyectos de analítica para ecommerce, paneles de KPIs empresariales y sistemas de monitorización en tiempo real. Las herramientas de visualización han evolucionado enormemente desde 2020, con opciones como Apache Superset, Grafana y Redash que permiten crear dashboards profesionales sin licencias costosas.
El resto de este artículo recoge, en forma de guía, lo que hemos ido aprendiendo desde entonces montando paneles de datos para clientes: qué capas tiene un dashboard que aguanta en producción, qué herramienta elegir según quién vaya a usarlo y por qué la mayoría de proyectos de este tipo fracasan por motivos que no tienen nada que ver con la tecnología.
Las cuatro capas de un dashboard que aguanta en producción
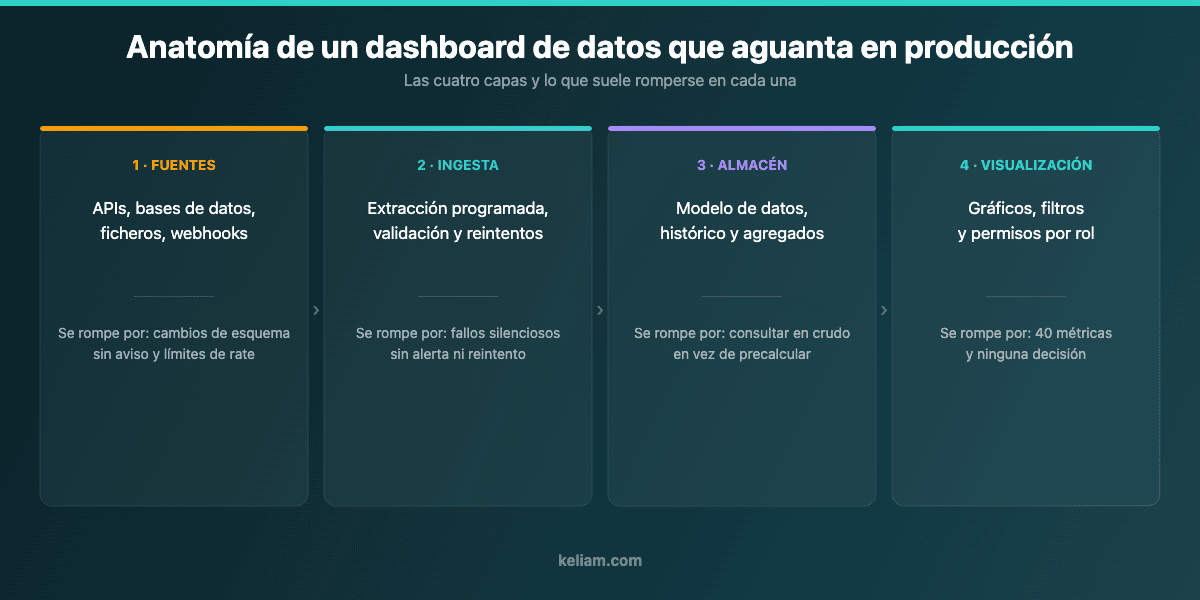
Un panel de datos parece una cosa — una pantalla con gráficos — pero por dentro son cuatro sistemas encadenados, y cada uno falla de una forma distinta. Entender esa separación es lo que distingue un proyecto que sigue funcionando al año siguiente de uno que se abandona en tres meses.
1. Fuentes
APIs de terceros, bases de datos propias, exportaciones en CSV, webhooks. En nuestro caso de 2020 era un repositorio público que se actualizaba a diario; en un proyecto de empresa suele ser una mezcla del ERP, la tienda online y alguna hoja de cálculo que alguien mantiene a mano. Lo que rompe esta capa casi siempre es un cambio de esquema sin aviso: una columna que cambia de nombre, un campo que pasa de entero a texto, un endpoint que se deprecia. Si la ingesta no valida lo que recibe, el error se propaga silenciosamente hasta el gráfico.
2. Ingesta
La extracción programada, la validación y los reintentos. Aquí es donde herramientas de automatización como n8n han cambiado el panorama: lo que antes eran scripts propios con cron ahora se resuelve con flujos visuales que ya traen reintentos y registro. Si te interesa esa vía, tenemos guías sobre cómo instalar n8n en producción con Docker y PostgreSQL y sobre cómo conectar APIs REST y bases de datos.
El fallo característico de esta capa es el fallo silencioso: el proceso nocturno se cae, nadie se entera, y durante dos semanas el equipo toma decisiones mirando datos congelados. Una alerta cuando una carga no termina vale más que cualquier gráfico bonito.
3. Almacén y modelo de datos
Dónde se guardan los datos ya limpios, cómo se estructura el histórico y qué agregados se precalculan. Es la capa más invisible y la que más determina si el panel irá rápido o lento. El error clásico es consultar las tablas operativas en crudo cada vez que alguien abre el dashboard: funciona con 10.000 filas y se desploma con 10 millones.
4. Visualización
Los gráficos, los filtros y los permisos. Es la parte que todo el mundo ve y la que menos problemas técnicos da. Su fallo típico no es técnico sino de diseño: cuarenta métricas en pantalla y ninguna decisión que se pueda tomar con ellas.
Elegir herramienta: el panorama open source en 2026
La pregunta que nos hacen siempre es cuál es la mejor herramienta. La respuesta honesta es que depende casi por completo de quién va a usarla y de qué tipo de datos son.
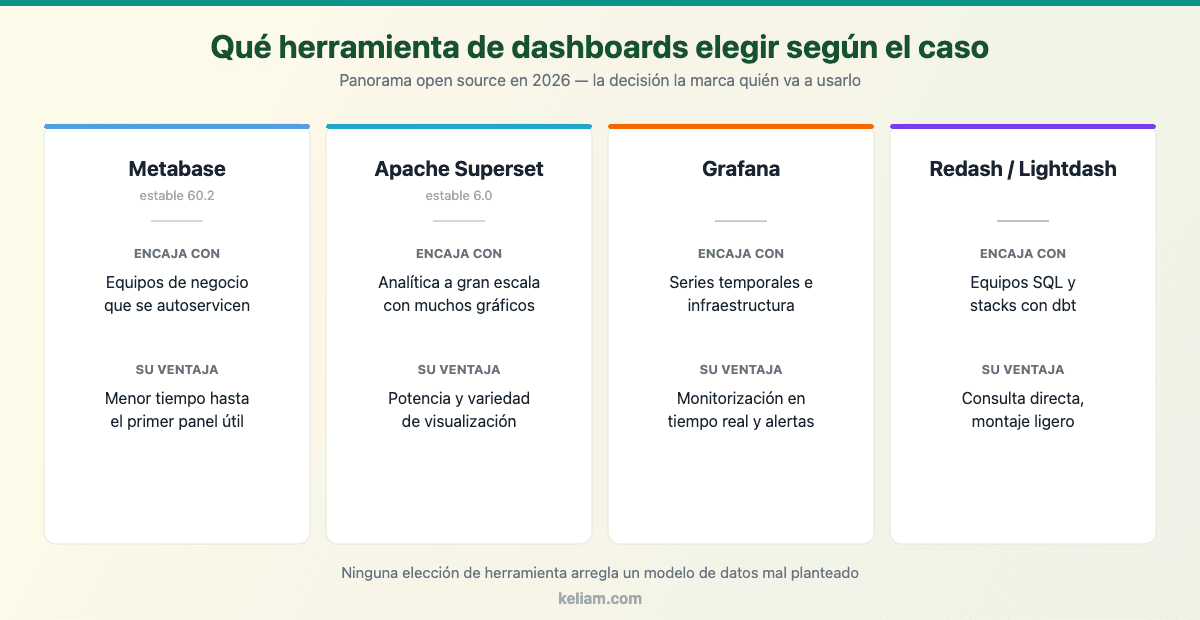
Metabase es la opción con menor tiempo hasta el primer panel útil y la que mejor funciona cuando los equipos de negocio van a hacerse sus propias consultas sin pasar por sistemas. Es, con diferencia, la más extendida: da servicio a paneles en más de 60.000 organizaciones, y su rama estable en 2026 es la 60.2, publicada el 22 de abril.
Apache Superset, bajo el paraguas de la Apache Software Foundation y con la 6.0 como versión estable, gana cuando hay analítica a gran escala y se necesita variedad y personalización de visualizaciones. Pide más conocimiento técnico a cambio de más techo.
Grafana sigue siendo la referencia en series temporales, monitorización de infraestructura y alertas en tiempo real. Si lo que quieres vigilar es el estado de unos sistemas más que la evolución de un negocio, es la elección natural — y enlaza directamente con la monitorización de red en empresas, donde el panel y la alerta son la misma herramienta.
Redash y Lightdash cubren el caso de equipos que viven en SQL o que ya tienen un stack basado en dbt: montaje ligero, consulta directa, menos capa intermedia.
Ninguna de estas elecciones arregla un modelo de datos mal planteado. Si la capa 3 está mal, cambiar de herramienta de visualización solo cambia el aspecto del problema.
Diseñar métricas que sirvan para decidir
El error más caro de un proyecto de dashboards no es técnico. Es construir un panel precioso que nadie abre porque no responde a ninguna pregunta que alguien se esté haciendo de verdad.
La prueba que usamos antes de dibujar nada es sencilla: por cada métrica que se quiere incluir, hay que poder completar la frase «si este número sube o baja, haremos X». Si nadie sabe terminar la frase, la métrica es decorativa. En un panel de ecommerce eso descarta la mitad de lo que la gente pide al principio y deja fuera casi siempre el número total de visitas, que rara vez cambia una decisión por sí solo.
Tres criterios adicionales que nos ahorran discusiones:
- Una pantalla, una audiencia. El panel de dirección y el panel del equipo de operaciones no son el mismo con más o menos filtros. Mezclarlos produce uno que no sirve a nadie.
- Comparación siempre. Un número suelto no informa. Frente al mismo periodo del año anterior, frente al objetivo o frente a la media móvil, sí.
- Definición escrita de cada métrica. «Pedidos» no significa lo mismo para el equipo de ventas que para el de logística. Si no está escrito, tarde o temprano dos personas discutirán mirando la misma pantalla.
Para el caso concreto del comercio electrónico desarrollamos esto con más detalle en nuestra guía de business intelligence y dashboards para ecommerce, y la parte de conectar los datos de varios sistemas en integraciones API entre ecommerce, ERP, logística y pagos.
Por qué un dashboard se vuelve lento
Casi siempre por la misma razón: se consulta el dato en crudo en el momento en que alguien abre la página. Mientras el volumen es pequeño no se nota; cuando el histórico crece, cada carga dispara consultas que agregan millones de filas y el panel tarda veinte segundos en pintar. Para entonces la gente ya ha dejado de abrirlo.
Las tres medidas que más rendimiento devuelven por esfuerzo invertido:
- Precalcular agregados. Si el panel muestra ventas por día y por categoría, esa tabla se calcula una vez al cerrar el día, no en cada visita.
- Limitar el rango por defecto. Abrir en los últimos 30 días y dejar que el usuario ample el rango si lo necesita es muchísimo más barato que abrir con todo el histórico.
- Caché con caducidad explícita. Un panel de dirección no necesita el dato al segundo; con una caché de quince minutos y la hora de actualización visible en pantalla se resuelve el 90 % de los casos.
Merece la pena tratar el dashboard como lo que es: una aplicación más, con su rendimiento a vigilar. La misma disciplina que aplicamos a las métricas de Core Web Vitals en una web pública sirve aquí, aunque el panel sea interno.
Seguridad y acceso a los datos
Un panel de BI concentra, por diseño, lo más sensible que tiene una empresa: facturación, márgenes, clientes, a veces datos personales. Y sin embargo se despliega con mucha más ligereza que cualquier otra aplicación interna.
Lo mínimo razonable: autenticación integrada con el directorio de la empresa en lugar de usuarios locales sueltos, permisos por rol a nivel de conjunto de datos y no solo de panel, credenciales de solo lectura para la conexión a base de datos, y el panel nunca expuesto directamente a internet sin control de acceso. Si la herramienta es autoalojada, entra además en el ciclo de actualizaciones: una instancia de Superset o Metabase sin parchear durante dos años es una puerta abierta.
Para empresas sujetas a marcos regulatorios, un panel de BI forma parte del alcance del sistema de gestión como cualquier otra aplicación con datos de negocio. Si os aplica la directiva NIS2, conviene tenerlo inventariado desde el principio, y una auditoría de seguridad periódica debería incluirlo explícitamente.
Errores habituales que hemos visto (y cometido)
Construir antes de preguntar. Es tentador empezar por los gráficos porque es la parte divertida. Dos semanas de conversaciones con quien va a usar el panel ahorran dos meses de rehacerlo.
No fijar el propietario del dato. Todo dashboard necesita una persona responsable de que las cifras sean correctas. Sin ese nombre, la primera vez que un número parezca raro el panel perderá la confianza del equipo y ya no la recupera.
Olvidar el mantenimiento. Las fuentes cambian, las APIs se deprecian, las herramientas publican versiones nuevas. Un panel es software vivo; presupuestar solo la construcción es garantizar que en un año esté roto. Es el mismo razonamiento que aplicamos al mantenimiento de software en general.
Confundir tiempo real con útil. Muy pocas decisiones de negocio se toman al segundo. El tiempo real multiplica el coste de infraestructura y casi nunca cambia una decisión; para monitorización técnica sí tiene sentido, para un panel de ventas rara vez.
Ignorar lo que ya puede hacer la IA sobre esos datos. Buena parte del trabajo de interpretar un panel — resumir la semana, señalar anomalías, redactar el comentario del informe mensual — hoy se automatiza razonablemente bien. Lo tratamos en la comparativa de plataformas de IA para empresas y, cuando el conocimiento está disperso en documentos en vez de en tablas, en nuestra guía de implementación de RAG en empresas.
Cuánto cuesta y cuánto tarda
Es la pregunta que llega después de la de la herramienta, y la respuesta también incomoda: el coste de un proyecto de dashboards casi nunca está en la visualización. Está en limpiar y conciliar los datos de origen.
Por nuestra experiencia, el reparto típico de esfuerzo en un primer panel de empresa se parece bastante a esto: alrededor de la mitad del tiempo se va en entender y normalizar las fuentes, una cuarta parte en construir el modelo de datos y las cargas, y el resto se reparte entre la visualización y los ajustes tras las primeras semanas de uso. Cuando un presupuesto solo contempla la última parte, el proyecto se desborda sin remedio.
En plazos, un primer panel acotado — una audiencia, cinco o seis métricas, dos fuentes de datos — es razonable en unas pocas semanas. Lo que se alarga es querer cubrir toda la empresa de golpe: ahí el proyecto se convierte en una integración de sistemas disfrazada de dashboard, y conviene reconocerlo desde el principio y planificarlo como tal. Es lo que ocurre cuando los datos viven repartidos entre un ERP, un CRM y la tienda online; en esos casos la parte pesada es la sincronización, como contamos al explicar cómo sincronizar CRM y ERP con n8n o al analizar una transformación digital en una empresa industrial B2B.
La recomendación práctica: empezar por el panel más pequeño que ya cambie una decisión. Si en un mes hay una reunión en la que alguien decide algo mirando esa pantalla, el proyecto tiene futuro. Si no, ampliar el alcance solo hará el fracaso más caro.
Preguntas frecuentes
¿Hace falta un data warehouse desde el principio? No. Para dos o tres fuentes y volúmenes moderados, una base de datos relacional bien modelada con tablas de agregados es suficiente y mucho más barata de mantener. El almacén dedicado tiene sentido cuando el volumen o el número de orígenes lo justifican, no antes.
¿Mejor herramienta autoalojada o de pago en la nube? Autoalojada da control y evita el coste por usuario, pero añade la responsabilidad de actualizar, copiar y asegurar la instancia. Si no hay nadie que vaya a encargarse de eso, una opción gestionada sale más barata de lo que parece.
¿Puede un dashboard sustituir a los informes en hoja de cálculo? Solo si es más cómodo que la hoja de cálculo. Mientras alguien tenga que exportar del panel para hacer su análisis real, el panel no ha ganado. Merece la pena preguntar qué se hace con el dato después de mirarlo.
¿Cada cuánto hay que revisar las métricas? Una revisión semestral suele bastar para retirar lo que ya nadie mira y añadir lo que el negocio ha empezado a necesitar. Un panel que solo crece acaba siendo ilegible.
¿Y si nuestros datos están en un ERP antiguo? Es el caso más habitual. Normalmente se resuelve con una capa de extracción que no toca el sistema original, y a veces es el momento de plantear la modernización de fondo — lo tratamos en la guía sobre migrar un ERP on-premise a la nube.
Conclusión
Aquel dashboard de 2020 se construyó en unos pocos días con datos públicos y herramientas libres, y funcionó mientras tuvo una fuente que lo alimentara. Esa es, seis años después, la lección que seguimos aplicando: un panel de datos vale exactamente lo que valga la tubería que lo alimenta y la pregunta que intenta responder.
Si estás planteando un proyecto de analítica interna, el orden que funciona es preguntar primero qué decisiones quieres poder tomar, diseñar después el modelo de datos, y dejar la elección de herramienta para el final. Es el orden contrario al que sigue casi todo el mundo, y es la diferencia entre un panel que el equipo abre cada lunes y uno que acaba en una pestaña que nadie recuerda haber pedido.
📊 ¿Necesitas un panel de datos que tu equipo use de verdad?
En Keliam diseñamos y mantenemos dashboards y sistemas de analítica a medida: desde la ingesta de datos hasta la visualización, con el modelo de datos pensado para que siga funcionando cuando el volumen crezca.
- Servicios IT y consultoría — analítica de negocio y desarrollo a medida
- Auditoría Técnica — revisión de rendimiento y modelo de datos
- Mantenimiento de software — que las tuberías de datos no se rompan en silencio
- Mantenimiento ecommerce — KPIs y analítica para tiendas online

