
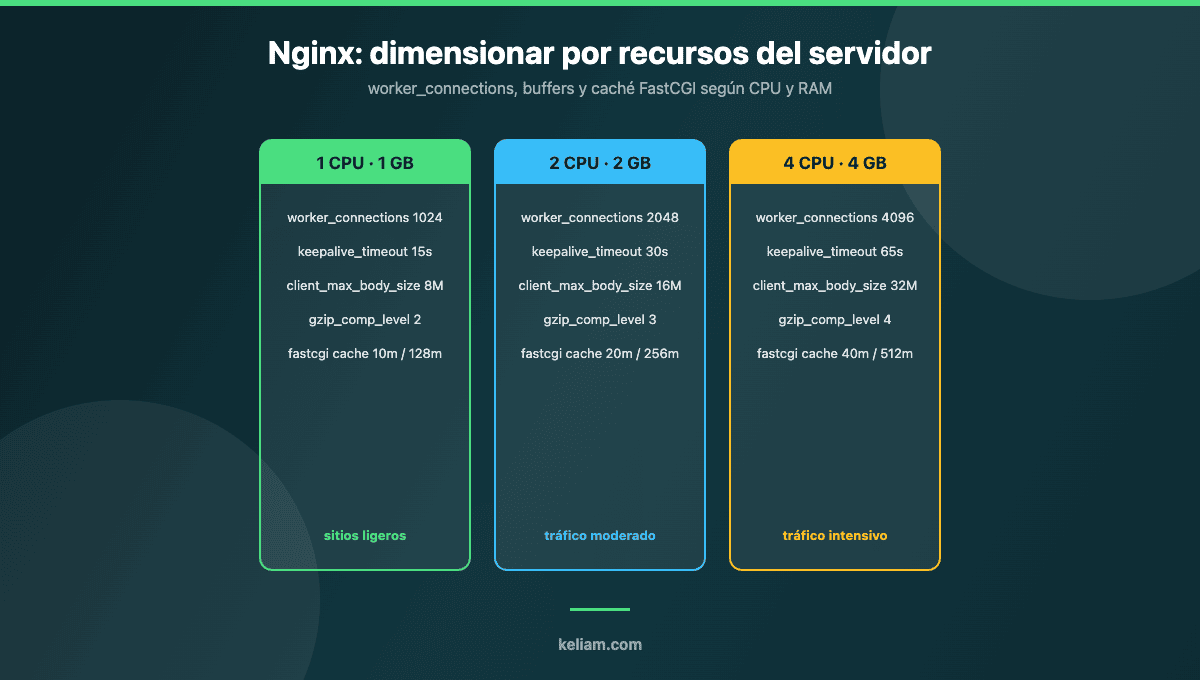
Nginx es un servidor web poderoso que, cuando se configura adecuadamente, puede manejar una gran cantidad de tráfico con una eficiencia impresionante. Este artículo proporciona una guía completa sobre cómo optimizar Nginx ajustando sus parámetros clave, enfocándose en configuraciones para tres escenarios de servidor distintos: 1 CPU y 1 GB de RAM, 2 CPUs y 2 GB de RAM, y 4 CPUs y 4 GB de RAM. Cada configuración está diseñada para maximizar el rendimiento y la estabilidad en función de los recursos disponibles.
Han pasado varios ciclos de versiones desde que escribimos esta guía, y buena parte de lo que entonces era «configuración avanzada» hoy viene resuelto de serie. Nginx sigue el modelo de dos ramas: mainline (segundo número impar, hoy la serie 1.31.x) y stable (segundo número par, hoy la serie 1.30.x, publicada en abril de 2026). La rama stable solo recibe correcciones de fallos graves y de seguridad, así que es la que recomendamos en cualquier servidor de producción salvo que necesites una funcionalidad concreta que todavía viva solo en mainline. Las configuraciones de esta guía funcionan en ambas, pero más abajo hemos añadido una sección con lo que ha cambiado en 2026 y que obliga a revisar configuraciones antiguas: en particular, el keepalive hacia los backends ya está activado por defecto.
Si lo que buscas es una foto completa del rendimiento de tu sitio antes de tocar parámetros, conviene empezar midiendo: nuestra guía de auditoría de rendimiento web y métricas clave explica qué herramientas usar y cómo interpretar los números, y el artículo sobre Core Web Vitals en 2026 y la métrica INP aclara qué umbrales mira hoy Google. Optimizar Nginx sin medir antes es afinar a ciegas.
Parámetros y Variables Clave en la Configuración de Nginx
Antes de sumergirnos en las configuraciones específicas, es importante comprender los principales parámetros y archivos que controlan el comportamiento de Nginx:
Archivo principal de configuración de Nginx:
Ruta: /etc/nginx/nginx.conf
Este archivo controla la configuración global de Nginx, incluyendo la gestión de procesos, tiempo de espera, y opciones de rendimiento.
Archivos de configuración de sitios (servidores virtuales):
Ruta: /etc/nginx/sites-available/ y /etc/nginx/sites-enabled/
Aquí se especifican configuraciones específicas para cada sitio o servidor virtual que se aloja en Nginx.
Parámetros Clave a Configurar:
worker_processes
Controla cuántos procesos de trabajo Nginx utilizará. El valor auto permite a Nginx detectar automáticamente el número de núcleos de CPU disponibles y asignar procesos en consecuencia.
worker_connections
Define el número máximo de conexiones simultáneas que cada proceso de trabajo puede manejar.
ssl_protocols
Define los protocolos SSL/TLS que Nginx usará para conexiones seguras. Se recomienda deshabilitar versiones obsoletas y vulnerables como SSLv3 y TLSv1.0 y TLSv1.1, utilizando solo TLSv1.2 y TLSv1.3 para mejorar la seguridad.
client_body_timeout, client_header_timeout, send_timeout
Ajustan los tiempos de espera para diferentes fases de la comunicación con el cliente. Estos ajustes aseguran que los clientes lentos no consuman demasiados recursos.
keepalive_timeout
Ajustado para mantener conexiones abiertas durante un tiempo razonable sin consumir demasiados recursos.
client_body_buffer_size, client_header_buffer_size, large_client_header_buffers
Ajustan los tamaños de los búferes para manejar mejor los datos de solicitud del cliente, optimizando el rendimiento en el manejo de solicitudes más complejas.
client_max_body_size
Limita el tamaño máximo del cuerpo de la solicitud que Nginx aceptará, lo que ayuda a prevenir abusos en el uso de recursos.
Configuración para Diferentes Escenarios de Servidor
1. Servidor con 1 CPU y 1 GB de RAM
Objetivo: Optimizar el uso de recursos limitados, ideal para sitios web pequeños o aplicaciones ligeras.
worker_processes auto;

events {
    worker_connections 1024;
    use epoll;
    multi_accept on;
}

http {
    keepalive_timeout 15s;
    sendfile on;
    tcp_nopush on;
    tcp_nodelay on;
    client_max_body_size 8M;

    gzip on;
    gzip_disable "msie6";
    gzip_vary on;
    gzip_proxied any;
    gzip_comp_level 2;
    gzip_buffers 16 8k;
    gzip_http_version 1.1;
    gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;

    fastcgi_cache_path /var/cache/nginx/fastcgi_temp levels=1:2 keys_zone=fastcgicache:10m max_size=128m;
    fastcgi_buffers 4 8k;

    access_log /var/log/nginx/access.log;
    error_log /var/log/nginx/error.log;

    server {
        listen 80;
        server_name ejemplo.com;
        root /var/www/html;
        index index.html;
    }
}
2. Servidor con 2 CPUs y 2 GB de RAM
Objetivo: Mejorar la capacidad para manejar tráfico moderado y optimizar el rendimiento general.
worker_processes auto;

events {
    worker_connections 2048;
    use epoll;
    multi_accept on;
}

http {
    keepalive_timeout 30s;
    sendfile on;
    tcp_nopush on;
    tcp_nodelay on;
    client_max_body_size 16M;

    gzip on;
    gzip_disable "msie6";
    gzip_vary on;
    gzip_proxied any;
    gzip_comp_level 3;
    gzip_buffers 16 8k;
    gzip_http_version 1.1;
    gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;

    fastcgi_cache_path /var/cache/nginx/fastcgi_temp levels=1:2 keys_zone=fastcgicache:20m max_size=256m;
    fastcgi_buffers 8 16k;

    access_log /var/log/nginx/access.log;
    error_log /var/log/nginx/error.log;

    server {
        listen 80;
        server_name ejemplo.com;
        root /var/www/html;
        index index.html;
    }
}
3. Servidor con 4 CPUs y 4 GB de RAM
Objetivo: Optimizar al máximo el rendimiento para manejar tráfico intensivo y asegurar la estabilidad del servidor.
worker_processes auto;

events {
    worker_connections 4096;
    use epoll;
    multi_accept on;
}

http {
    client_body_timeout 30s;
    client_header_timeout 30s;
    keepalive_timeout 65s;
    send_timeout 30s;

    client_body_buffer_size 16k;
    client_header_buffer_size 4k;
    client_max_body_size 32M;
    large_client_header_buffers 4 8k;

    gzip on;
    gzip_disable "msie6";
    gzip_vary on;
    gzip_proxied any;
    gzip_comp_level 4;
    gzip_buffers 32 16k;
    gzip_http_version 1.1;
    gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;

    fastcgi_cache_path /var/cache/nginx/fastcgi_temp levels=1:2 keys_zone=fastcgicache:40m max_size=512m;
    fastcgi_buffers 16 32k;

    ssl_protocols TLSv1.2 TLSv1.3;
    ssl_prefer_server_ciphers on;

    access_log /var/log/nginx/access.log;
    error_log /var/log/nginx/error.log;

    server {
        listen 80;
        server_name ejemplo.com;
        root /var/www/html;
        index index.html;
    }
}
En Keliam, estamos comprometidos con ayudarte a optimizar tu infraestructura de servidores. Si necesitas asistencia para implementar estas configuraciones o para desarrollar una estrategia de optimización personalizada, no dudes en contactarnos. ¡Estamos aquí para asegurar que tu servidor Nginx funcione de la mejor manera posible!
Si quieres ver como configurar tu PHP-FPM 8 para tu web o ecommerce visita nuestra otra entrada.
Qué ha cambiado en Nginx en 2026 (y qué tienes que revisar)
La rama stable 1.30, publicada en abril de 2026, es la más relevante de los últimos años para quien administra servidores dedicados, porque además de funcionalidades nuevas cambia un comportamiento por defecto. Estos son los puntos que afectan directamente a una configuración como las de arriba.
Keepalive hacia los backends activado por defecto
Es el cambio con más impacto práctico. Hasta la 1.30, si querías conexiones persistentes entre Nginx y tu backend (PHP-FPM sobre HTTP, un Node, un Gunicorn, otro Nginx) tenías que declararlo a mano en el bloque upstream con keepalive y además subir la versión de protocolo con proxy_http_version 1.1 y limpiar la cabecera Connection. A partir de la 1.30 el keepalive hacia upstreams está habilitado por defecto y la versión de protocolo del módulo proxy pasa a ser 1.1.
Esto significa dos cosas. La primera, buena: cualquier despliegue que usara el módulo proxy sin configurar keepalive gana conexiones persistentes sin tocar nada, y con ellas menos handshakes TCP y menos latencia por petición. La segunda, a vigilar: si tu backend o un balanceador intermedio no maneja bien conexiones persistentes, el comportamiento por defecto cambia bajo tus pies al actualizar. Antes de subir de rama, revisa los bloques upstream y comprueba en los logs si aparecen errores de conexión reiniciada. Si necesitas volver al comportamiento anterior en un upstream concreto, puedes desactivarlo explícitamente en ese bloque en lugar de renunciar a la mejora en todo el servidor.
Early Hints (código 103)
Nginx puede ahora enviar una respuesta preliminar con estado 103 Early Hints con las cabeceras Link: rel=preload antes de que el backend haya terminado de generar la página. El navegador aprovecha ese hueco para empezar a descargar el CSS y el JavaScript críticos mientras el servidor de aplicaciones sigue trabajando. En sitios donde el tiempo de generación en backend es de varios cientos de milisegundos —un WooCommerce con catálogo grande, un PrestaShop sin caché de página completa— es una de las pocas optimizaciones que mejora el Largest Contentful Paint sin tocar el código de la aplicación.
HTTP/2 hacia el backend
Históricamente Nginx atendía al cliente por HTTP/2 pero hablaba con el backend por HTTP/1.x. La 1.30 permite HTTP/2 también en la pata del proxy, lo que abre multiplexación y compresión de cabeceras de extremo a extremo. Es útil sobre todo cuando el backend es un servicio que ya habla HTTP/2 de forma nativa o cuando proxeas muchas peticiones pequeñas con cabeceras repetitivas, típico de APIs internas.
Sesiones persistentes (sticky sessions) en upstreams
El balanceo de carga de Nginx open source incorpora por fin sticky sessions, es decir, la capacidad de enviar las peticiones sucesivas de un mismo cliente al mismo servidor del grupo. Era una de las funcionalidades más pedidas y hasta ahora obligaba a soluciones de compromiso con ip_hash, a la versión comercial o a mover la sesión a un almacén compartido. Si tienes una aplicación con estado que no puedes adaptar fácilmente a varios backends, esto simplifica mucho la arquitectura.
Encrypted ClientHello (ECH)
Con ECH, Nginx cifra la parte del handshake TLS que hasta ahora viajaba en claro, señaladamente el SNI con el nombre del dominio solicitado. Un observador de la red deja de poder deducir a qué dominio concreto se conecta el cliente cuando varios sitios comparten IP. Es una mejora de privacidad más que de rendimiento, y encaja en cualquier plan de endurecimiento como los que describimos en la guía de ciberseguridad de servidores con poco presupuesto.
Multipath TCP
El soporte de MPTCP permite que una misma conexión use varias rutas de red simultáneamente —por ejemplo WiFi y datos móviles en un cliente—, lo que hace las conexiones más resistentes a cortes y, en el mejor de los casos, aumenta el ancho de banda efectivo. Requiere soporte en el kernel y en el cliente, así que hoy es más interesante para escenarios móviles que para el servidor web medio.
Actualiza por seguridad, no solo por funcionalidad
Las versiones más recientes de ambas ramas corrigen un desbordamiento de búfer en el módulo ngx_http_v3_module, el de HTTP/3. Si tienes QUIC activado, no es una actualización opcional: es la razón principal para estar en la última versión de tu rama y no en la que instalaste hace dos años. Mantener el servidor al día es exactamente el tipo de tarea rutinaria que conviene tener cubierta por un contrato de mantenimiento en lugar de dejarla a un recordatorio en el calendario.
HTTP/3 y QUIC: cuándo activarlo y cómo
HTTP/3 sustituye TCP por QUIC sobre UDP, lo que elimina el head-of-line blocking de la capa de transporte y fusiona el establecimiento de conexión con el handshake TLS. En redes con pérdida de paquetes —móviles, WiFi saturado— la mejora en el tiempo hasta el primer byte es perceptible; en una conexión de fibra estable la diferencia es mucho más modesta. Conviene activarlo con esa expectativa, no esperando un salto milagroso en PageSpeed.
El soporte requiere que tu binario incluya el módulo de HTTP/3, algo que ya traen los paquetes oficiales de nginx.org. Una configuración mínima sobre el escenario de 4 CPUs sería así:
server {
    # HTTP/1.1 y HTTP/2 sobre TCP
    listen 443 ssl;
    http2 on;

    # HTTP/3 sobre QUIC (UDP)
    listen 443 quic reuseport;

    server_name ejemplo.com;

    ssl_certificate     /etc/letsencrypt/live/ejemplo.com/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/ejemplo.com/privkey.pem;
    ssl_protocols TLSv1.2 TLSv1.3;

    # anuncia al navegador que hay HTTP/3 disponible
    add_header Alt-Svc 'h3=":443"; ma=86400' always;

    location / {
        root /var/www/html;
        index index.html;
    }
}
Tres detalles que dan problemas en la práctica:
- El firewall. QUIC va por UDP en el puerto 443. Si solo tienes abierto TCP/443, el navegador intentará HTTP/3, fallará y caerá de vuelta a HTTP/2 sin avisarte. Abre UDP/443 explícitamente y verifícalo desde fuera del servidor.
reuseportuna sola vez. La directiva debe aparecer en un únicolisten ... quicpor puerto y dirección. Repetirla en varios virtual hosts hace que Nginx no arranque.- La cabecera
Alt-Svc. Sin ella los navegadores no saben que hay HTTP/3 disponible y nunca lo intentan. Es el olvido más común al activar QUIC.
Sobre ssl_early_data (el 0-RTT, que permite al cliente enviar datos en el primer viaje): reduce latencia pero abre la puerta a ataques de repetición, porque esos datos pueden reenviarse. Si lo activas, asegúrate de que tu aplicación no ejecuta operaciones con efectos secundarios en peticiones idempotentes y trata las peticiones de early data con la desconfianza que merecen. En un ecommerce, nuestra recomendación por defecto es dejarlo desactivado.
Caché a nivel de Nginx: donde está la mejora de verdad
Los parámetros de workers y buffers evitan que el servidor se atragante, pero el salto grande en rendimiento casi siempre viene de no ejecutar la aplicación. Un WordPress que tarda 400 ms en generar una página pasa a responder en 5-10 ms si Nginx sirve una copia cacheada sin despertar a PHP.
Caché FastCGI para PHP
Las configuraciones de los tres escenarios ya declaran fastcgi_cache_path, pero declarar la zona no activa nada: hay que definir la clave y usarla en el location que pasa a PHP.
fastcgi_cache_path /var/cache/nginx/fastcgi_temp levels=1:2 keys_zone=fastcgicache:40m max_size=512m inactive=60m;
fastcgi_cache_key "$scheme$request_method$host$request_uri";

map $http_cookie $salta_cache {
    default 0;
    ~*wordpress_logged_in 1;
    ~*woocommerce_items_in_cart 1;
    ~*comment_author 1;
}

server {
    set $skip $salta_cache;
    if ($request_method = POST) { set $skip 1; }
    if ($query_string != "")    { set $skip 1; }

    location ~ \.php$ {
        fastcgi_pass unix:/run/php/php8.3-fpm.sock;
        fastcgi_index index.php;
        include fastcgi_params;

        fastcgi_cache fastcgicache;
        fastcgi_cache_valid 200 301 302 60m;
        fastcgi_cache_bypass $skip;
        fastcgi_no_cache $skip;
        fastcgi_cache_use_stale error timeout updating http_500 http_502 http_503;
        fastcgi_cache_background_update on;
        fastcgi_cache_lock on;
        add_header X-FastCGI-Cache $upstream_cache_status;
    }
}
Las tres directivas que la mayoría de configuraciones olvidan son las que más valen: fastcgi_cache_use_stale sirve la copia caducada si el backend falla, con lo que una caída de PHP-FPM no tumba la web; fastcgi_cache_background_update refresca la copia en segundo plano en vez de hacer esperar al visitante que se topa con la entrada caducada; y fastcgi_cache_lock evita la estampida en la que cincuenta peticiones simultáneas regeneran a la vez la misma página. La cabecera X-FastCGI-Cache es para ti: te deja comprobar con curl -I si estás recibiendo HIT, MISS o BYPASS, que es la única forma de saber si la caché realmente funciona.
Lo crítico es la lista de exclusiones. Cachear la página de un usuario identificado o un carrito con productos es peor que no cachear nada, porque sirve datos de una sesión a otra. Empieza excluyendo generosamente y ve afinando. Los mismos principios, aplicados a otra pila, los detallamos en la guía de optimización de rendimiento en Drupal con caché, BigPipe y Varnish.
open_file_cache y contenido estático
Para sitios con muchos ficheros pequeños, guardar en memoria los descriptores y metadatos ahorra llamadas al sistema en cada petición:
open_file_cache max=10000 inactive=30s;
open_file_cache_valid 60s;
open_file_cache_min_uses 2;
open_file_cache_errors on;

location ~* \.(jpg|jpeg|png|webp|avif|gif|ico|css|js|woff2)$ {
    expires 1y;
    add_header Cache-Control "public, immutable";
    access_log off;
}
Ese access_log off en estáticos no es cosmético: en un sitio con cien recursos por página, quitar el registro de cada uno reduce de forma apreciable la escritura a disco.
Límites del sistema: el techo que no está en nginx.conf
Subir worker_connections a 4096 no sirve de nada si el sistema operativo no deja abrir tantos descriptores de fichero. Cada conexión consume al menos uno, y en un proxy consume dos: la del cliente y la del backend. Es el error de configuración más frecuente que encontramos al auditar servidores: valores generosos en Nginx y un límite del sistema que los deja en papel mojado.
# en nginx.conf, junto a worker_processes
worker_rlimit_nofile 65535;

# en /etc/security/limits.conf
www-data soft nofile 65535
www-data hard nofile 65535

# en /etc/sysctl.d/99-nginx.conf
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 65535
net.ipv4.ip_local_port_range = 1024 65535
net.ipv4.tcp_fin_timeout = 15
net.ipv4.tcp_tw_reuse = 1
fs.file-max = 200000
La regla de oro: worker_rlimit_nofile debe ser mayor que worker_connections, con margen. Y net.core.somaxconn tiene que acompañar al backlog que declares en la directiva listen, porque si la cola del kernel es más pequeña las conexiones se descartan antes de que Nginx las vea. Aplica los cambios con sysctl --system y comprueba el límite efectivo del proceso en /proc/<pid>/limits, no el de tu shell: son distintos y ahí se esconden muchas horas perdidas.
Compresión: gzip, y por qué merece la pena añadir Brotli
Las configuraciones de arriba suben el nivel de gzip conforme hay más CPU disponible, que es el criterio correcto: comprimir cuesta ciclos. Pero hay un matiz importante, y es que subir el nivel tiene rendimientos decrecientes muy pronunciados. Entre el nivel 4 y el 9 la reducción de tamaño es de pocos puntos porcentuales mientras el consumo de CPU se multiplica. Para contenido dinámico, un nivel entre 4 y 6 es el punto óptimo en casi todos los casos.
La mejora real viene de dos sitios. El primero, Brotli: comprime entre un 15% y un 20% mejor que gzip en texto y todos los navegadores actuales lo soportan. Requiere compilar el módulo o instalar el paquete correspondiente, pero es la ganancia más barata que queda en esta capa. El segundo, precomprimir los estáticos en el momento del despliegue: si generas los .css.gz y .css.br al construir, Nginx los sirve directamente con gzip_static on y brotli_static on sin comprimir nada en caliente, con compresión máxima y coste cero de CPU en cada petición.
Dos cosas que no debes comprimir: lo que ya viene comprimido (JPEG, PNG, WebP, AVIF, MP4, ZIP, PDF) porque gastas CPU para no ganar bytes, y las respuestas muy pequeñas, para lo que existe gzip_min_length 256. La directiva gzip_disable "msie6" que aparece en los ejemplos es un resto histórico: ya no hay tráfico real de Internet Explorer 6, y puedes retirarla sin ningún efecto.
TLS: rendimiento y endurecimiento en la misma directiva
La configuración original ya hace lo fundamental —quedarse en TLS 1.2 y 1.3 y descartar SSLv3, TLS 1.0 y 1.1—, que sigue siendo la recomendación correcta. Lo que suele faltar es la parte que afecta al rendimiento:
ssl_protocols TLSv1.2 TLSv1.3;
ssl_prefer_server_ciphers off;
ssl_session_cache shared:SSL:20m;
ssl_session_timeout 1d;
ssl_session_tickets off;
ssl_stapling on;
ssl_stapling_verify on;
resolver 1.1.1.1 8.8.8.8 valid=300s;
add_header Strict-Transport-Security "max-age=31536000; includeSubDomains" always;
La ssl_session_cache compartida es la directiva con más impacto de este bloque: permite reanudar sesiones TLS sin repetir el handshake completo, y en un sitio con visitantes recurrentes ahorra una cantidad notable de CPU y de latencia. Con TLS 1.3 conviene dejar ssl_prefer_server_ciphers off y confiar en la negociación del cliente. El OCSP stapling evita que el navegador tenga que consultar por su cuenta el estado del certificado, lo que recorta cientos de milisegundos en la primera visita, pero necesita un resolver declarado o falla en silencio.
Si el servidor aloja un ecommerce o maneja datos personales, esta configuración es el mínimo, no el objetivo: conviene contrastarla con una auditoría de seguridad que revise también la capa de aplicación. En el caso de WordPress, nuestra guía de seguridad de WordPress para empresas cubre lo que queda por encima del servidor web.
Protección frente a abuso: limitar antes de escalar
Un servidor bien dimensionado se cae igual si un bot decide recorrerle el catálogo entero a veinte peticiones por segundo. Los módulos limit_req y limit_conn son la defensa más barata y eficaz, y se configuran en cuatro líneas:
limit_req_zone $binary_remote_addr zone=general:10m rate=10r/s;
limit_req_zone $binary_remote_addr zone=login:10m rate=3r/m;
limit_conn_zone $binary_remote_addr zone=porip:10m;

server {
    limit_req zone=general burst=20 nodelay;
    limit_conn porip 20;

    location = /wp-login.php {
        limit_req zone=login burst=2 nodelay;
        fastcgi_pass unix:/run/php/php8.3-fpm.sock;
        include fastcgi_params;
    }
}
El burst es lo que hace esto usable: permite ráfagas cortas por encima del límite —una página que carga varios recursos a la vez— sin penalizar al visitante legítimo, mientras corta el tráfico sostenido y anómalo. La zona específica para el formulario de acceso, con un límite mucho más agresivo, frena los ataques de fuerza bruta antes de que lleguen a PHP, que es donde de verdad cuestan recursos. Los mismos criterios aplicados a servicios HTTP los desarrollamos en el artículo sobre seguridad en APIs REST, autenticación y rate limiting.
Observabilidad: medir antes y después de cada cambio
Sin datos, optimizar es superstición. Lo mínimo imprescindible son dos cosas: el estado interno de Nginx y unos logs que registren tiempos.
log_format tiempos '$remote_addr - $status "$request" '
                   'req=$request_time upstream=$upstream_response_time '
                   'cache=$upstream_cache_status bytes=$body_bytes_sent';

access_log /var/log/nginx/access.log tiempos;

server {
    location = /nginx_status {
        stub_status;
        allow 127.0.0.1;
        deny all;
    }
}
La pareja $request_time y $upstream_response_time es el diagnóstico más útil que existe en esta capa. Si la primera es mucho mayor que la segunda, el cuello de botella está en la red o en el propio Nginx —buffers pequeños, cliente lento, compresión excesiva—. Si van casi iguales y ambas son altas, el problema es la aplicación o la base de datos, y ningún parámetro de nginx.conf lo va a arreglar. Esa distinción ahorra días de trabajo en la dirección equivocada.
El campo $upstream_cache_status te permite calcular el ratio de acierto de la caché con un simple recuento sobre el log. Si está por debajo del 70% en un sitio de contenido, revisa las exclusiones: casi siempre hay una cookie o un parámetro de query string que está saltándose la caché en todas las visitas.
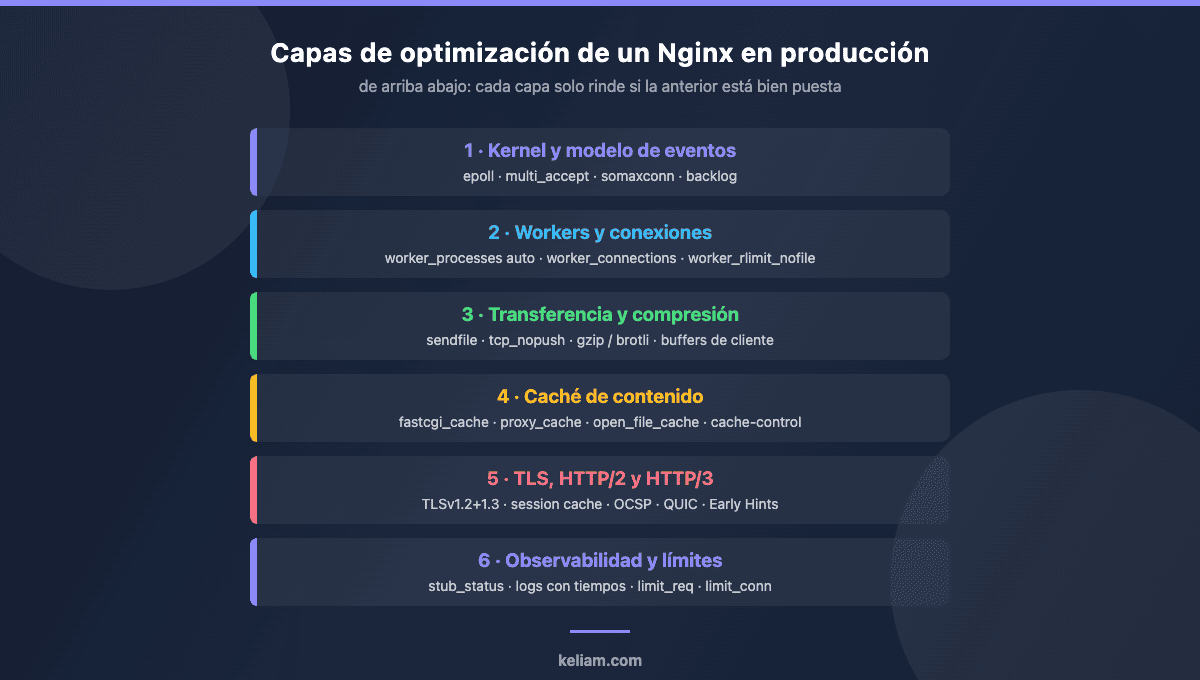
Errores frecuentes al optimizar Nginx
Estos son los que repetimos más a menudo en auditorías de servidores dedicados, por orden de frecuencia.
- Subir
worker_connectionssin subirworker_rlimit_nofile. El límite efectivo lo pone el sistema, no Nginx. Aparecen errores de «too many open files» en el log de error justo cuando llega el pico de tráfico. - Confundir
worker_processescon más potencia. Nginx es asíncrono: más procesos que núcleos no da más capacidad, solo más cambios de contexto.autoes la respuesta correcta en el 95% de los casos. - Declarar la caché y no activarla. Un
fastcgi_cache_pathsin sufastcgi_cacheen ellocationcorrespondiente no cachea nada. Se detecta en un segundo concurl -Imirando la cabecera de estado de caché. - Cachear contenido de sesión. El fallo opuesto y más grave: servir a un visitante el carrito o el panel de otro. Las exclusiones por cookie no son opcionales.
- Timeouts altos «por si acaso». Un
keepalive_timeoutde 300 segundos en un servidor de 1 GB de RAM mantiene miles de conexiones ociosas ocupando memoria. Los valores de los tres escenarios de arriba (15s, 30s, 65s) están escalados a propósito. - Activar HTTP/3 sin abrir UDP/443. El navegador reintenta por HTTP/2 y todo «funciona», así que el fallo pasa inadvertido durante meses mientras crees que tienes QUIC.
- Recargar con
restarten lugar dereload.nginx -t && systemctl reload nginxaplica la configuración sin cortar las conexiones en curso. Unrestartlas tira todas, y en hora punta se nota. - Tocar diez parámetros a la vez. Si algo mejora o empeora, no sabrás cuál fue. Un cambio, una medición, un registro de lo que hiciste.
Checklist de revisión de un Nginx en producción
- Versión en la rama stable vigente y actualizada (hoy la serie 1.30.x), con los parches de HTTP/3 aplicados si usas QUIC.
worker_processes autoyworker_connectionsacorde a la RAM disponible.worker_rlimit_nofiley los límites del sistema por encima deworker_connections.- Bloques
upstreamrevisados tras actualizar a 1.30, por el cambio de keepalive por defecto. sendfile,tcp_nopushytcp_nodelayactivados.- Compresión con nivel moderado,
gzip_min_lengthy, si es posible, Brotli y estáticos precomprimidos. - Caché FastCGI o proxy activa, con exclusiones por cookie y cabecera de diagnóstico.
expireslargos eimmutableen estáticos, conaccess_log off.- TLS 1.2 y 1.3 solamente, con
ssl_session_cachecompartida y OCSP stapling conresolver. limit_reqgeneral y una zona más estricta para formularios de acceso.stub_statusrestringido a localhost y logs con$request_timey$upstream_response_time.- Copia de
nginx.confversionada antes de cada cambio, ynginx -tantes de cada recarga.
Conclusión
Optimizar Nginx en un servidor dedicado no consiste en copiar una configuración «definitiva», sino en ajustar cada capa a los recursos reales de la máquina y al comportamiento concreto de la aplicación que sirve. Los tres escenarios de esta guía siguen siendo un punto de partida sólido para 1, 2 y 4 núcleos, y la lógica que los ordena —conexiones, buffers y caché escalando con la RAM disponible— se extrapola sin problema a máquinas mayores.
Lo que sí ha cambiado con la rama 1.30 merece una revisión deliberada: el keepalive hacia los backends activado por defecto altera el comportamiento de configuraciones existentes al actualizar, y funcionalidades como Early Hints, las sesiones persistentes en upstreams o HTTP/2 hacia el backend resuelven de serie problemas que antes obligaban a apaños. Y por encima de todo, el orden de trabajo: medir, cambiar una cosa, volver a medir. La mayor parte de las mejoras espectaculares que hemos visto en producción no vinieron de un parámetro exótico, sino de activar correctamente una caché que ya estaba declarada y de descubrir, mirando los tiempos del log, que el cuello de botella nunca estuvo en el servidor web. Si vas a pasar de aquí a la capa de PHP, la continuación natural es la guía de optimización de PHP-FPM.
¿Tu servidor va justo y no sabes por dónde empezar?
En Keliam revisamos la configuración de Nginx, PHP-FPM y caché de tu servidor dedicado, medimos antes y después, y dejamos documentado cada cambio. Sin tocar nada a ciegas.
- Auditoría Técnica Web — análisis de rendimiento, configuración y cuellos de botella
- Mantenimiento de software — actualizaciones y parches de seguridad al día
- Servicios IT — administración de servidores e infraestructura