Durante año y medio, el protocolo MCP (Model Context Protocol) ha pasado de ser una especificación curiosa publicada por Anthropic a finales de 2024 a convertirse en la capa estándar por la que los modelos de lenguaje hablan con el software de tu empresa. Si en 2025 la conversación en los comités de arquitectura era «¿deberíamos mirar MCP?», en 2026 la pregunta ya es otra: «¿cómo lo desplegamos sin que se nos convierta en un agujero de seguridad y en una factura de infraestructura?».
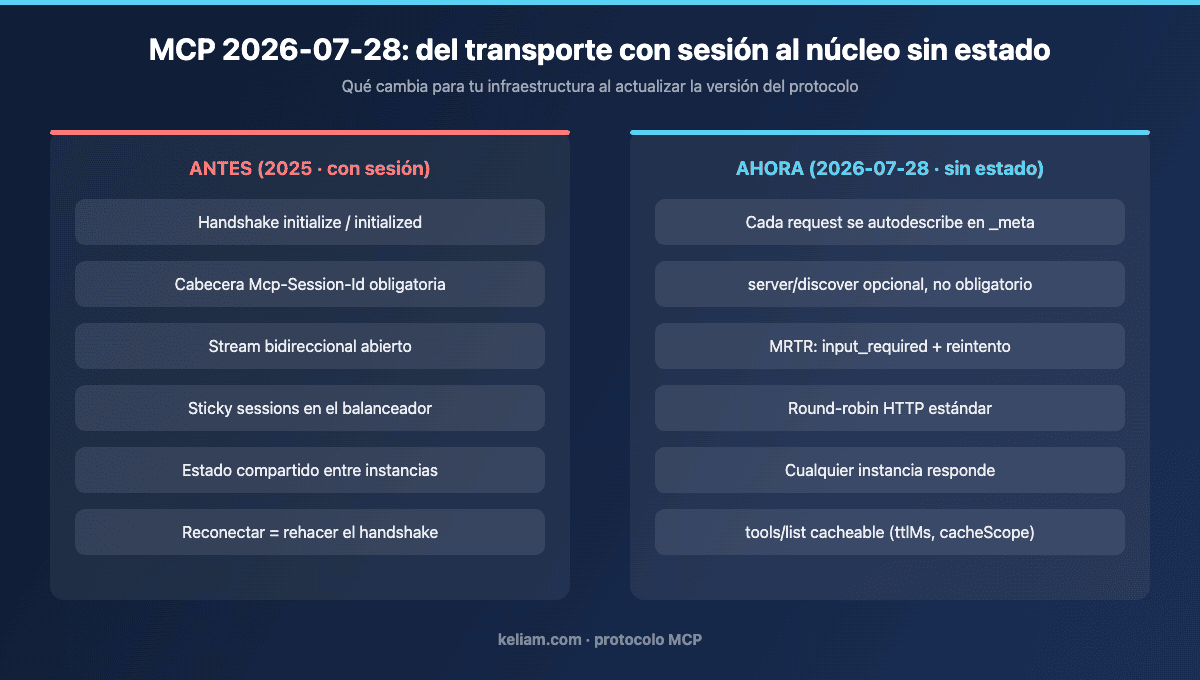
El 28 de julio de 2026 se publicó la nueva versión de la especificación, 2026-07-28, y no es una actualización cosmética. Es la revisión más profunda desde que existe el MCP remoto: el protocolo deja de tener sesiones. Desaparece el handshake de initialize, desaparece la cabecera Mcp-Session-Id y desaparece la necesidad de mantener streams bidireccionales abiertos. A cambio, un servidor MCP pasa a comportarse como cualquier otro workload HTTP: escalable en horizontal, cacheable, enrutable por cabeceras y desplegable detrás de un balanceador de toda la vida.
Para un CTO o un IT manager esto tiene una lectura muy concreta. Lo que hasta ahora obligaba a montar infraestructura especial —sticky sessions, almacenamiento compartido de estado, conexiones persistentes que se caen y hay que rehacer— pasa a ser innecesario. Y al mismo tiempo, la especificación endurece la parte de autorización, que es exactamente donde los equipos se dejan la mayor parte del tiempo de integración y donde más incidentes se acumulan.
En esta guía vamos a ver qué es MCP en términos de arquitectura, qué cambia de verdad con la versión 2026-07-28, qué se deprecia y con cuánto margen, cómo encaja en un ecosistema empresarial que ya tiene APIs, ERP, CRM y automatizaciones, y qué controles hay que poner antes de abrir un servidor MCP a un agente. Sin humo y con criterio de ingeniería.
1. Qué es MCP y qué problema resuelve de verdad
MCP es un protocolo abierto que estandariza cómo una aplicación de IA (el cliente) descubre y usa capacidades que expone otro sistema (el servidor). Nada más, y nada menos. No es un framework de agentes, no es un orquestador y no sustituye a tu API: es la capa de contrato entre el modelo y el mundo exterior.
1.1 El problema NxM de las integraciones
Antes de MCP, cada asistente tenía su propio formato de function calling y cada herramienta tenía que implementarlo tantas veces como clientes quisiera soportar. Con N clientes de IA y M sistemas internos, acababas con N×M integraciones a medida, cada una con su autenticación, su formato de esquema y su ciclo de mantenimiento. Cualquiera que haya gestionado un parque de integraciones API entre ecommerce, ERP y logística reconoce el patrón: funciona hasta que hay que cambiar algo.
MCP reduce eso a N+M. Escribes un servidor MCP para tu CRM y cualquier cliente compatible —Claude, un IDE, un agente propio construido con el Agent SDK, una plataforma corporativa— puede consumirlo sin trabajo adicional. El valor no está en la novedad técnica, está en que todos los grandes proveedores lo han adoptado, lo que convierte al protocolo en un punto de Schelling: la integración que escribes hoy sigue sirviendo cuando cambies de modelo o de proveedor.
1.2 Los tres primitivos que tienes que entender
Un servidor MCP expone tres tipos de cosas, y la diferencia importa a la hora de diseñar:
- Tools: acciones que el modelo puede invocar. Tienen efectos y, por tanto, requieren control de permisos, trazabilidad y, en muchos casos, confirmación humana. Crear un pedido, lanzar un despliegue, enviar un correo.
- Resources: datos que el cliente puede leer y adjuntar al contexto. Un documento, el contenido de una tabla, un fichero de configuración. Son de lectura y se identifican por URI.
- Prompts: plantillas parametrizadas que el servidor ofrece al usuario como flujos predefinidos. La parte menos usada y, sin embargo, la que mejor encapsula el conocimiento de negocio.
El error más común que vemos en implantaciones es meterlo todo en tools. Si un dato es de solo lectura y voluminoso, va como recurso cacheable; si es una acción con efectos, va como herramienta con su política de autorización. Mezclarlo convierte el catálogo en una lista interminable que el modelo no sabe usar y que el equipo de seguridad no sabe auditar.
2. La versión 2026-07-28: MCP deja de tener sesiones
Este es el cambio grande. Hasta ahora, MCP era un protocolo con estado: cliente y servidor negociaban capacidades con un intercambio initialize/initialized, el servidor devolvía un identificador de sesión en la cabecera Mcp-Session-Id y todo lo que venía después dependía de esa sesión. En un portátil, con un servidor local, eso es irrelevante. En producción, con miles de peticiones y varias réplicas, obligaba a que todas las peticiones de un cliente cayeran en la misma instancia o a compartir estado entre ellas.
2.1 Adiós al handshake y al identificador de sesión
La nueva especificación retira el intercambio de inicialización y la cabecera de sesión. Cada petición viaja sola y se autodescribe: lleva su versión de protocolo, la identidad del cliente y sus capacidades dentro del campo _meta. Para los clientes que quieran conocer las capacidades del servidor antes de actuar existe una nueva llamada server/discover, pero es opcional.
POST /mcp HTTP/1.1
MCP-Protocol-Version: 2026-07-28
Mcp-Method: tools/call
Mcp-Name: search

{"jsonrpc":"2.0","id":1,"method":"tools/call",
 "params":{"name":"search","arguments":{"q":"pedidos abiertos"},
 "_meta":{"io.modelcontextprotocol/clientInfo":{"name":"mi-app","version":"1.0"}}}}
La consecuencia práctica: cualquier petición puede aterrizar en cualquier instancia detrás de un round-robin normal, sin almacenamiento compartido. Se acabaron las sticky sessions y los despliegues que rompen conversaciones a medias.
Ojo con un matiz que los equipos confunden: que el transporte sea sin estado no obliga a que tu aplicación lo sea. Si necesitas arrastrar estado entre llamadas, el patrón recomendado es emitir un identificador explícito desde una herramienta y hacer que el modelo lo pase como argumento en las siguientes. Funciona mejor que el estado oculto en el transporte, precisamente porque el modelo ve el identificador y puede encadenarlo entre herramientas.
2.2 Multi Round-Trip Requests (MRTR)
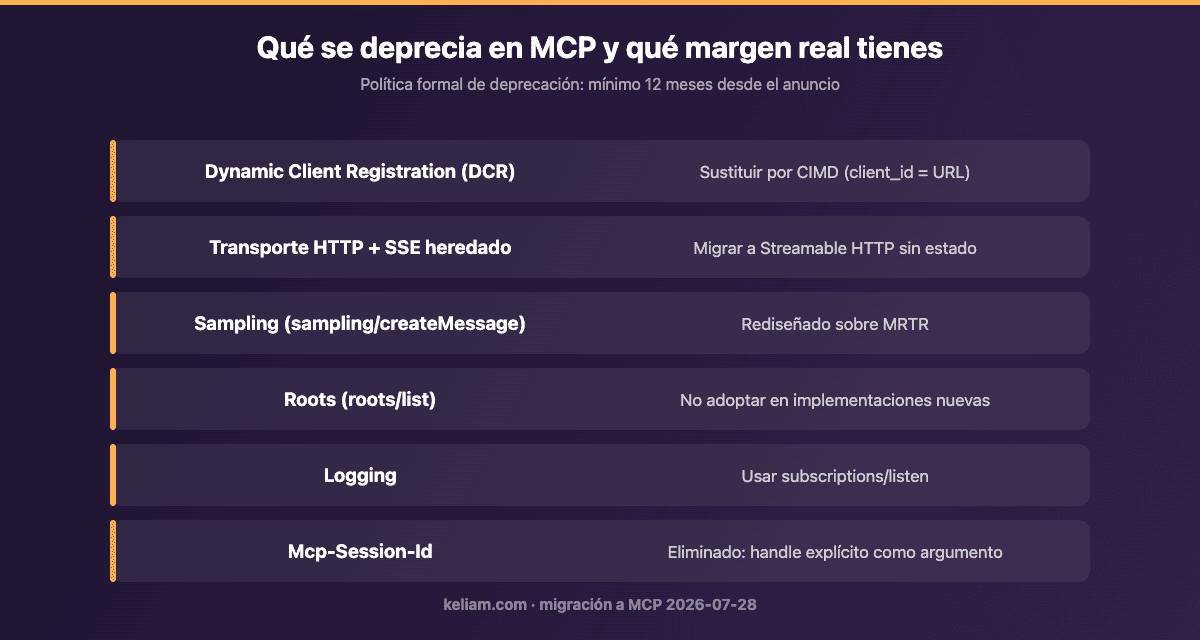
Si el servidor ya no puede iniciar peticiones hacia el cliente por un canal abierto, ¿cómo pide una confirmación a mitad de una operación? Ahí entra MRTR, que sustituye a las antiguas elicitation/create, sampling/createMessage y roots/list.
El mecanismo es sencillo y muy HTTP: el servidor responde con resultType: "input_required" y adjunta lo que necesita saber; el cliente resuelve esas peticiones —preguntando al usuario, típicamente— y reintenta la llamada original añadiendo las respuestas en inputResponses. Sin streams colgados, sin timeouts raros y con un punto natural donde insertar el control humano: «vas a borrar 4.000 registros, ¿confirmas?».
2.3 Enrutado por cabeceras y listas cacheables
Dos cambios pequeños con impacto operativo grande. El primero: las peticiones sobre Streamable HTTP deben incluir ahora las cabeceras Mcp-Method y Mcp-Name. Tu gateway, tu rate limiter o tu WAF pueden enrutar, medir y autorizar mirando cabeceras, sin abrir el cuerpo JSON. Eso permite, por ejemplo, aplicar un límite distinto a tools/call sobre una herramienta de escritura que a un resources/read.
El segundo: las respuestas de tools/list, prompts/list, resources/list y resources/read llevan pistas de caché (ttlMs y cacheScope) y orden determinista. Además de ahorrar peticiones, esto estabiliza el prompt caching aguas arriba: si el catálogo de herramientas se serializa siempre igual, el prefijo del contexto no cambia y el coste por token cae. Es una de esas optimizaciones que no se ven en la demo y sí en la factura.
3. Autorización: donde se va el 80% del tiempo de integración
Los propios mantenedores del protocolo lo dicen sin rodeos: hablando con implementadores durante un año, la autorización es donde se concentra la mayor parte del esfuerzo. La versión 2026-07-28 recoge ese aprendizaje y endurece varias cosas.
3.1 Validación del issuer (RFC 9207)
Los servidores de autorización deben devolver el parámetro iss según la RFC 9207, y los clientes están obligados a validarlo antes de canjear el código. Esto cierra el agujero clásico de authorization server mix-up: un atacante que consigue que tu cliente canjee un código emitido por un servidor distinto del esperado. Si tu equipo ha implementado OAuth alguna vez con varios proveedores, sabe que este fallo es sutil y caro.
3.2 De DCR a CIMD
El Dynamic Client Registration queda formalmente deprecado en favor de los Client ID Metadata Documents (CIMD). La idea es elegante: en lugar de registrar el cliente contra cada servidor de autorización y recibir un client_id opaco, el client_id es una URL HTTPS estable bajo tu control que sirve un documento JSON con los metadatos del cliente. El servidor de autorización lo descarga cuando lo necesita.
Ventaja para una empresa: dejas de tener registros duplicados y huérfanos repartidos por cada proveedor, y pasas a tener una identidad de cliente versionada, auditable y revocable desde un único sitio. DCR sigue funcionando por compatibilidad, pero desaparecerá en una versión futura; si estás empezando ahora, empieza directamente con CIMD.
Como medida de endurecimiento adicional, los clientes fijan application_type durante el registro para que los servidores de autorización dejen de rechazar redirecciones a localhost en aplicaciones de escritorio y CLI —el famoso error de redirect_uri que ha hecho perder tardes enteras—, y las credenciales de cliente quedan vinculadas al emisor que las creó: no se pueden reutilizar entre servidores de autorización distintos.
3.3 Autorización gestionada por la empresa
Junto a los cambios del núcleo, la extensión de Enterprise Managed Authorization aterriza la parte que faltaba: que sea la organización, y no cada usuario final, quien decida qué servidores MCP se pueden usar, con qué identidad y con qué alcance. Es el equivalente a lo que ya haces con SSO y aprovisionamiento en el resto del stack. Si tu política de acceso a APIs internas es seria —y si no lo es, conviene revisarla junto a las buenas prácticas de seguridad en APIs REST—, MCP no debería ser la excepción.
¿Vas a exponer tus sistemas a agentes de IA? Hazlo con una arquitectura revisada
En Keliam diseñamos e implantamos servidores MCP sobre ERP, CRM y plataformas a medida, y auditamos la capa de autorización antes de que un agente toque datos de producción.
4. Extensiones: Tasks, MCP Apps y el fin de lo «experimental»
Otra novedad estructural: la especificación formaliza un marco de extensiones. En lugar de meter cada idea nueva en el núcleo y arrastrarla para siempre, las capacidades se publican como extensiones identificadas por espacio de nombres. El núcleo se mantiene pequeño y estable; la innovación ocurre alrededor.
4.1 Tasks: trabajo largo sin conexiones colgadas
Tasks sale del núcleo experimental y pasa a ser la extensión io.modelcontextprotocol/tasks, con un tasks/get basado en sondeo y un nuevo tasks/update. Es la respuesta al escenario más común en empresa: la herramienta que el agente invoca no responde en dos segundos, sino en dos minutos —una migración, un informe pesado, un proceso batch contra el ERP—. Con Tasks, la llamada devuelve un identificador y el cliente consulta el progreso, en vez de mantener una conexión abierta rezando por que no la corte el balanceador.
Las notificaciones de cambio se unifican además en un único stream subscriptions/listen al que el cliente se suscribe por tipo de notificación, en lugar del antiguo endpoint HTTP GET.
4.2 MCP Apps: interfaz, no solo texto
MCP Apps permite que un servidor devuelva interfaz —un formulario, una tabla interactiva, una vista— en lugar de obligar a que todo pase por texto plano. Para casos de uso internos es más relevante de lo que parece: un aprobador que tiene que validar quince líneas de pedido no quiere leerlas en un párrafo, quiere una tabla con casillas. Es la misma lógica que aplicamos cuando montamos dashboards a medida frente a herramientas genéricas: la interfaz correcta reduce errores humanos.
5. Qué se deprecia y cuánto margen real tienes
La versión 2026-07-28 introduce algo que se echaba de menos en un protocolo que se mueve tan rápido: una política formal de deprecación con una ventana mínima de doce meses. Puedes planificar la actualización en vez de reaccionar a ella.
Lo que queda marcado como deprecado: Roots, Sampling y Logging siguen funcionando y lo harán al menos un año más, pero las implementaciones nuevas no deberían adoptarlos. El transporte heredado HTTP+SSE también queda oficialmente deprecado con la misma ventana de salida. Y Dynamic Client Registration, como decíamos, cede el sitio a CIMD.
Los cuatro SDK de primer nivel —TypeScript, Python, Go y C#— hablan ya la nueva versión, y el SDK de Rust la soporta en beta. Hay coste de migración real, sobre todo si tu implementación dependía de identificadores de sesión, pero las notas de migración están publicadas y el trabajo es acotado.
6. Cómo encaja MCP en una arquitectura de empresa
6.1 MCP no sustituye a tu API: la envuelve
El primer malentendido que conviene desactivar: un servidor MCP no es una API nueva. Es una fachada orientada a modelos sobre capacidades que normalmente ya existen. Tu API REST sigue siendo el sistema de registro; el servidor MCP traduce ese contrato a algo que un modelo pueda descubrir y usar con seguridad.
Eso implica decisiones de diseño distintas a las de una API para humanos o para otro servicio. Los nombres de herramienta tienen que ser autoexplicativos, las descripciones son parte del contrato (el modelo las lee para decidir), los esquemas de entrada deben ser restrictivos y los mensajes de error tienen que ser accionables: «falta el campo cliente_id» en vez de un 400 sin cuerpo. Un catálogo de veinte herramientas bien nombradas rinde mejor que uno de cien mal descritas.
6.2 Gateway, observabilidad y control de coste
En cuanto pasas de un piloto a producción aparecen tres necesidades que conviene resolver desde el principio:
- Un punto único de entrada. Un gateway MCP delante de tus servidores centraliza identidad, políticas y cuotas. Con el enrutado por cabeceras de la nueva versión esto es mucho más sencillo de implementar que antes.
- Trazabilidad de extremo a extremo. Cada llamada a herramienta debería quedar registrada con quién la originó, con qué argumentos y qué devolvió. Sin eso, la primera pregunta de auditoría —»¿quién modificó este registro?»— no tiene respuesta. Aquí aplican los mismos principios que en cualquier estrategia de integración entre APIs y bases de datos.
- Control de coste. Cada herramienta ocupa tokens en el contexto. Un catálogo enorme cargado en cada conversación se paga en cada mensaje. Las listas cacheables ayudan, pero la decisión de qué exponer a qué agente sigue siendo de arquitectura, no de infraestructura.
6.3 MCP frente a n8n, iPaaS y automatización clásica
Nos preguntan mucho si MCP sustituye a las herramientas de automatización. La respuesta corta es no: resuelven problemas distintos y se complementan bien.
Una plataforma como n8n ejecuta flujos deterministas: cuando entra un pedido, haz A, luego B, luego C. Es lo que quieres para procesos críticos, repetitivos y auditables. MCP habilita lo no determinista: un agente que decide qué herramienta usar según el contexto de una consulta que no habías previsto. En la práctica, muchas arquitecturas acaban usando ambos: los flujos de negocio estables viven en automatizaciones que sincronizan CRM y ERP, y el agente con MCP se reserva para la capa de consulta, diagnóstico y acciones asistidas.
La regla que aplicamos con clientes: si puedes dibujar el diagrama de flujo completo, no necesitas un agente. Si el diagrama tiene una caja que pone «depende», ahí es donde MCP aporta.
7. Riesgos y controles antes de abrir un servidor MCP
Un servidor MCP es una superficie de ataque nueva, y conviene tratarla como tal. Los vectores que vemos con más frecuencia:
7.1 Inyección de prompts a través de datos
Si una herramienta devuelve contenido que procede de terceros —el cuerpo de un correo, una descripción de producto, un ticket de soporte—, ese contenido puede contener instrucciones dirigidas al modelo. El principio operativo es simple y no negociable: todo lo que devuelve una herramienta es dato, no instrucción. Las acciones con efectos deben requerir confirmación explícita, y MRTR ofrece precisamente el punto donde insertarla.
7.2 Permisos demasiado amplios
El patrón «le damos al agente un usuario administrador y ya afinaremos» es la causa raíz de casi todos los incidentes que hemos visto. Cada servidor MCP debe correr con la identidad mínima necesaria, idealmente distinta por caso de uso, y con permisos de escritura separados de los de lectura. Es el mismo principio de mínimo privilegio que exigen marcos como el ENS o la ISO 27001, aplicado a un consumidor nuevo.
7.3 Servidores de terceros sin revisar
Hay miles de servidores MCP públicos y la mayoría no han pasado ninguna revisión de seguridad. Instalar uno equivale a dar acceso a un binario de origen desconocido a tus credenciales. Para datos sensibles, la recomendación es clara: servidor propio, transporte cifrado, permisos por rol y revisión del código. Para servidores de terceros, aislamiento y credenciales de alcance limitado.
7.4 Falta de límites de tasa
Un agente en bucle puede generar miles de llamadas en minutos. Sin límites por herramienta y por identidad, un fallo de razonamiento se convierte en una incidencia de disponibilidad. Las cabeceras Mcp-Method y Mcp-Name permiten aplicar cuotas granulares sin inspeccionar el cuerpo de cada petición.
8. Plan de adopción realista en 90 días
Para una empresa mediana con sistemas propios, el camino que mejor nos ha funcionado es este:
Semanas 1-3. Inventario y caso de uso único. Elegir un proceso con dolor real y riesgo bajo: consultas al CRM, búsqueda en documentación interna, diagnóstico de incidencias. Nada de escritura en producción todavía. Definir qué datos entran en juego y quién puede verlos.
Semanas 4-6. Servidor MCP mínimo, de solo lectura. Cinco o seis herramientas bien nombradas sobre la API que ya tienes. Autenticación con CIMD desde el primer día. Registro de todas las llamadas. Medir: cuántas veces el modelo elige la herramienta correcta, cuánto contexto consume el catálogo.
Semanas 7-9. Escritura con confirmación. Añadir las primeras herramientas con efectos, todas ellas detrás de confirmación humana vía MRTR. Separar identidades de lectura y escritura. Definir límites de tasa por herramienta.
Semanas 10-13. Gateway, gobierno y ampliación. Poner el punto único de entrada, activar la autorización gestionada por la empresa, revisar la trazabilidad con el responsable de seguridad y solo entonces ampliar a un segundo caso de uso. En paralelo, revisar la deuda técnica que el piloto haya destapado: casi siempre aparece, y es mejor tratarla como parte del proyecto y no como sorpresa. Si el equipo interno no tiene ancho de banda, es un trabajo que encaja bien en un servicio de soporte y evolución continuada.
Conclusión
La especificación 2026-07-28 marca el momento en el que MCP deja de ser un protocolo de laboratorio y se convierte en infraestructura de producción. Al eliminar el estado del transporte, el protocolo se alinea con cómo funciona el resto de la web: peticiones independientes, cacheables, enrutables y escalables en horizontal. Y al endurecer la autorización y formalizar una política de deprecación de doce meses, da a los equipos algo que llevaban tiempo pidiendo: previsibilidad.
Para un responsable técnico, la decisión ya no es si adoptar MCP, sino con qué gobierno hacerlo. Nuestra recomendación es empezar pequeño y de solo lectura, tratar cada herramienta como una superficie de ataque, autenticar con CIMD desde el principio y no permitir ninguna acción con efectos sin confirmación humana explícita. El protocolo ya está maduro; lo que suele faltar es la arquitectura alrededor.
Preguntas frecuentes sobre el protocolo MCP
¿Tengo que migrar ya a la versión 2026-07-28?
Si tu implementación es reciente y no dependía de identificadores de sesión, la migración es asumible y merece la pena por el ahorro operativo. Si tienes servidores en producción sobre HTTP+SSE, tienes al menos doce meses de convivencia garantizados, pero conviene planificar la migración ahora en vez de dejarla para el final de la ventana.
¿MCP es seguro para datos confidenciales?
Puede serlo, con condiciones: servidor propio en lugar de público, permisos por rol, transporte cifrado, identidades separadas para lectura y escritura, confirmación humana en las acciones con efectos y registro completo de llamadas. Sin esos controles, no lo es.
¿Necesito MCP si ya uso n8n o una plataforma de automatización?
No son excluyentes. Los flujos deterministas siguen encajando mejor en una plataforma de automatización; MCP aporta cuando la decisión de qué hacer depende del contexto y no puede modelarse de antemano.
¿Cuánto cuesta montar un servidor MCP sobre nuestro ERP o CRM?
Depende sobre todo del estado de la API existente. Si el sistema ya expone una API documentada y con autenticación decente, un servidor de solo lectura con cinco o seis herramientas es cuestión de semanas. Si hay que construir la capa de acceso desde cero o el sistema es heredado, el grueso del esfuerzo está ahí y conviene empezar por una auditoría técnica antes de estimar.
¿Qué pasa si cambio de proveedor de modelo?
Ese es precisamente el argumento a favor de MCP. Al ser un estándar abierto adoptado por los principales proveedores, el servidor que escribes hoy sigue siendo válido si mañana cambias de modelo o combinas varios. La inversión está en la integración, no en el proveedor.