Hay dos formas de morir en el intento cuando se mete inteligencia artificial en una estrategia SEO. La primera es la más ruidosa: generar 800 artículos en un fin de semana, publicarlos con un cron y ver cómo Google desindexa medio dominio tres meses después. La segunda es más silenciosa y bastante más común: pagar suscripciones, montar prompts, publicar «contenido optimizado» durante un año y descubrir que el tráfico orgánico no se ha movido, que el equipo de marketing dedica más tiempo a corregir que a escribir y que los pocos clics que llegan no convierten.
Entre ambos extremos hay una zona en la que la IA aplicada al SEO sí funciona, y funciona muy bien: como acelerador de investigación, estructuración, redacción asistida y mantenimiento de contenido, dentro de un proceso con controles de calidad reales y con personas que responden del resultado. Esa zona es la que interesa a un CTO, a un responsable de marketing digital o a un founder que tiene que decidir dónde invierte presupuesto y qué riesgos asume con su dominio.
En esta guía repasamos qué dice Google en 2026 sobre el contenido generado con IA (y qué penaliza de verdad), cómo cambia el juego con AI Overviews y los buscadores conversacionales, qué flujo de trabajo usamos para producir contenido asistido que posiciona y convierte, qué piezas técnicas hay que montar para que ese flujo sea sostenible y qué métricas permiten saber si está funcionando o si hay que parar. Todo desde la óptica de una agencia de desarrollo que ha visto de cerca tanto proyectos que multiplicaron su tráfico como dominios que tuvieron que empezar de cero.
1. Qué dice Google sobre el contenido con IA (y qué penaliza de verdad)
Conviene empezar desmontando el malentendido más extendido: Google no penaliza el contenido por estar generado con IA. Su posición pública desde 2023 es que evalúa la calidad y la utilidad del contenido, no la herramienta con la que se ha producido. Lo que sí persigue, y con cada actualización lo hace de forma más agresiva, es el contenido creado a escala con el único objetivo de manipular el ranking.
1.1 Las políticas de spam que importan
Desde la actualización de marzo de 2024, la política de spam de Google incluye tres apartados que afectan directamente a cualquier programa de contenido con IA:
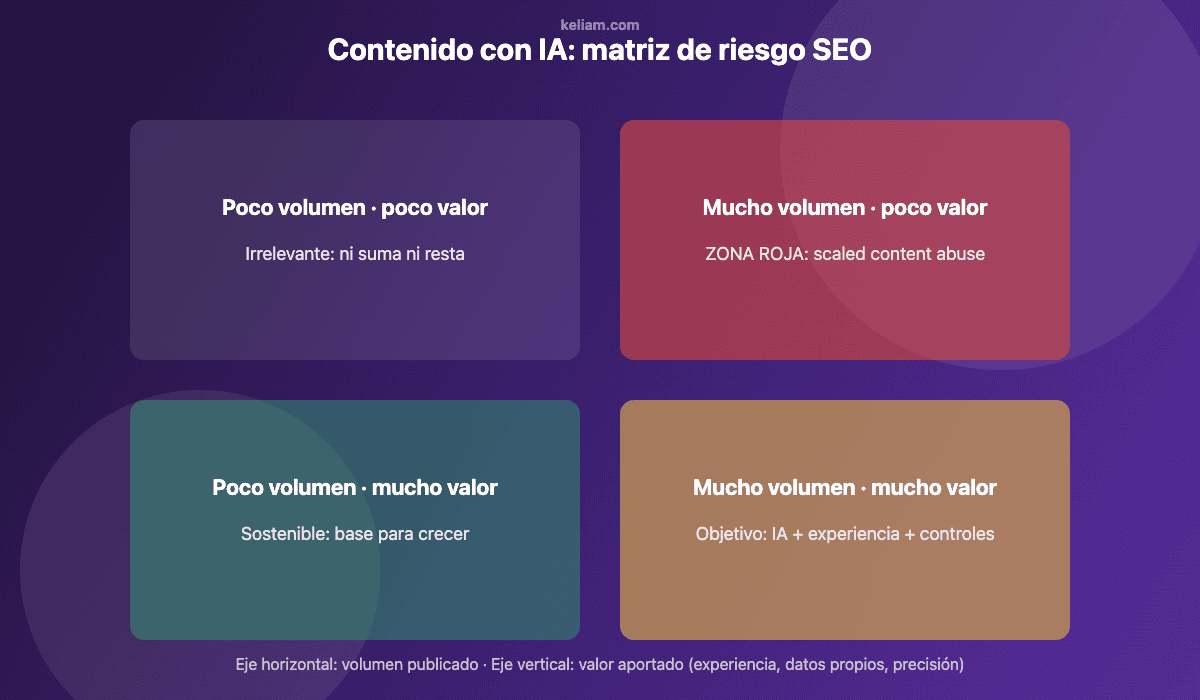
- Scaled content abuse (abuso de contenido a escala): producir muchas páginas con poco o ningún valor para el usuario, con independencia del método (IA, scraping, spinning o humanos mal pagados). Es la política que tumba los «blogs de 5.000 artículos en dos meses».
- Site reputation abuse (abuso de reputación del sitio): alojar contenido de terceros de baja calidad en un dominio con autoridad para aprovechar su reputación. Afecta a medios que subarriendan secciones, pero también a empresas que abren un subdirectorio de «guías» desconectado de su negocio.
- Expired domain abuse: comprar dominios caducados para rellenarlos de contenido y heredar su autoridad. Menos relevante para una empresa con dominio propio, pero explica por qué algunos «atajos» desaparecen de golpe.
Estas políticas se aplican tanto de forma algorítmica como mediante acciones manuales. Y ahí está el matiz que muchos equipos ignoran: una acción manual por scaled content abuse no se resuelve borrando artículos y esperando; requiere una solicitud de reconsideración, documentar lo que se ha corregido y, en la práctica, meses de recuperación.
1.2 Helpful content, E-E-A-T y el sistema de calidad
El antiguo «Helpful Content System» se integró en el algoritmo principal en 2024, lo que significa que la señal de «contenido útil frente a contenido hecho para el buscador» ya no es un sistema aparte que se activa periódicamente, sino una evaluación continua a nivel de sitio. Esto tiene una consecuencia práctica incómoda: una proporción alta de páginas flojas arrastra hacia abajo a las buenas. No sirve de nada tener 30 guías excelentes si conviven con 400 artículos vacíos generados en batch.
Por su parte, E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) no es un factor de ranking directo sino un marco que usan los evaluadores de calidad y que se refleja en muchas señales. La «E» de experiencia es precisamente lo que un modelo de lenguaje no puede aportar por sí solo: haber configurado el servidor, haber migrado esa tienda, haber sufrido ese incidente. Ahí es donde el contenido asistido por IA gana o pierde: si la experiencia real entra en el proceso, el resultado es diferencial; si no, es indistinguible de lo que cualquier competidor puede generar con el mismo prompt.
1.3 Lo que sí está permitido y bien visto
Google es explícito en que la automatización tiene usos legítimos en contenido: informes deportivos, datos meteorológicos, transcripciones, resúmenes de productos generados a partir de datos estructurados propios. Trasladado al mundo empresarial, es perfectamente válido usar IA para redactar fichas de producto a partir de atributos reales (algo que ya tratamos en nuestra guía sobre IA generativa para ecommerce), para generar variantes de meta descriptions, para traducir y localizar contenido revisado o para mantener actualizadas páginas de documentación técnica. La línea roja no está en la herramienta, sino en la intención y en el valor añadido.
2. El tablero ha cambiado: AI Overviews, AI Mode y buscadores conversacionales
Hasta 2024 la conversación sobre IA y SEO giraba en torno a «cómo genero contenido». En 2026 el problema es doble, porque el propio buscador se ha convertido en un generador de respuestas. Cualquier estrategia de contenido que ignore esto está optimizando para un tablero que ya no existe.
2.1 Menos clics, más selección
AI Overviews (los resúmenes generados por Google al principio de la página de resultados) y AI Mode (la experiencia conversacional completa) han reducido el CTR de las consultas informacionales de forma medible. Los estudios sectoriales publicados entre 2025 y 2026 coinciden en caídas de entre un 20 % y un 60 % de clics orgánicos en consultas donde aparece un resumen, con variaciones enormes según sector y tipo de consulta. Para una empresa B2B esto significa que el artículo genérico «qué es X» que antes traía tráfico residual ahora, en muchos casos, no trae nada: la respuesta la da Google directamente.
Lo que sí sigue trayendo clics son las consultas donde el usuario necesita profundidad, criterio o una acción: comparativas con matices, guías de implementación, casos reales, herramientas, precios, opiniones con experiencia. Justo el tipo de contenido que un modelo de lenguaje sin contexto propio produce peor.
2.2 Ser fuente citada: la nueva visibilidad
Los resúmenes de IA citan fuentes, y ser una de ellas se ha convertido en un objetivo en sí mismo. El sector lo ha bautizado con varias etiquetas (GEO, AEO, LLM optimization), pero la mecánica es más mundana de lo que sugieren los acrónimos: Google y los demás motores tienden a citar páginas que responden de forma clara y verificable a una pregunta concreta, que tienen datos estructurados coherentes, que están en dominios con señales de autoridad y que son accesibles y rápidas para el rastreo. Es decir, buen SEO técnico y buen contenido. Si la casa técnica no está en orden (Core Web Vitals, rastreo, indexación, canonicals), da igual cuánto se afine el texto; en nuestra guía de SEO técnico para ecommerce está la base sobre la que hay que construir.
2.3 Consecuencia estratégica
Producir mucho contenido informacional de nivel introductorio con IA es hoy la peor inversión posible: compite en el segmento donde el buscador ya responde solo, no aporta nada que no tengan los demás y suma páginas de bajo valor que diluyen la calidad del dominio. El movimiento inteligente es el contrario: menos piezas, más profundas, con experiencia propia, y usar la IA para producirlas más rápido y mantenerlas actualizadas.
3. Dónde la IA aporta valor real en un flujo SEO
Con el marco claro, vayamos a lo concreto. En los proyectos en los que hemos integrado IA en el proceso de contenido, el valor no ha estado en «que escriba el artículo», sino en una docena de tareas intermedias que antes consumían horas y que un modelo resuelve en minutos con supervisión.
3.1 Investigación y clustering de keywords
Exportar 5.000 consultas de Search Console o de una herramienta de keywords y agruparlas por intención era un trabajo de días. Un modelo puede clasificar cada consulta por intención (informacional, comercial, transaccional, navegacional), agruparlas en clusters temáticos y proponer una página objetivo por cluster en una tarde. No sustituye el criterio humano sobre qué clusters merecen inversión, pero elimina el 80 % del trabajo mecánico. Con embeddings (vectores semánticos) el agrupamiento es incluso más fiable que con un LLM generalista, y se puede automatizar en un pipeline.
3.2 Análisis de SERP y de la competencia
Para cada keyword objetivo, un flujo automatizado puede rastrear los diez primeros resultados, extraer su estructura de encabezados, longitud, entidades mencionadas y preguntas que responden, y sintetizar qué cubre la competencia y qué falta. Ese «content gap» es el input más valioso para un brief, y hacerlo a mano para 50 keywords es inasumible.
3.3 Briefs y estructura
El brief es donde se decide la calidad del artículo. Un buen brief generado con IA a partir del análisis anterior incluye la intención de búsqueda, la estructura de H2/H3 propuesta, las preguntas que hay que responder, las entidades y términos relacionados que conviene cubrir, los enlaces internos candidatos y, sobre todo, los huecos donde el autor tiene que aportar experiencia propia. Ese brief lo revisa una persona con criterio antes de redactar nada.
3.4 Redacción asistida (no redacción automática)
Aquí está la diferencia entre un programa que funciona y uno que no. La redacción asistida parte de un brief revisado, de fuentes propias (documentación interna, notas de proyecto, transcripciones de entrevistas con el experto, datos de la empresa) y de un modelo con instrucciones muy concretas sobre tono, audiencia y lo que no debe inventar. El borrador se revisa, se corrige y se enriquece con ejemplos reales. Las técnicas de prompting para conseguir borradores útiles y consistentes las detallamos en nuestro artículo sobre prompt engineering para desarrolladores, y son perfectamente trasladables a contenido.
3.5 Optimización on-page y metadatos
Titles, meta descriptions, alt de imágenes, FAQs derivadas del contenido, resúmenes para redes: tareas de bajo riesgo y alto volumen donde la IA ahorra muchísimo tiempo y rara vez rompe nada, siempre que se validen longitudes y se evite el relleno de keywords.
3.6 Refresco de contenido antiguo
Probablemente el uso con mejor retorno y el más infrautilizado. Un blog corporativo de cinco años acumula cientos de artículos con datos obsoletos, versiones de software caducadas y enlaces rotos. Un flujo que detecte esas páginas (caída de posiciones, fechas antiguas, menciones a versiones viejas), proponga las actualizaciones necesarias y las someta a revisión permite rescatar tráfico existente a un coste muy inferior al de crear contenido nuevo.
3.7 Enlazado interno
Sugerir enlaces internos relevantes para cada artículo nuevo y, a la inversa, identificar artículos antiguos desde los que enlazar al nuevo, es una tarea semántica ideal para embeddings. Es una de las palancas SEO con mejor relación esfuerzo/resultado y la que más se abandona cuando se hace a mano.
4. Un flujo de trabajo que funciona: de la keyword a la publicación
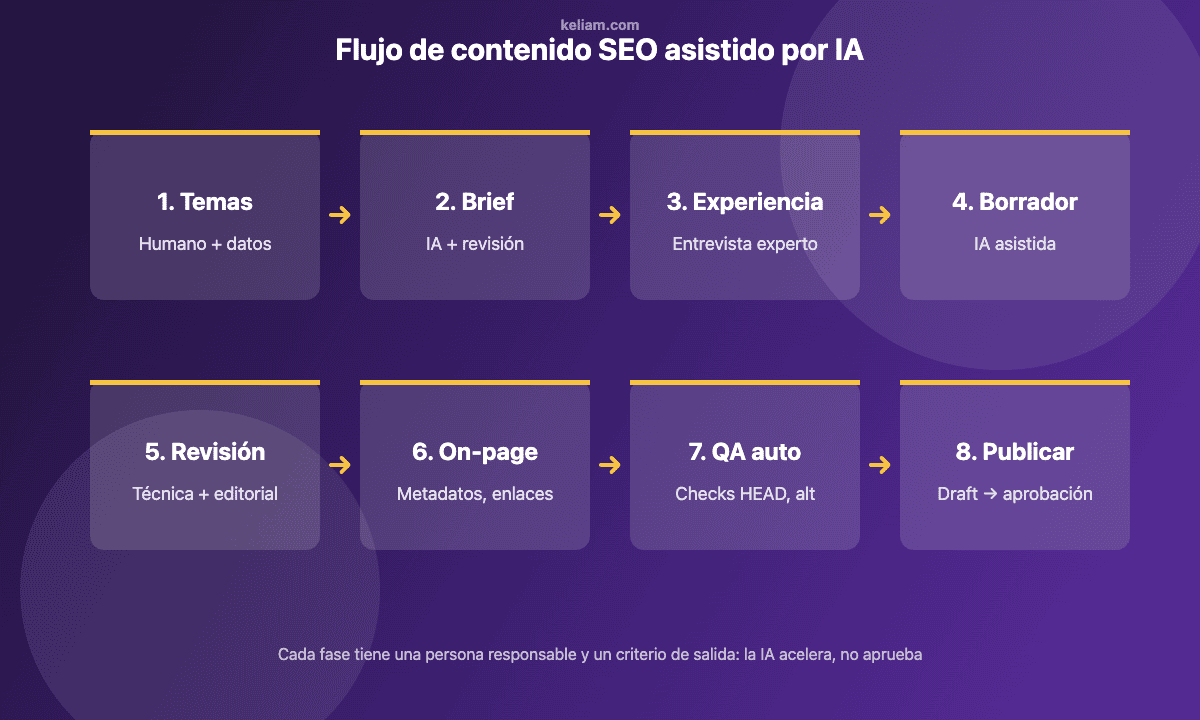
Este es, simplificado, el proceso que recomendamos y que usamos en proyectos de contenido asistido. Cada fase tiene una responsable humana y un criterio de salida; la IA acelera, pero no aprueba.
- Selección de temas (humano + datos): a partir del clustering, se eligen los temas con intención comercial o de implementación donde la empresa tiene experiencia real. Regla práctica: si nadie del equipo puede aportar un ejemplo propio sobre el tema, no se escribe.
- Brief automatizado y revisado: análisis de SERP, estructura propuesta, preguntas, entidades, enlaces internos. Revisión de 15 minutos por una persona con criterio SEO.
- Captura de experiencia: 20-30 minutos de entrevista (o notas escritas) con el técnico o responsable que conoce el tema. Esta transcripción es la materia prima que diferencia el artículo. Sin este paso, el resultado es genérico.
- Borrador asistido: el modelo redacta a partir de brief + transcripción + guía de estilo, con instrucción explícita de no inventar datos, cifras ni fuentes y de marcar con un placeholder cualquier afirmación que necesite verificación.
- Revisión editorial y técnica: el autor revisa hechos, elimina relleno, añade matices y ejemplos, comprueba que cada afirmación técnica es correcta. Aquí es donde se detectan las «alucinaciones»: versiones de software inexistentes, funcionalidades inventadas, estadísticas sin fuente.
- Optimización on-page: metadatos, encabezados, enlaces internos, imágenes con alt, datos estructurados (Article, FAQ, HowTo donde proceda).
- Control de calidad automatizado: comprobaciones programáticas antes de publicar (ver sección 5).
- Publicación y seguimiento: publicación vía CMS o API, registro en un índice de contenidos, y revisión a 30, 60 y 90 días de posiciones, impresiones y conversiones.
La cadencia sostenible con este flujo, para un equipo pequeño, está entre dos y cinco piezas de calidad por semana, no cincuenta. Y esa cadencia, mantenida durante un año con contenido que realmente aporta, supera con mucho en tráfico útil a cualquier volcado masivo.
¿Tu plataforma está preparada para que el contenido posicione?
Antes de invertir en producción de contenido con IA, conviene saber si la casa técnica lo va a aprovechar: rastreo, indexación, rendimiento, datos estructurados e integraciones con el CMS. En Keliam auditamos la base técnica de tu web o ecommerce y montamos los pipelines que hacen sostenible el contenido asistido.
5. Controles de calidad: cómo detectar el contenido que te va a hundir
El punto débil de casi todos los programas de contenido con IA no es la generación, sino la ausencia de controles. Estos son los que consideramos imprescindibles, y la mayoría se pueden automatizar.
5.1 Verificación de hechos y fuentes
Todo dato numérico, versión de software, fecha, nombre de producto o cita debe tener una fuente verificable o eliminarse. En la práctica, instruimos al modelo para que marque cada afirmación verificable con un identificador y genere una lista de comprobación; el revisor la recorre. Un artículo técnico que afirma que «PHP 8.5 elimina la extensión mysqli» o que inventa un parámetro de configuración de Nginx destruye la credibilidad de todo el dominio ante la audiencia que más importa.
5.2 Detección de contenido genérico y relleno
Hay patrones fáciles de detectar programáticamente: frases de transición vacías («en el mundo actual», «es importante destacar»), párrafos que repiten lo dicho en el encabezado, listas de «ventajas» y «desventajas» sin ejemplos, conclusiones que resumen sin aportar. Un simple análisis de densidad de información (proporción de frases con datos, ejemplos o instrucciones concretas frente a frases de relleno) sirve como semáforo antes de la revisión humana.
5.3 Duplicidad y canibalización
Al producir contenido a velocidad es muy fácil acabar con tres artículos que compiten por la misma intención. Antes de aprobar un brief, comprobamos contra el índice de contenidos existente (por similitud semántica, no solo por keyword) si ya hay una página que cubre el tema. Si la hay, se actualiza o se amplía; no se crea otra. Esto es exactamente el tipo de comprobación que una auditoría SEO profesional detecta a posteriori, y que sale mucho más barato evitar a priori.
5.4 Detectores de IA: para qué sirven y para qué no
Los detectores de texto generado por IA tienen tasas de falsos positivos y negativos demasiado altas para tomar decisiones con ellos, y Google ha dicho reiteradamente que no usa ese enfoque. Su utilidad real es otra: como indicador de que un texto «suena» genérico. Si un detector marca un artículo como 95 % IA, el problema no es que Google lo vaya a detectar, sino que probablemente no aporta nada que no esté en cien artículos más. La corrección es añadir experiencia y especificidad, no «humanizar» el texto con trucos.
5.5 Checks técnicos automatizados antes de publicar
- Longitud del title (≤ 60 caracteres) y de la meta description (≤ 155), con la keyword incluida.
- Jerarquía de encabezados correcta (un H1, H2 en orden, sin saltos).
- Todos los enlaces internos y externos responden 200 (comprobación HEAD).
- Todas las imágenes tienen alt descriptivo y peso razonable.
- Datos estructurados válidos (validación del JSON-LD).
- Mínimo de enlaces internos entrantes y salientes definidos.
- Sin placeholders ni marcas de verificación pendientes en el texto.
Estos checks se ejecutan en segundos y evitan la mayoría de errores tontos que se acumulan cuando se publica a ritmo.
6. La pieza técnica: montar un pipeline de contenido sostenible
Desde el punto de vista de desarrollo, un programa de contenido asistido serio no se sostiene con una pestaña de ChatGPT y un documento compartido. Requiere una pequeña infraestructura, modesta pero bien diseñada.
6.1 Arquitectura mínima
Los componentes habituales son: una fuente de datos de keywords y posiciones (API de Search Console, más una herramienta de keywords si se usa); un orquestador de flujos que encadene los pasos (n8n es una opción excelente para esto, como explicamos en n8n + IA para workflows inteligentes); acceso a uno o varios modelos de lenguaje vía API con control de coste; una base de datos o índice vectorial con el contenido existente para las comprobaciones de duplicidad y enlazado interno; y la integración con el CMS (la REST API de WordPress, la API de Shopify, un headless CMS o lo que corresponda) para crear borradores, nunca para publicar directamente.
6.2 Buenas prácticas de implementación
- Borradores, no publicaciones: el pipeline crea contenido en estado borrador y una persona lo aprueba. Ningún flujo automatizado debería tener permiso de publicar.
- Trazabilidad: cada pieza registra qué modelo, qué prompt, qué fuentes y quién la revisó. Cuando algo sale mal (y saldrá), hay que poder saber por qué.
- Control de coste: límites de tokens por pieza, uso de modelos más baratos para clasificación y de modelos capaces solo para redacción y revisión, caché de análisis de SERP. Un pipeline sin límites puede quemar cientos de euros en una noche por un bucle mal configurado.
- Datos propios en el contexto: el diferencial está en inyectar documentación interna, notas de proyecto y datos de la empresa en el contexto del modelo (RAG básico). Es lo que convierte un borrador genérico en uno con sustancia.
- Seguridad: credenciales de API en un gestor de secretos, permisos mínimos en el CMS, y cuidado con el contenido externo que entra en los prompts (las páginas de la competencia que se rastrean pueden contener instrucciones maliciosas para el modelo: la inyección de prompt es un riesgo real en pipelines que leen la web).
Si el CMS es WordPress, el ecosistema ya ofrece piezas nativas para parte de esto; en nuestro artículo sobre conectores de IA en WordPress 7 explicamos cómo configurarlos y, sobre todo, cómo controlar el coste.
6.3 Cuándo tiene sentido un agente y cuándo no
La tentación de 2026 es delegar todo el flujo en un agente autónomo que investigue, redacte, optimice y publique. Nuestra experiencia con agentes de IA en la empresa es que funcionan bien en tareas acotadas con criterios de éxito verificables (clasificar, comprobar enlaces, proponer enlazado interno, detectar contenido desactualizado) y mal en tareas donde el criterio de calidad es subjetivo y el coste del error es alto, como decidir qué se publica bajo la marca de la empresa. Un agente que prepara el trabajo y una persona que decide es la configuración que da resultados.
7. Medir si funciona: métricas y señales de alarma
Un programa de contenido con IA debe justificarse con datos, y con datos que vayan más allá del «hemos publicado 120 artículos».
7.1 Métricas que importan
- Impresiones y clics por cluster (no por artículo suelto): permite ver si la inversión en un tema está ganando visibilidad.
- Posición media de las keywords objetivo a 30/60/90 días desde la publicación.
- Tasa de indexación: qué porcentaje de lo publicado está indexado. Si Google decide no indexar la mitad de lo nuevo, es una señal temprana de que lo considera de bajo valor.
- Conversiones asistidas: formularios, descargas, contactos. El tráfico que no convierte ni asiste conversiones es un coste.
- Citas en AI Overviews y buscadores conversacionales: se puede monitorizar con herramientas específicas o con rastreo propio de las consultas objetivo.
- Coste por pieza publicada y por clic obtenido: incluyendo horas de revisión, no solo tokens.
7.2 Señales de alarma
Hay que parar y revisar el programa si se observa: caída de indexación de contenido nuevo; caída generalizada de posiciones del dominio (no solo de artículos nuevos) coincidiendo con una actualización de Google; aumento del rebote y caída del tiempo en página en el contenido nuevo; aviso de acción manual en Search Console; o, más sutil pero muy revelador, que el equipo comercial o de soporte empiece a recibir consultas basadas en información incorrecta publicada en el blog. Y no hay que olvidar que el rendimiento técnico sigue siendo un requisito: si las nuevas páginas degradan los Core Web Vitals por imágenes sin optimizar o bloques pesados, el efecto neto puede ser negativo.
7.3 Qué hacer si ya has «muerto en el intento»
Si el dominio ya ha sufrido una caída por contenido a escala, la recuperación pasa por un inventario completo del contenido, la identificación de lo que aporta valor y lo que no, la eliminación o consolidación (con redirecciones 301 cuando proceda) de lo que sobra, la mejora sustancial de lo que se conserva y, si hay acción manual, la solicitud de reconsideración documentada. Es un trabajo de meses y conviene abordarlo con una auditoría técnica y de contenidos rigurosa antes de tocar nada, porque borrar sin criterio puede empeorar la situación.
8. Errores frecuentes que vemos en empresas
- Empezar por el volumen: «vamos a publicar 10 artículos al día» sin haber definido qué temas merecen existir. La escala es el último paso, no el primero.
- Delegar el contenido técnico a quien no lo entiende: un redactor sin conocimiento del dominio no puede detectar una alucinación técnica. En contenido B2B técnico, el revisor tiene que ser técnico.
- No aportar nada propio: si el input del modelo es solo la keyword, el output es intercambiable con el de cualquier competidor y no hay razón para que Google (ni el lector) lo prefiera.
- Olvidar la base técnica: publicar sobre una plataforma lenta, con problemas de rastreo o sin datos estructurados es tirar el contenido a un pozo.
- Publicar sin control de enlaces: el contenido generado tiende a inventar URLs plausibles. Un blog con decenas de enlaces internos rotos es una señal pésima tanto para usuarios como para rastreadores.
- Abandonar el contenido después de publicarlo: sin refresco periódico, el contenido técnico caduca en meses. El pipeline debería dedicar tanto esfuerzo a mantener como a crear.
- No alinear con negocio: contenido que trae tráfico de estudiantes o de curiosos cuando el objetivo es captar directores de IT. La intención de búsqueda tiene que estar alineada con el cliente objetivo desde la selección de temas.
Conclusión
La IA no ha hecho que el SEO de contenidos sea más fácil; ha hecho que el contenido mediocre sea gratis, y por tanto sin valor. Lo que sigue siendo escaso, y lo que Google, los buscadores conversacionales y sobre todo los lectores premian, es la experiencia real, el criterio y la precisión. Un programa de contenido que use la IA para acelerar la investigación, la estructuración, la redacción asistida, los controles de calidad y el mantenimiento, y que mantenga a personas con conocimiento del dominio en las decisiones, puede multiplicar la productividad del equipo sin poner en riesgo el dominio. Un programa que use la IA para sustituir ese criterio acabará, antes o después, entre los que murieron en el intento.
Desde el lado de desarrollo, nuestra recomendación es empezar por la base: asegurarse de que la plataforma técnica está en condiciones de aprovechar el contenido, montar un pipeline modesto pero trazable y con controles, y escalar solo cuando los datos de los primeros meses demuestren que lo publicado posiciona y convierte. Si necesitas ayuda con la parte técnica de ese camino, hablemos.
Preguntas frecuentes
¿Google penaliza el contenido generado con IA?
No por el hecho de estar generado con IA. Penaliza el contenido de bajo valor producido a escala para manipular el ranking (scaled content abuse), sea cual sea el método. Contenido generado con IA, revisado y con valor real, es tratado como cualquier otro contenido.
¿Hay que declarar que un artículo se ha escrito con IA?
Google no lo exige, aunque recomienda transparencia sobre la autoría cuando sea razonable esperarla. Lo que sí es imprescindible es que una persona identificable responda de la exactitud del contenido, especialmente en temas técnicos, legales, financieros o de salud.
¿Cuántos artículos al mes se pueden publicar con IA sin riesgo?
No hay una cifra mágica; el riesgo depende de la calidad, no del número. Como referencia práctica, un equipo pequeño que mantiene revisión humana real suele sostener entre dos y cinco piezas de calidad por semana. Si el volumen crece más rápido que la capacidad de revisión, el riesgo se dispara.
¿Sirven los detectores de contenido IA para evitar penalizaciones?
No. Google no usa detectores de IA como señal, y estas herramientas tienen demasiados errores para tomar decisiones. Su única utilidad es como indicador de que un texto suena genérico y necesita más especificidad y experiencia propia.
¿Qué CMS es mejor para integrar un pipeline de contenido con IA?
Cualquiera con una API sólida sirve: WordPress (REST API y conectores nativos desde la versión 7), Drupal, Shopify, o un headless CMS. Lo importante es que el pipeline cree borradores, que las credenciales tengan permisos mínimos y que exista trazabilidad de qué se ha generado y quién lo ha aprobado.