Automatizar con n8n dejó de ser mover datos de un sitio a otro hace ya unos cuantos ciclos de producto. Lo que antes era «cuando entre un pedido, crea una fila en la hoja de cálculo» hoy puede ser «cuando entre un email, entiende qué pide, decide a quién corresponde y abre el ticket con la prioridad correcta». La diferencia entre esas dos frases cabe en un nodo: un modelo de lenguaje colocado en mitad del workflow.
Esta guía recorre cinco casos de uso reales de n8n con IA —clasificación de emails de soporte, generación de contenido para ecommerce, análisis de sentimiento, asistentes técnicos con RAG y resúmenes automáticos de reuniones— y añade lo que no suele contarse: qué tipo de modelo conviene en cada paso, cuánto cuesta en euros al mes, qué controles de seguridad hacen falta antes de dejarlo corriendo solo y qué errores se repiten en casi todas las implantaciones.
Si todavía no tienes n8n funcionando, el punto de partida es la comparativa entre n8n y Zapier y la guía de instalación en producción con Docker y PostgreSQL. Si ya lo tienes en marcha, las diez automatizaciones básicas de una agencia y la conexión con APIs REST y bases de datos son el suelo sobre el que se monta todo lo que viene a continuación.
La convergencia entre automatización e inteligencia artificial
La combinación de n8n con modelos de IA como ChatGPT, Claude y Gemini está transformando la automatización: los workflows ya no solo mueven datos de un punto a otro, sino que los entienden, clasifican y toman decisiones inteligentes. Esta integración convierte a n8n en un orquestador de agentes IA capaz de resolver problemas complejos de forma autónoma.
Por qué esto cambia el tipo de proceso que se puede automatizar
La automatización clásica solo funciona con datos estructurados: un campo que siempre está en el mismo sitio, un valor que siempre viene en el mismo formato. En cuanto el proceso depende de un texto escrito por una persona —un email, una reseña, una incidencia, una transcripción— la automatización tradicional se queda fuera, porque no hay regla que cubra todas las formas de decir lo mismo.
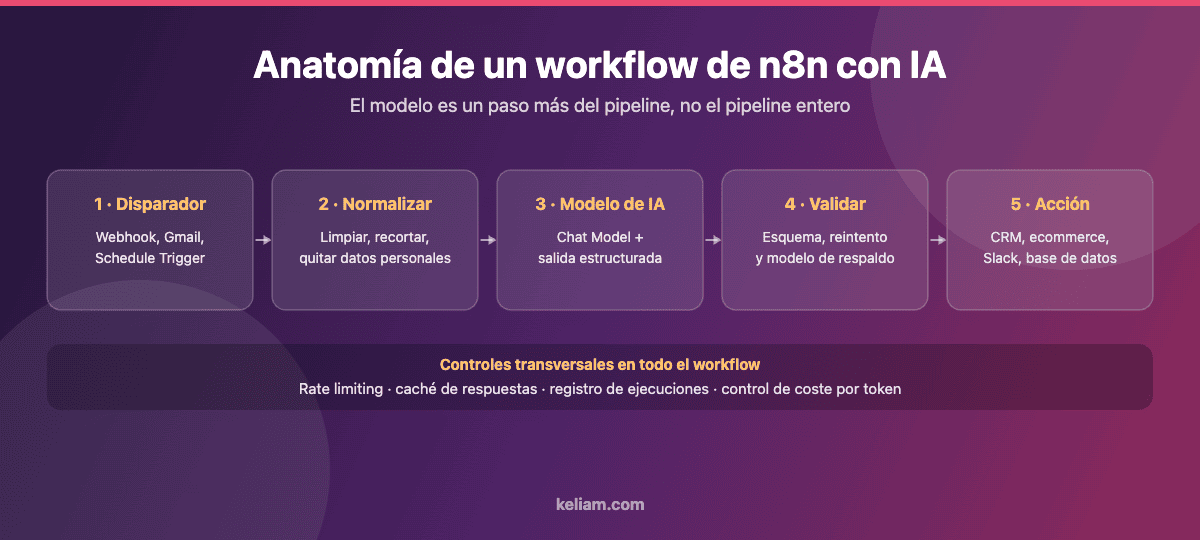
Un modelo de lenguaje en medio del workflow convierte ese texto desestructurado en datos con forma: una categoría, una prioridad, un resumen, una lista de acciones. A partir de ahí, el resto del workflow vuelve a ser automatización de toda la vida. Esa es la idea importante y conviene no perderla de vista: el modelo no sustituye al workflow, es un paso más dentro de él. Los proyectos que fallan suelen ser los que intentan que el modelo haga de workflow entero.
Lo hemos visto repetirse en los casos reales de agentes de IA en empresa: los que salen adelante son los que acotan mucho la tarea del modelo y dejan el resto a nodos deterministas.
Nodos de IA nativos en n8n
Desde la versión 1.19, n8n incluye nodos nativos para los principales proveedores de IA: OpenAI (la familia GPT-5 y sus modelos de imagen), Anthropic (Claude Opus, Sonnet y Haiku), Google (Gemini), y modelos open-source vía Ollama o Hugging Face. Estos nodos permiten enviar prompts, recibir respuestas, y encadenarlas con el resto del workflow.
Además, n8n incorpora nodos especializados de IA como: AI Agent (que puede usar herramientas y razonar paso a paso), Text Classifier (clasifica texto en categorías), Sentiment Analysis, y Summarization Chain. Combinados con nodos de datos, crean pipelines de procesamiento inteligente.
Qué ha cambiado en 2026: la rama 2.x y la llegada de n8n 3.0
El catálogo de proveedores se ha ensanchado bastante desde entonces. A lo largo de 2026 han ido entrando nodos de chat para Azure AI Foundry (el antiguo nodo de Azure OpenAI, renombrado), Perplexity, Databricks, MiniMax y Moonshot Kimi, además de embeddings de NVIDIA Nemotron y nuevos almacenes vectoriales. La rama estable en octubre de 2026 es la 2.4x —la 2.43 se publicó el 6 de octubre— y el ritmo de publicación es semanal, así que cualquier lista de nodos envejece rápido.
Tres cambios recientes importan más que el resto para quien monta workflows con IA:
- Caché de prompts en el nodo de Anthropic. Tanto el nodo de mensajes como el Chat Model permiten cachear la parte fija del prompt. Viene desactivado por defecto y hay que activarlo a mano, pero en workflows que repiten el mismo bloque de instrucciones miles de veces al mes es la optimización de coste con mejor relación esfuerzo-resultado.
- Agentes con herramientas de verdad. El nodo AI Agent en su versión 3 permite forzar una llamada a herramienta en la primera iteración, lo que corta en seco el problema clásico del agente que responde de memoria en lugar de consultar la fuente.
- Conexiones MCP simplificadas. n8n puede actuar como cliente y como servidor del protocolo MCP, que es la forma estándar de exponerle herramientas a un modelo sin escribir un adaptador para cada una.
Y una advertencia que conviene leer antes de actualizar: n8n 3.0 rompe compatibilidad en varios frentes. El autoalojamiento pasa a ser solo por Docker (las instalaciones por npm y npx n8n dejan de estar soportadas); desaparecen nodos legacy muy usados (Function, Function Item, Item Lists, Cron, Interval, HTML Extract, Read PDF); y, en la parte de IA, se retiran el nodo OpenAI antiguo, OpenAI Assistant y OpenAI Model, las memorias Motorhead y Zep, varios nodos Insert/Load de almacenes vectoriales y, sobre todo, el AI Agent v1 con todos sus modos (SQL Agent, Conversational Agent, OpenAI Functions Agent, Plan and Execute, ReAct), sustituidos por el Tools Agent. Antes de dar el salto, el panel Settings > Migration Report de tu instancia lista exactamente qué workflows se van a romper.
Caso de uso 1: Clasificación automática de emails de soporte
Un workflow que conecta Gmail → Claude → SuiteCRM: cada email nuevo se envía a Claude con un prompt que lo clasifica por urgencia (alta/media/baja), tipo (bug/feature/consulta), y producto afectado. Según la clasificación, crea un ticket con la prioridad correcta y lo asigna al equipo correspondiente. Lo que antes requería un humano triando emails manualmente, ahora ocurre en segundos.
Cómo se construye paso a paso
El workflow tiene seis nodos y se monta en una tarde. El disparador es el nodo de Gmail escuchando la bandeja de soporte. El segundo nodo limpia: quita la firma, el histórico de respuestas anteriores y los adjuntos, y recorta el cuerpo a los primeros caracteres útiles. Este paso parece menor y es el que más dinero ahorra, porque los hilos largos multiplican el consumo de tokens sin aportar información nueva.
El tercer nodo es el modelo, con el texto limpio y un prompt que no pide una redacción sino tres campos. El cuarto valida que la respuesta encaja con el esquema esperado y, si no, reintenta una vez. El quinto crea el ticket en el CRM —si trabajas con SuiteCRM, conviene combinarlo con sus propios workflows y logic hooks para que la asignación y las notificaciones se resuelvan dentro del CRM—. El sexto registra la ejecución en una tabla propia: entrada, salida, modelo, tokens y coste.
El prompt importa menos que el esquema de salida
La tentación es escribir un prompt largo y literario. Funciona mejor lo contrario: un prompt corto y un esquema de salida estricto. Pedir «devuelve un JSON con urgencia (alta|media|baja), tipo (bug|feature|consulta) y producto, sin texto adicional» da resultados mucho más estables que tres párrafos explicando el matiz entre urgencia alta y media.
Y hay que prever la respuesta rara: el email que no encaja en ninguna categoría, el que viene en otro idioma, el que es spam. Añadir una categoría «no clasificable» y enrutarla a revisión humana evita el peor escenario, que es un modelo inventando una categoría plausible para algo que no entendió.
Caso de uso 2: Generación de contenido para e-commerce
Para tiendas WooCommerce o Shopify con cientos de productos, n8n puede automatizar la generación de descripciones SEO. El workflow lee los datos del producto (nombre, categoría, atributos), construye un prompt optimizado para redacción de contenido con IA, envía al modelo de lenguaje elegido, y actualiza la descripción del producto vía API. Procesando 50-100 productos por hora sin intervención humana.
Dónde se rompe este workflow
En tres sitios, siempre los mismos. El primero: la calidad de los atributos de entrada. Si la ficha de producto solo trae el nombre y una categoría genérica, el modelo rellenará el hueco con adjetivos vacíos, y acabarás con doscientas descripciones que dicen lo mismo. Antes de automatizar la redacción merece la pena automatizar el relleno de atributos, aunque sea a partir del PDF del fabricante.
El segundo: publicar sin revisar. El patrón que funciona es generar la descripción en estado de borrador, dejar que una persona apruebe en bloque las de una categoría y publicar después. Es el mismo principio de la aprobación humana en mitad del flujo que n8n soporta de forma nativa, incluso para llamadas a herramientas de un agente.
El tercero: el contenido duplicado. Si el prompt es idéntico para todos los productos de una familia, las descripciones salen casi calcadas y Google las trata como tales. La solución no es un prompt más creativo sino inyectar en cada llamada los atributos diferenciales del producto concreto. Si vendes online, esto enlaza directamente con el resto de automatizaciones de pedidos, stock e integraciones que ya tengas montadas.
Caso de uso 3: Análisis de sentimiento de reviews
Recopila reviews de Google, Trustpilot y redes sociales, envíalas a un modelo de IA para análisis de sentimiento, y genera un reporte semanal con las tendencias. Si se detecta un pico de reviews negativas, el workflow envía una alerta inmediata al equipo de customer success. Ideal para proyectos e-commerce donde la reputación online es crítica.
Qué medir de verdad
Una puntuación de sentimiento de 0 a 10 por reseña es un dato bonito y poco accionable. Lo que mueve decisiones es la causa: cuántas reseñas negativas mencionan el plazo de entrega, cuántas el estado del paquete, cuántas la atención posventa. Pedirle al modelo que extraiga el motivo además del tono convierte el informe semanal en una lista priorizada de cosas que arreglar.
Dos detalles prácticos. Uno: la alerta por pico de reseñas negativas necesita un umbral relativo, no absoluto —tres reseñas malas en un día son normales en un volumen alto y una señal de incendio en un volumen bajo—. Dos: el análisis de sentimiento es, de todos los casos de esta guía, el que mejor funciona con un modelo pequeño y barato, porque la tarea es clasificar, no redactar.
Caso de uso 4: Asistente técnico con RAG
Construye un asistente de soporte técnico que busca en tu documentación interna antes de responder. n8n orquesta el flujo: recibe la pregunta del usuario → busca documentos relevantes en Pinecone o Qdrant → construye el prompt con contexto → envía a Claude → devuelve la respuesta al usuario. Es el patrón RAG (Retrieval-Augmented Generation) implementado sin código, ideal para plataformas SaaS que necesitan soporte 24/7.
Las tres decisiones que determinan si el RAG funciona
De todos los casos de esta guía, el RAG es el que más fácil es montar en una demo y más difícil es dejar fino en producción. Tres decisiones explican casi toda la diferencia, y las desarrollamos a fondo en la guía de RAG para empresas:
- Cómo trocear los documentos. Trozos demasiado grandes diluyen la búsqueda; demasiado pequeños pierden el contexto y devuelven fragmentos que no se entienden solos. Respetar la estructura del documento —cortar por secciones, no cada N caracteres— suele dar mejores resultados que cualquier ajuste posterior.
- Qué pasa cuando no hay respuesta en la documentación. Un asistente que no sabe decir «esto no está documentado, te paso con una persona» acaba inventando. Hay que instruirlo explícitamente y, mejor aún, comprobar en un nodo posterior que la respuesta cita al menos un fragmento recuperado.
- Cómo se actualiza el índice. La documentación cambia. Si el índice vectorial se construye una vez y nadie lo vuelve a tocar, en tres meses el asistente responde con procedimientos derogados. Un workflow programado que reindexa lo modificado resuelve el problema y es, irónicamente, la automatización más fácil de las que aparecen en este artículo.
Ten en cuenta que n8n 3.0 retira varios nodos Insert/Load de almacenes vectoriales antiguos (In Memory, Pinecone, Supabase y Zep en sus versiones legacy): si montas el RAG hoy, conviene hacerlo ya con los nodos actuales para no tener que rehacerlo en la siguiente actualización.
Caso de uso 5: Resumen automático de reuniones
Integra n8n con tu herramienta de videoconferencia (Zoom, Meet, Teams). Cuando termina una reunión, el workflow descarga la transcripción, la envía a Claude para generar un resumen estructurado con action items, y lo publica en el canal de Slack del proyecto. Perfecto para equipos de startups que necesitan documentar decisiones rápidamente.
El punto delicado: la transcripción lleva datos personales
Una transcripción de reunión es, casi siempre, el dato más sensible que va a atravesar tus workflows: nombres, clientes, cifras, condiciones comerciales, a veces comentarios sobre personas. Antes de enviarla a un proveedor externo hay que tener claras tres cosas: qué proveedor es y dónde procesa, si ese proveedor entrena con tus datos (en los planes de empresa normalmente no, pero hay que comprobarlo), y cuánto tiempo guarda la transcripción tu propio n8n en el historial de ejecuciones.
Esto último se olvida mucho: por defecto, n8n guarda los datos de cada ejecución, así que la transcripción completa queda almacenada en tu base de datos aunque el resumen ya esté publicado. Conviene limitar la retención de ejecuciones y, en los workflows que manejen datos personales, activar la redacción de datos sensibles.
Un consejo de formato: pedir el resumen en tres bloques fijos —decisiones tomadas, acciones con responsable y fecha, y temas abiertos— produce resúmenes mucho más útiles que pedir «un resumen». Y publicar los action items como mensajes separados en Slack hace que se puedan asignar y cerrar uno a uno.
Qué modelo usar en cada paso del workflow
El error de coste más repetido es enchufar el modelo más capaz a todos los nodos de IA del workflow. En la práctica, la mayoría de pasos son clasificaciones o extracciones sencillas que un modelo pequeño resuelve igual de bien, diez veces más rápido y a una fracción del precio.
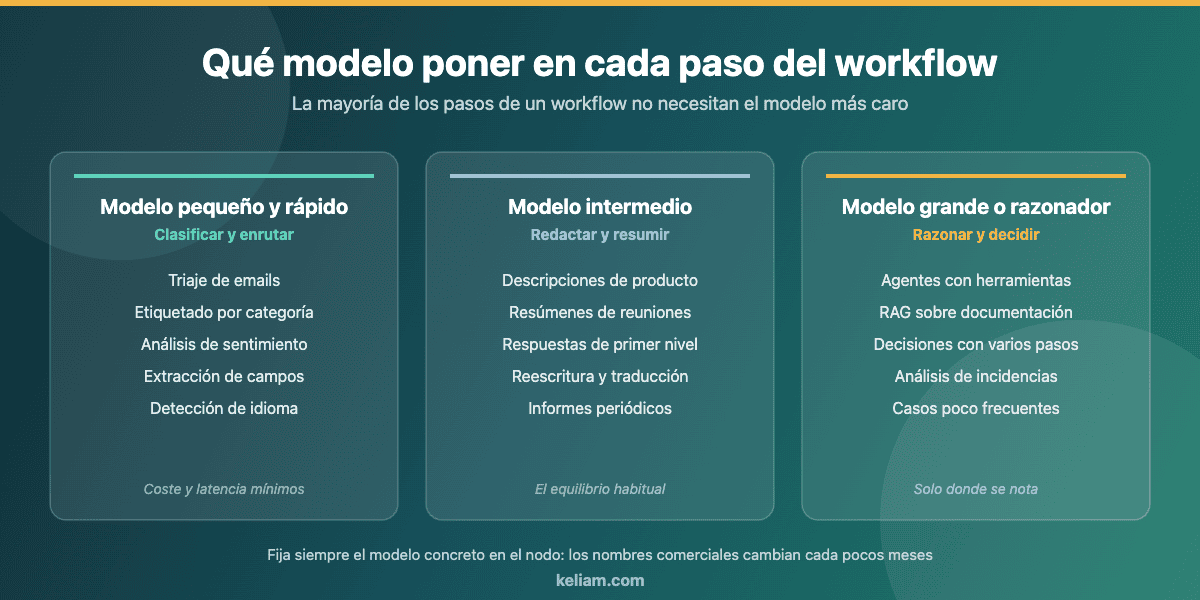
Un apunte que ahorra disgustos: fija siempre el modelo concreto en el nodo en lugar de dejar el alias genérico del proveedor. Los nombres comerciales cambian cada pocos meses y un alias que apunta «al último modelo» puede cambiarte el comportamiento del workflow de un día para otro sin que hayas tocado nada. Si necesitas comparar proveedores antes de decidir, la comparativa de plataformas de IA para empresas entra en el detalle de capacidades y precios.
Cuánto cuesta de verdad un workflow con IA
El coste de un workflow con IA tiene tres partidas y la que suele sorprender no es la del modelo.
Tokens. Se paga por entrada y por salida, y la entrada es casi siempre mayor de lo que uno cree: el hilo de email completo, la ficha de producto entera, los cinco fragmentos recuperados del índice vectorial. Recortar la entrada es la palanca número uno. La caché de prompts es la número dos cuando el bloque de instrucciones es largo y se repite.
Ejecuciones de n8n. En n8n Cloud se paga por ejecución; en autoalojado se paga en servidor. Un workflow que se dispara con cada email entrante puede tener un volumen muy distinto al previsto en cuanto alguien activa una lista de distribución. Conviene medirlo una semana antes de darlo por bueno, y si el volumen crece de verdad, escalar n8n sobre Kubernetes cambia por completo la ecuación.
Reintentos y errores. Un workflow mal validado que reintenta tres veces cada llamada fallida triplica la factura sin que nadie se entere hasta final de mes. Un nodo de registro que guarde modelo, tokens y coste de cada ejecución cuesta quince minutos de montaje y es lo único que permite responder a «¿cuánto nos está costando esto?» con un número en lugar de una intuición.
Como orden de magnitud: un workflow de clasificación de 2.000 emails al mes con un modelo pequeño se mueve en el entorno de unos pocos euros mensuales de tokens. El mismo workflow con el modelo más capaz del catálogo y sin recortar la entrada puede multiplicar esa cifra por veinte o treinta. La diferencia no está en la IA, está en el diseño del workflow.
Mejores prácticas para workflows con IA
Tres recomendaciones clave: primero, incluye siempre un nodo de rate limiting para no exceder los límites de la API del modelo; segundo, implementa fallbacks (si Claude falla, intenta con GPT); tercero, almacena las respuestas en cache para evitar llamadas redundantes cuando los datos de entrada no han cambiado.
Cinco controles más que conviene añadir
- Salida estructurada y validada. Pide JSON con un esquema y valida que llega lo esperado. Un workflow que da por buena cualquier respuesta del modelo acaba escribiendo basura en el CRM.
- Timeout explícito. Sin él, un modelo lento bloquea la cola de ejecuciones y arrastra al resto de workflows del mismo worker.
- Idempotencia. Si el workflow se reintenta, no debe crear el ticket dos veces. Una clave única por mensaje de entrada resuelve el 90% de los duplicados.
- Humano en el bucle donde hay consecuencias. Enviar un email a un cliente, modificar un precio o cerrar una incidencia merecen una aprobación previa. n8n soporta este patrón de forma nativa, también para las llamadas a herramientas de un agente.
- Entorno de pruebas separado. Probar prompts contra la base de datos de producción es la forma más rápida de descubrir que el modelo entendió mal una instrucción.
Si quieres más contexto sobre dónde encaja cada una de estas piezas en el día a día de un equipo técnico, los diez usos de IA que una agencia de desarrollo debería implementar recorre el mismo terreno desde el lado del proceso, no del workflow.
Seguridad y cumplimiento: la parte que nadie mira hasta que hay un incidente
Meter un modelo externo en mitad de un workflow significa que datos de tu empresa salen hacia un tercero. No es necesariamente un problema —se hace todos los días—, pero sí es una decisión que hay que tomar a conciencia y dejar documentada.
Los cuatro puntos mínimos a revisar son: qué datos salen (y si se pueden anonimizar o recortar antes del nodo del modelo), dónde se procesan (región del proveedor, relevante si trabajas con datos sujetos al RGPD), qué pasa con las credenciales (las claves de API viven en el gestor de credenciales de n8n, nunca en un nodo de código) y quién puede editar los workflows, porque quien edita un workflow puede cambiar a dónde se envían los datos.
Si tu organización va camino de una certificación, esto no es opcional: los controles de desarrollo seguro y de relación con proveedores de la ISO 27001 aplican de lleno a un workflow que procesa información de clientes en un servicio externo. Y si partes de una base más sencilla, la guía de seguridad informática para pymes desde cero cubre los cimientos sobre los que todo esto se apoya.
Una medida barata y muy eficaz: separar las credenciales por entorno y por workflow. Si una clave se filtra, el alcance queda acotado a un flujo concreto en lugar de a toda la instancia.
Cinco errores habituales al meter IA en n8n
- Pedirle al modelo que haga de workflow. Un único prompt gigantesco que clasifica, redacta, decide y formatea es imposible de depurar. Separar en pasos permite ver dónde falla y cambiar solo esa pieza.
- No limpiar la entrada. Firmas, histórico de respuestas y HTML del email multiplican el coste y empeoran el resultado. El nodo de normalización es el que mejor rentabiliza el tiempo invertido.
- Confiar en el formato de salida sin validarlo. Los modelos acatan el esquema la mayoría de las veces, no todas. Esa minoría es la que rompe el workflow a las tres de la mañana.
- Dejar la retención de ejecuciones por defecto. La base de datos crece sin parar y, peor, acumula datos personales que ya no hacen falta.
- Actualizar sin leer las notas de versión. Con n8n 3.0 retirando nodos legacy y el AI Agent v1, una actualización desatendida puede dejar workflows críticos sin ejecutar. El Migration Report existe precisamente para eso.
¿Quieres montar workflows con IA sin que se te vaya de las manos?
En Keliam diseñamos, desplegamos y mantenemos automatizaciones con n8n conectadas a tu CRM, tu ecommerce y tus sistemas internos: desde el primer workflow hasta la instancia autoalojada con control de costes, credenciales y actualizaciones.
Preguntas frecuentes
¿Hace falta saber programar para montar estos workflows?
No para los cinco casos de esta guía: se resuelven con nodos y configuración. Saber leer JSON y entender qué es una llamada a una API ayuda mucho, sobre todo a la hora de validar salidas y depurar errores.
¿Es mejor n8n Cloud o autoalojado para workflows con IA?
Depende de dos cosas: el volumen y la sensibilidad de los datos. Cloud evita mantenimiento y es razonable para empezar. Autoalojado tiene más sentido cuando el volumen de ejecuciones es alto o cuando los datos no deben salir de tu infraestructura más allá de la llamada al modelo. Ojo con n8n 3.0: el autoalojamiento pasa a ser únicamente por Docker.
¿Puedo usar modelos locales en lugar de una API externa?
Sí, a través de Ollama o de un endpoint compatible. Para clasificación y extracción de campos, un modelo abierto de tamaño medio corriendo en tu propio servidor da resultados perfectamente utilizables y resuelve de golpe la parte de protección de datos. Para razonamiento complejo y agentes con herramientas, la diferencia con los modelos comerciales grandes sigue notándose.
¿Cómo evito que el modelo se invente datos?
Con tres medidas combinadas: darle solo el contexto necesario, obligarle a un formato de salida verificable y, en los flujos de respuesta, exigir que cite la fuente recuperada. Donde haya consecuencias para un cliente, aprobación humana antes de ejecutar.
¿Qué pasa si el proveedor de IA tiene una caída?
Para eso está el fallback: un segundo proveedor configurado en la rama de error del nodo. Merece la pena probarlo de verdad una vez, desactivando la credencial principal, en lugar de confiar en que está bien configurado.
¿Cuánto se tarda en poner en marcha el primer workflow con IA?
El primero, con n8n ya instalado, es cuestión de una tarde. Dejarlo fino —validaciones, reintentos, registro de costes, control de datos personales— lleva bastante más, y es la parte que distingue una demo de algo que puedes dejar funcionando solo.
¿Esto sustituye a las automatizaciones que ya tengo?
No, se monta encima. Los workflows deterministas siguen siendo la columna vertebral; la IA entra solo donde hay texto libre que interpretar. De hecho, la mejor forma de empezar es coger un workflow que ya funciona y añadirle un único nodo de modelo en el punto donde hoy hace falta una persona.
Conclusión
La combinación de n8n con modelos de lenguaje no es interesante porque sea novedosa, sino porque amplía el conjunto de procesos automatizables a todos aquellos que dependen de texto escrito por personas. Los cinco casos de esta guía —triaje de emails, contenido de producto, sentimiento de reseñas, asistentes con RAG y resúmenes de reuniones— son los que mejor relación coste-beneficio tienen hoy, y los cinco se montan con nodos nativos.
La diferencia entre una prueba de concepto y un workflow que lleva meses funcionando solo está en lo poco vistoso: normalizar la entrada, validar la salida, elegir un modelo proporcionado a la tarea, medir el coste y decidir conscientemente qué datos salen de casa. Y, con n8n 3.0 en puertas, revisar el Migration Report antes de actualizar.
Si quieres que revisemos tus automatizaciones actuales o montar las primeras con IA sobre tu propia infraestructura, cuéntanos qué proceso te está comiendo más horas y te decimos si merece la pena automatizarlo.