De todas las fases del desarrollo, el testing es la que mejor encaja con lo que un modelo de lenguaje sabe hacer: trabajo repetitivo, muy pautado, con un resultado que se puede verificar automáticamente. Un test o pasa o no pasa. No hay que creerse lo que diga la IA, basta con ejecutarlo.
Eso explica por qué el QA asistido por IA ha pasado de experimento a práctica normal en poco más de dos años, y por qué hoy herramientas como Playwright incorporan agentes de test de serie, sin plugins ni servicios de terceros. Esta guía recorre siete puntos del ciclo donde la IA aporta de verdad —generación de tests unitarios, E2E, seguridad, regresión, pre-revisión de código, rendimiento e integración en CI/CD—, y marca con claridad dónde está el límite: qué conviene delegar y qué sigue necesitando a una persona delante.
Si tu equipo está empezando a meter IA en el día a día, este artículo encaja con los diez usos de IA que una agencia de desarrollo debería implementar y con el uso de IA para definir requerimientos, que es justo el paso anterior al que se cuenta aquí.
El testing como cuello de botella en proyectos IT
En la mayoría de proyectos de desarrollo, el testing es la fase que más se recorta cuando los plazos aprietan. Y es justamente la fase donde los recortes más cuestan: un bug que llega a producción es entre 10 y 100 veces más caro de arreglar que uno detectado en desarrollo.
La inteligencia artificial está cambiando esta ecuación. En Keliam, la integración de IA en nuestros procesos de QA ha permitido aumentar la cobertura de tests sin aumentar el tiempo dedicado a testing.
Qué ha cambiado desde entonces
El cambio de fondo no es que los modelos escriban mejor código —que también—, sino que han dejado de trabajar a ciegas. Antes, el asistente generaba un test mirando únicamente el fuente que le pegabas. Ahora puede abrir la aplicación, navegarla, leer el árbol de accesibilidad de la página, ejecutar el test y ver si falla, todo dentro del mismo bucle. Esa diferencia —generar con verificación frente a generar a ciegas— es la que ha hecho que los tests generados pasen de «un punto de partida» a «algo que a menudo se puede fusionar con retoques».
La pieza técnica que lo ha hecho posible en casi todas las herramientas es el protocolo MCP, que estandariza cómo un modelo accede a herramientas externas: un navegador, un repositorio, una base de datos de pruebas. En lugar de un adaptador propietario por cada combinación de asistente y herramienta, hay un protocolo común.
Generación automática de tests unitarios
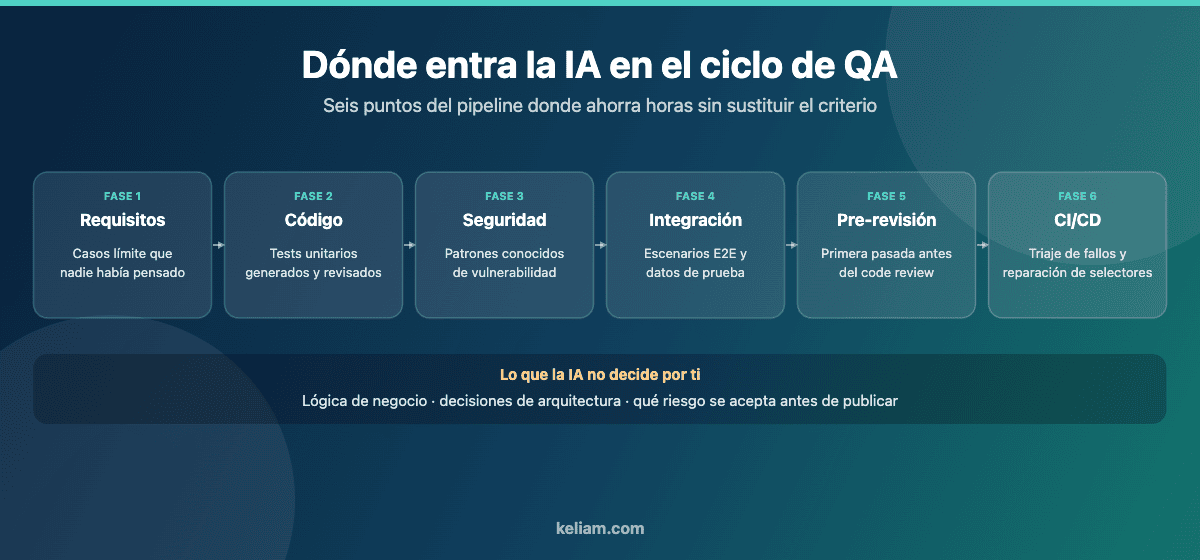
Claude Code y los asistentes de la familia GPT pueden generar tests unitarios a partir del código fuente. El flujo es simple: apunta al componente o función, pide tests que cubran el happy path, edge cases y error handling, revisa los tests generados y ajusta los que necesiten contexto de negocio que la IA no tiene.
En nuestra experiencia, la IA genera tests correctos el 80% de las veces a la primera. El 20% restante necesita ajustes menores. El ahorro de tiempo respecto a escribirlos manualmente es del 60-70%.
Cómo pedirlos para que salgan bien a la primera
La diferencia entre un test generado inservible y uno que se fusiona casi tal cual está en tres detalles de la petición:
- Dar el contrato, no solo el código. Si la función tiene tipos, esquema de entrada o documentación, incluirlos. El modelo deduce mucho mejor los casos límite cuando sabe qué valores son válidos.
- Enseñarle un test que ya exista en el proyecto. Es la forma más rápida de que respete vuestras convenciones de nombres, vuestros fixtures y vuestra forma de montar y desmontar el entorno, en lugar de inventarse un estilo nuevo.
- Prohibir explícitamente que modifique el código bajo prueba. El fallo más molesto de todos: en vez de escribir un test que detecta el bug, el asistente «arregla» la función para que el test pase. Si el código es correcto y el test falla, lo que hay que revisar es el test.
Un apunte sobre la cobertura: subir del 40% al 80% de cobertura con tests generados es fácil y engañoso. Cien tests que comprueban getters no detectan un solo bug real. La métrica útil no es el porcentaje de líneas cubiertas, sino cuántos de los fallos que llegaron a producción el trimestre pasado habría atrapado la suite actual.
Tests de integración y E2E con IA
Para tests más complejos, la IA necesita más contexto. El approach que funciona es proporcionar la documentación funcional del módulo y pedir que genere escenarios de test E2E en formato Cypress, Playwright o Selenium.
La IA es especialmente buena generando datos de prueba realistas y variados. En un proyecto de e-commerce, generó 500 combinaciones de producto-cantidad-cupón-dirección que cubrían escenarios que nuestro equipo no habría contemplado manualmente.
Agentes de test: planner, generator y healer
Playwright ha oficializado este flujo con tres agentes que se instalan en el proyecto con npx playwright init-agents y que se pueden usar por separado, en secuencia o encadenados:
- Planner. Explora la aplicación y escribe un plan de pruebas en Markdown. Es la pieza más infravalorada: produce un documento legible que una persona de producto puede revisar antes de que se escriba una sola línea de test.
- Generator. Convierte ese plan en ficheros de test reales, comprobando selectores y aserciones contra la aplicación mientras los escribe, no después.
- Healer. Ejecuta la suite y repara los tests que fallan, deteniéndose cuando el test pasa o cuando los límites que le hayas puesto cortan el bucle.
Las definiciones de estos agentes se regeneran cada vez que se actualiza Playwright, y la opción --loop permite engancharlos a VS Code, Claude Code, Codex u OpenCode. Si estáis eligiendo con qué asistente trabajar, la comparativa por caso de uso y la comparativa de plataformas de IA para empresas cubren esa decisión.
El test que se repara solo no siempre es buena noticia
El healer es la parte más llamativa y la que más cuidado requiere. Hay dos tipos de fallo que se parecen mucho en el informe y no se parecen en nada en la realidad: el selector que cambió porque alguien renombró una clase CSS, y el selector que falla porque el botón ya no está. El primero se repara. El segundo es un bug que acabas de tapar.
La forma de convivir con esto es sencilla: que las reparaciones automáticas lleguen como una propuesta de cambio revisable y nunca como una modificación silenciosa de la suite. Y vigilar el número de reparaciones por semana: si crece, no es que los tests sean frágiles, es que la interfaz está cambiando más de lo que nadie está siguiendo.
Detección de vulnerabilidades de seguridad
Claude Code Security analiza el código buscando patrones de vulnerabilidad conocidos: SQL injection, XSS, CSRF, autenticación débil, exposición de datos sensibles. No sustituye a un pentest profesional, pero cubre el 80% de las vulnerabilidades más comunes antes de que el código llegue a staging.
Dónde acaba el análisis automático
El análisis estático asistido por IA es bueno encontrando lo que tiene forma de vulnerabilidad conocida dentro de tu código. Hay dos zonas que no cubre y que concentran buena parte de los incidentes reales:
La primera es la cadena de suministro: el paquete de terceros con una versión vulnerable, el repositorio abandonado, la dependencia transitiva que nadie eligió conscientemente. Eso se revisa con otras herramientas y con un proceso aparte, como explicamos en la auditoría de dependencias y supply chain.
La segunda son los fallos de lógica de autorización: el endpoint que devuelve el pedido correcto a la persona equivocada. No hay patrón sintáctico que delate eso, porque el código es perfectamente válido; lo que falla es la regla de negocio. Sigue necesitando revisión humana y, cuando el riesgo lo justifica, una auditoría de código profesional.
Si tu organización trabaja bajo un marco formal, estos controles no son opcionales: el desarrollo seguro es un requisito explícito tanto en ISO 27001 y el ENS como en los propios pliegos de muchos clientes públicos.
Análisis de regresión con IA
Cuando se modifica un componente, la IA puede analizar el impacto en el resto del sistema: qué otros módulos dependen de él, qué tests existentes podrían verse afectados y qué nuevos tests son necesarios para cubrir la regresión. Esto es especialmente valioso en proyectos legacy donde la documentación es escasa.
El escenario donde más rinde: el proyecto heredado
Un código que lleva años en producción, sin tests y sin la persona que lo escribió, es el caso donde la IA cambia el orden de magnitud del trabajo. No porque escriba tests perfectos, sino porque hace en minutos la parte que desanima a cualquiera: leer cinco mil líneas y explicar qué hace cada módulo y quién llama a quién.
El orden que funciona es este: primero, pedir un mapa de dependencias y un resumen por módulo; segundo, generar tests de caracterización que capturen el comportamiento actual tal y como es, aunque sea raro —el objetivo no es que el código esté bien, es tener una red antes de tocarlo—; tercero, refactorizar con esa red puesta. Es el mismo enfoque que aplicamos al auditar una tienda online heredada.
Revisión de código automatizada previa al code review
Antes de que un senior developer dedique tiempo a revisar un PR, la IA hace una primera pasada buscando: código muerto, complejidad ciclomática excesiva, violaciones de convenciones, imports no usados, oportunidades de refactoring y posibles race conditions o memory leaks.
El reviewer humano se centra entonces en lo que realmente importa: la lógica de negocio, las decisiones de arquitectura y la coherencia con el resto del sistema.
El límite: la IA no sabe qué es importante en tu negocio
El riesgo de la revisión automática no es que se equivoque, es que sepulte el comentario importante bajo treinta comentarios triviales. Un PR con cuarenta anotaciones sobre nombres de variables consigue que nadie lea la número treinta y uno, que era la que decía que el descuento se aplica dos veces.
Dos medidas lo arreglan: limitar al asistente a un número máximo de comentarios por PR, ordenados por gravedad, y configurarlo para que lo puramente estilístico lo resuelva el formateador automático en lugar de comentarlo. El code review humano debe quedarse con las preguntas que empiezan por «por qué», no por «esto debería llamarse».
Testing de rendimiento y load testing
La IA ayuda a diseñar escenarios de carga realistas basados en datos de producción. «Genera un script de k6 que simule 1000 usuarios concurrentes navegando por el catálogo, añadiendo productos al carrito y completando checkout» — el resultado es un script funcional que simula patrones de uso reales.
El dato que falta casi siempre
Un script de carga generado en treinta segundos es útil; un escenario de carga realista requiere algo que el modelo no tiene: cómo se comporta de verdad tu tráfico. Qué proporción de visitas llega al checkout, cuánto tiempo pasa entre páginas, qué porcentaje viene de móvil, cómo se concentra el pico del lunes por la mañana o de la campaña de rebajas.
Sin esos números, el script simula mil usuarios perfectos haciendo todos lo mismo al mismo ritmo, que es precisamente el patrón que nunca rompe nada. Sacar esas cifras de tu propia analítica y dárselas al modelo convierte una prueba decorativa en una que encuentra el cuello de botella real. Y conviene medir también lo que ve el usuario, no solo el servidor: los Core Web Vitals bajo carga cuentan una historia distinta a la de los tiempos de respuesta del backend.
Integración en el pipeline CI/CD
Todo esto se integra en el flujo de desarrollo continuo. Nuestro pipeline típico incluye: lint y análisis estático, tests unitarios generados con IA y revisados, análisis de seguridad con Claude Code Security, tests E2E automatizados, y check de rendimiento en cada deploy a staging.
Con agentes IA, incluso la interpretación de resultados de tests se automatiza: el agente analiza los fallos, los clasifica por severidad y sugiere fixes.
Cuánto cuesta y dónde conviene ejecutarlo
Meter llamadas a modelos dentro del pipeline tiene un coste que crece con cada push, así que conviene separar dos cosas. Lo que se ejecuta en cada commit debe ser determinista y barato: lint, tests ya escritos, análisis estático. Lo que llama a un modelo —generar tests nuevos, analizar una regresión, resumir fallos— encaja mejor en la apertura del PR, en una ejecución nocturna o bajo petición explícita.
Dos cautelas prácticas. Una: las claves de API de los modelos son credenciales de producción a todos los efectos y no deben estar al alcance de un pipeline que ejecuta código de PRs externas. Dos: si el análisis implica enviar código propietario a un proveedor externo, es una decisión que debe estar documentada y aprobada, no una que tome quien configuró el pipeline. En la guía de seguridad informática para pymes está el marco mínimo para plantearlo, y los controles de ISO 27001 lo tratan explícitamente.
Qué delegar a la IA y qué no
La línea no la marca la dificultad técnica de la tarea, la marca quién responde si sale mal. Todo lo que es mecánico, repetitivo y verificable automáticamente se delega sin problema. Todo lo que implica decidir qué es aceptable para el negocio, no.
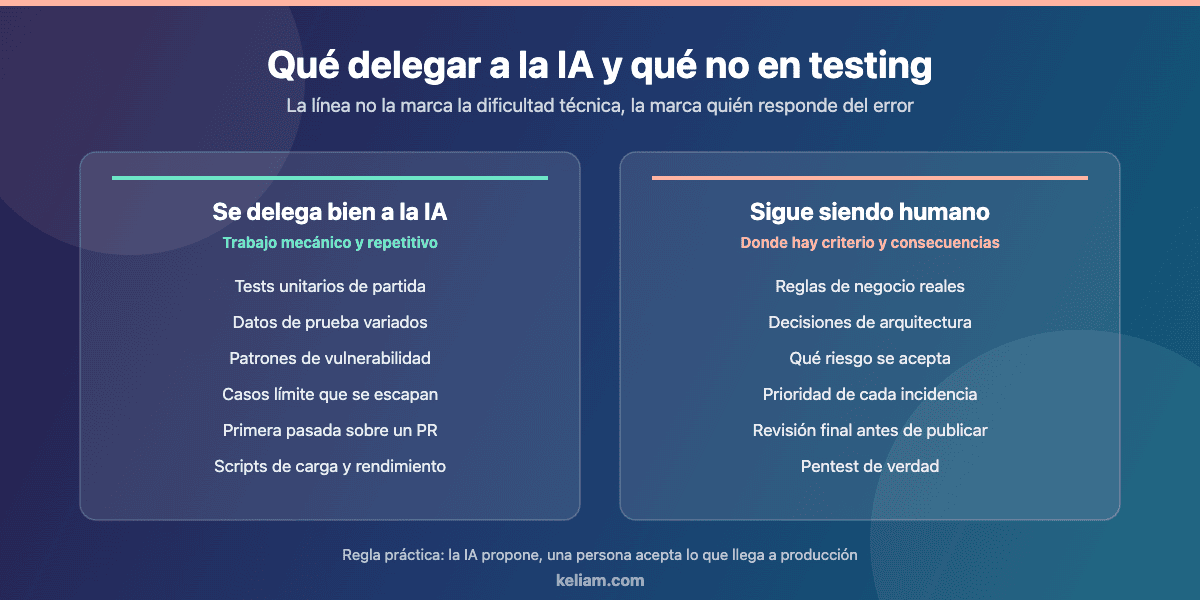
Dicho de otra forma: la IA es un multiplicador del equipo de QA, no un sustituto. Cuando se usa como sustituto, lo que sube no es la calidad sino el número de tests, que no es lo mismo. Es la misma conclusión a la que llegan los equipos que han medido en serio sus casos reales de agentes de IA en empresa.
Cinco errores habituales al meter IA en el QA
- Confundir cobertura con calidad. Generar mil tests triviales sube el porcentaje y no detecta nada. Mejor cincuenta tests sobre los flujos que de verdad generan ingresos o pierden datos.
- Fusionar tests generados sin leerlos. Un test que no se ha leído es, en el mejor de los casos, ruido; en el peor, documenta un comportamiento equivocado como si fuera el correcto.
- Dejar que el asistente toque el código bajo prueba. Si el test falla y el asistente modifica la función para que pase, el bug sigue ahí y ahora además tiene un test que lo bendice.
- Usar datos reales como datos de prueba. Clonar la base de datos de producción al entorno de test es cómodo y es una brecha de datos personales esperando a ocurrir. Pedirle datos sintéticos realistas al modelo es, precisamente, uno de los casos donde mejor rinde.
- No revisar lo que repara el healer. Las reparaciones automáticas aceptadas a ciegas convierten la suite en un sistema que siempre está en verde, que es exactamente lo contrario de lo que se quería.
Cómo empezar en dos semanas
Un plan realista para un equipo que hoy no tiene nada de esto montado, sin parar el desarrollo:
- Semana 1, días 1-2. Elegir un único módulo: el que más incidencias genere en los últimos tres meses. No el más bonito ni el más nuevo, el que más duele.
- Días 3-5. Generar tests unitarios de ese módulo con el asistente, revisarlos uno a uno y fusionar solo los que aporten. Aquí se aprende qué estilo de petición funciona en vuestro proyecto.
- Semana 2, días 1-2. Montar los agentes de test sobre el flujo crítico de la aplicación —el que si se rompe hay que llamar a alguien un domingo— y dejar que el planner escriba el plan en Markdown. Revisarlo con producto.
- Días 3-4. Añadir el análisis de seguridad al PR y limitar el número de comentarios automáticos por revisión.
- Día 5. Medir una sola cosa: de los fallos que llegaron a producción el trimestre anterior, ¿cuántos habría detectado lo que acabáis de montar? Ese número decide si merece la pena extenderlo al resto del proyecto.
¿Tu proyecto va a producción sin una red de tests debajo?
En Keliam montamos la estrategia de QA de proyectos que ya están en marcha: cobertura sobre los flujos críticos, análisis de seguridad en el pipeline y revisión del código que heredaste de otro equipo.
- Auditoría técnica — estado real del código, los tests y el rendimiento
- Auditoría de seguridad y pentesting — lo que el análisis automático no ve
- Servicios IT — equipo técnico para integrar el QA en tu pipeline
- Mantenimiento de software — que la suite siga viva dentro de un año
Preguntas frecuentes
¿Los tests generados por IA son fiables?
Son fiables en la medida en que alguien los lea. Un test generado tiene la misma autoridad que uno escrito por un compañero junior: probablemente esté bien, conviene revisarlo, y el valor está en lo rápido que llega al borrador. Lo que no es defendible es fusionarlo sin leerlo.
¿Puede la IA sustituir a un QA manual?
No, y la razón no es técnica. El QA manual aporta algo que un modelo no tiene: saber qué es inaceptable para este cliente concreto en este momento concreto. Lo que sí hace la IA es liberar al QA de la parte repetitiva para que dedique el tiempo a los flujos donde hay dinero o datos en juego.
¿Qué pasa con el código propietario que se envía al modelo?
Es la pregunta que hay que resolver antes de montar nada. Las opciones son tres: un proveedor con contrato empresarial que no entrene con tus datos, un modelo desplegado en tu propia infraestructura, o limitar el uso a los módulos que no contienen lógica sensible. La respuesta correcta depende del cliente, pero tiene que estar escrita.
¿Vale la pena en un proyecto pequeño?
Sí, y probablemente más que en uno grande: los proyectos pequeños son justamente los que no tienen presupuesto para un equipo de QA dedicado. Generar tests para los cuatro flujos críticos de un ecommerce de una persona es cuestión de un par de días y evita la mayoría de los sustos.
¿Qué framework conviene si empezamos de cero hoy?
Para E2E en web, Playwright es la opción con mejor integración con agentes y la que más trabajo de herramientas tiene detrás ahora mismo. Para tests unitarios, lo que ya use vuestro stack: aquí la elección de framework importa mucho menos que la disciplina de revisar lo que se genera.
¿Cómo se mide si esto está funcionando?
Con dos números, no con el porcentaje de cobertura: cuántos bugs llegan a producción por versión publicada, y cuánto tiempo pasa entre que alguien abre un PR y se fusiona. Si lo primero baja y lo segundo también, está funcionando. Si solo baja lo segundo, lo que habéis acelerado es la entrega de errores.
Conclusión
La IA no ha hecho que el testing deje de ser trabajo; ha hecho que deje de ser trabajo aburrido. La parte mecánica —escribir el test de partida, inventar datos de prueba, buscar patrones conocidos de vulnerabilidad, arreglar un selector que cambió— se delega hoy con resultados consistentes, y eso libera horas que antes no existían.
Lo que no ha cambiado es quién responde. Decidir qué riesgo se acepta, qué regla de negocio es correcta y qué se publica un viernes por la tarde sigue siendo una conversación entre personas. Los equipos a los que esto les está saliendo bien son los que han usado las horas liberadas para probar mejor los flujos críticos, no para generar más tests.
Si quieres saber en qué estado está de verdad la cobertura de tu proyecto —o si has heredado una plataforma sin un solo test y no sabes por dónde empezar—, cuéntanos el caso y te damos un diagnóstico antes de proponerte nada.