La mayor parte del código que hoy corre en producción en tu empresa no lo ha escrito tu equipo. En un proyecto Symfony o Laravel medio, entre el 80 % y el 90 % de las líneas que acaban en el servidor vienen de paquetes de terceros. En un frontend con React o Vue la proporción es todavía más brutal: un package-lock.json normal declara entre 900 y 1.800 paquetes, y ninguna persona del equipo ha leído ni el 1 % de ese código. Esa es, hoy, la mayor superficie de ataque de cualquier plataforma web: no el código propio, sino la cadena de suministro que lo alimenta.
Durante años la auditoría de seguridad se ha centrado en lo que el equipo escribe —inyecciones, control de acceso, gestión de sesiones— y ha tratado las dependencias como una caja negra que «ya se actualizará». Ese enfoque se ha roto. Los ataques de supply chain han pasado de anécdota a vector preferente porque tienen un retorno desproporcionado: comprometer un paquete con dos millones de descargas semanales da acceso a miles de organizaciones a la vez, sin tener que atacar a ninguna directamente.
Este artículo es la guía práctica de auditoría de dependencias de software que usamos en Keliam cuando entramos en una plataforma heredada o cuando montamos el control continuo de un cliente: cómo construir el inventario real (SBOM), cómo funcionan de verdad composer audit y npm audit, qué hacer con el ruido que generan, cómo priorizar con criterios que no colapsen al equipo, cómo meterlo en CI/CD sin bloquear el negocio y qué exigen ISO 27001, el ENS, NIS2 y el Cyber Resilience Act. Al final tienes un checklist reutilizable.
1. Qué es realmente la cadena de suministro de software
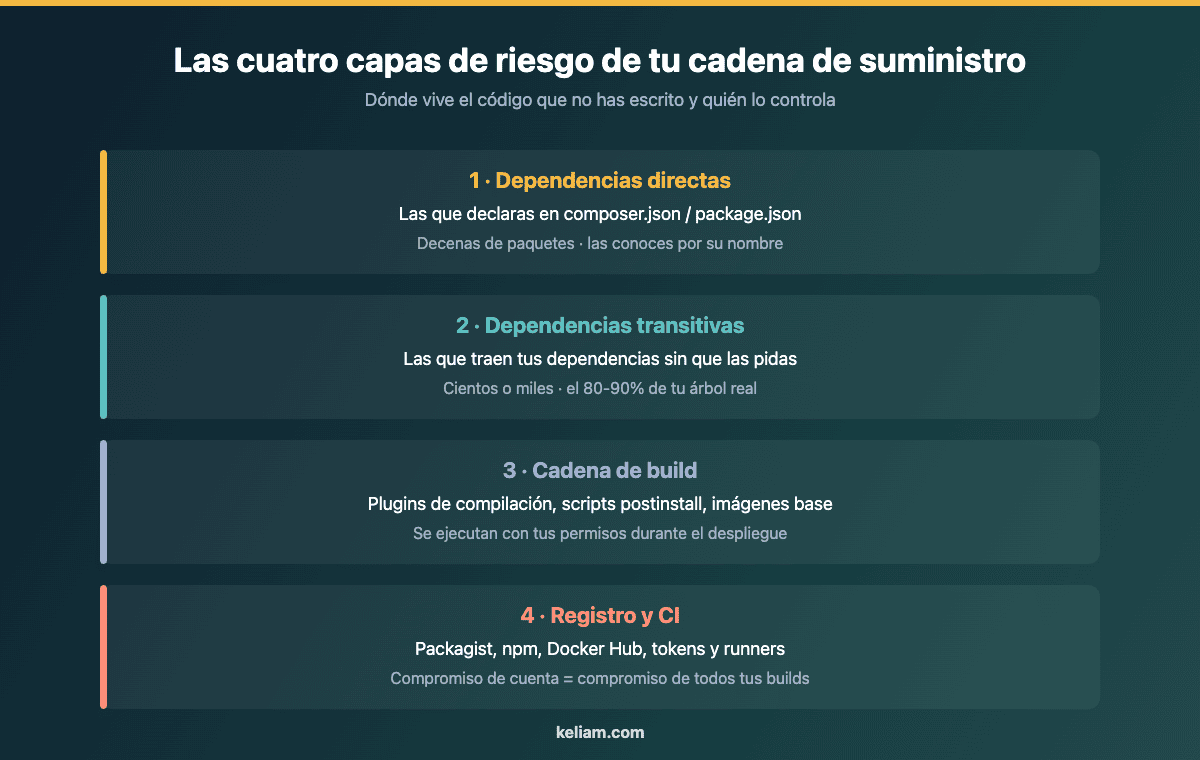
Cuando hablamos de cadena de suministro no hablamos solo de la lista de paquetes que aparece en tu fichero de manifiesto. Hablamos de todo lo que entra en el artefacto final y de todo lo que se ejecuta para producirlo. Eso incluye cuatro capas con perfiles de riesgo muy distintos, y confundirlas es el primer error de casi todas las auditorías improvisadas.
1.1 Directas, transitivas, build y registro
Dependencias directas son las que has declarado tú. Son pocas, las conoces por su nombre y normalmente hay alguien en el equipo que puede justificar por qué están. Es la capa que todo el mundo revisa.
Dependencias transitivas son las que arrastran tus dependencias directas. Son la inmensa mayoría del árbol y nadie las ha elegido conscientemente. Aquí es donde vive el grueso del riesgo real: una vulnerabilidad crítica en una librería de parseo de fechas que está seis niveles por debajo de tu framework es tan explotable como si la hubieras instalado a mano.
Cadena de build son los plugins de compilación, los scripts postinstall, los bundlers, las imágenes base de Docker y las acciones de CI. Este código no acaba necesariamente en producción, pero se ejecuta con los permisos de tu pipeline, que suele tener credenciales de despliegue. Un script postinstall malicioso no necesita llegar al servidor: le basta con leer las variables de entorno del runner.
Registro y CI son Packagist, npm, Docker Hub, los tokens de publicación y los propios runners. Si comprometen la cuenta de un mantenedor o el token de publicación de un paquete, la firma del atacante es indistinguible de la legítima hasta que alguien mira el diff.
1.2 Los cinco tipos de hallazgo que buscas
Una auditoría de dependencias completa no busca solo CVEs. Busca cinco cosas distintas, y cada una se resuelve de forma diferente:
- Vulnerabilidades conocidas. El paquete tiene un aviso de seguridad publicado y tu versión está en el rango afectado. Se resuelve actualizando o aplicando una mitigación.
- Paquetes abandonados. Sin commits ni releases en 18-24 meses, mantenedor único, issues sin respuesta. No hay CVE hoy, pero cuando lo haya no habrá parche. Se resuelve sustituyendo o asumiendo el mantenimiento.
- Riesgo de suplantación. Nombres parecidos a paquetes populares (typosquatting), paquetes que aparecieron hace tres semanas y ya tienen 40.000 descargas, cambios recientes de mantenedor. Se resuelve con revisión manual y política de allowlist.
- Conflictos de licencia. GPL en un producto propietario, licencias no estándar, paquetes sin licencia declarada. Es riesgo legal, no técnico, pero aparece siempre en una due diligence.
- Deriva de versiones. Dependencias tan atrasadas que actualizar ya no es un bump, es un proyecto. Es el hallazgo que más presupuesto consume y el que menos urgencia aparente tiene.
2. Por qué la industria cambió de enfoque: tres casos que marcaron el estándar
No hace falta un catálogo exhaustivo de incidentes para entender el patrón. Con tres basta.
event-stream (2018). Un mantenedor cansado cedió el control de un paquete npm muy popular a un voluntario que se ofreció por email. El nuevo mantenedor publicó una versión con una dependencia adicional ofuscada que buscaba carteras de criptomonedas en el entorno. El código malicioso no estaba en event-stream, estaba en una dependencia suya, y solo se activaba en un contexto muy concreto. Lección: la transferencia de mantenimiento es un evento de seguridad, y el análisis estático superficial no lo detecta.
ua-parser-js (2021). Compromiso de la cuenta npm del mantenedor y publicación de tres versiones con un minero y un ladrón de credenciales en el preinstall. Estuvieron disponibles unas horas. Millones de instalaciones semanales. Lección: la ventana de exposición puede ser de horas, así que un escaneo trimestral no sirve de nada; hace falta control en cada instalación.
xz/liblzma (2024). Una operación de ingeniería social sostenida durante casi tres años: un colaborador ganó confianza, obtuvo permisos de mantenimiento y coló una puerta trasera en los artefactos de release —no en el repositorio— que comprometía la autenticación SSH en distribuciones Linux. Se detectó por casualidad, midiendo latencias anómalas. Lección: lo que auditas debe ser el artefacto que despliegas, no el código fuente que crees que corresponde.
El hilo común es que ninguno de estos ataques se detecta leyendo el changelog. Se detectan con inventario, con detección de cambios anómalos y con procedimientos que asumen que un paquete legítimo puede volverse hostil en cualquier momento. Es exactamente la misma lógica que aplicamos al desarrollo seguro según ISO 27001 y el ENS: controles en el proceso, no confianza en el proveedor.
3. El inventario: SBOM, o no sabes qué estás protegiendo
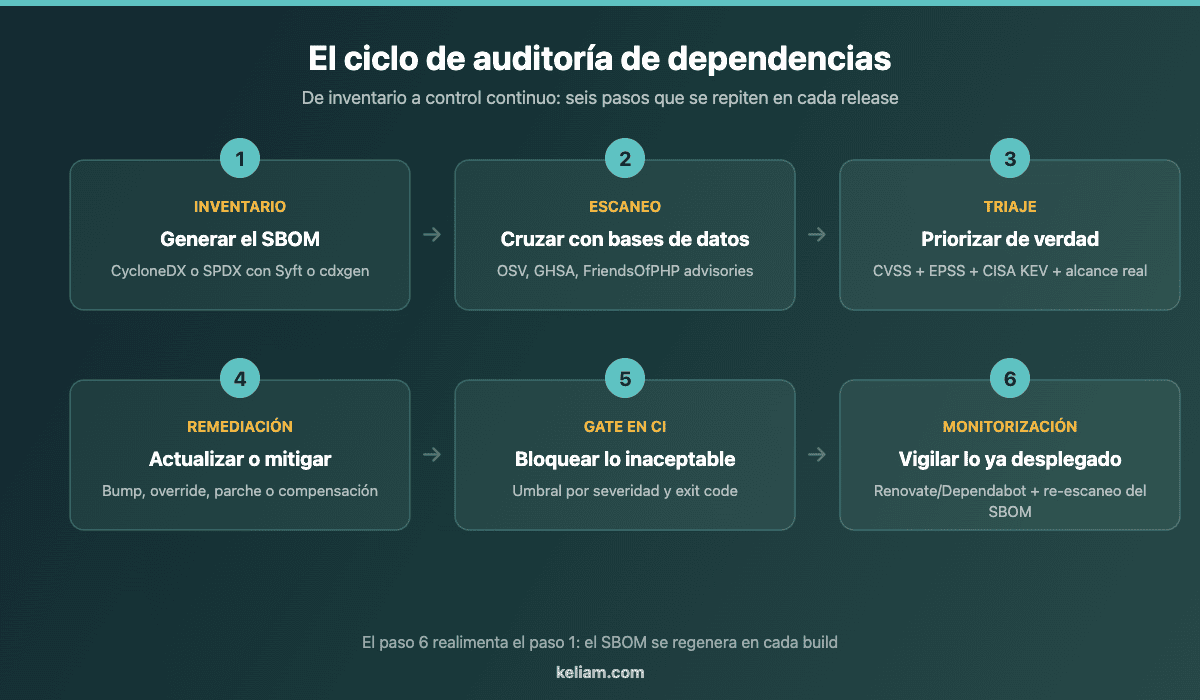
Un SBOM (Software Bill of Materials) es la lista de materiales de tu software: qué componentes lo forman, en qué versión, con qué licencia y con qué relación entre ellos. Suena burocrático y durante años lo fue, pero es la pieza que convierte la auditoría de dependencias de una anécdota puntual en un proceso repetible.
La prueba de fuego es sencilla: cuando mañana se publique una vulnerabilidad crítica en una librería cualquiera, ¿cuánto tardas en responder a «¿nos afecta, en qué proyectos y en qué versiones desplegadas»? Si la respuesta se mide en días y requiere que alguien se conecte a cada servidor, no tienes inventario. Con un SBOM por artefacto y por release, la respuesta es una consulta de segundos.
3.1 CycloneDX o SPDX: cuál elegir
Hay dos formatos estándar y ambos son válidos. CycloneDX (OWASP) nació orientado a seguridad: es más ligero, tiene un modelo de datos pensado para vulnerabilidades y es el que mejor soporte tiene en herramientas de escaneo. SPDX (Linux Foundation, norma ISO/IEC 5962) nació orientado a cumplimiento de licencias y es el que suelen pedir los departamentos legales y las administraciones.
Recomendación práctica: genera CycloneDX como formato de trabajo interno y ten la capacidad de exportar SPDX cuando te lo pidan en una licitación o una due diligence. Casi todas las herramientas convierten entre ambos.
3.2 Cómo generar el SBOM en la práctica
En un proyecto PHP con Composer:
# Plugin oficial CycloneDX para Composer
composer require --dev cyclonedx/cyclonedx-php-composer
composer CycloneDX:make-sbom --output-file=sbom.json --output-format=JSON
En un proyecto Node:
# cdxgen soporta npm, pnpm, yarn y monorepos
npx @cyclonedx/cdxgen -o sbom.json

# alternativa nativa (formato propio, convertible)
npm sbom --sbom-format cyclonedx > sbom.json
Y para el artefacto real, que es lo que de verdad importa —la imagen que despliegas, no el repositorio—:
# Syft analiza imágenes de contenedor, directorios y binarios
syft mi-registro/mi-app:1.14.2 -o cyclonedx-json=sbom-imagen.json
Fíjate en la diferencia entre los dos últimos: el SBOM del repositorio te dice qué has declarado; el SBOM de la imagen te dice qué has desplegado, incluyendo paquetes del sistema operativo, binarios copiados y todo lo que la imagen base arrastra. En una auditoría seria se generan ambos y se comparan. Las discrepancias son, casi siempre, los hallazgos más interesantes.
3.3 Qué hacer con el SBOM una vez generado
Un SBOM que se genera y se descarta no sirve. Tres reglas mínimas:
- Uno por release, versionado y guardado. El SBOM debe ser un artefacto de build como el binario, con la misma trazabilidad. Si no puedes recuperar el SBOM de la versión que estaba en producción hace cuatro meses, no puedes responder a un incidente retroactivo.
- Adjunto al artefacto, no en un Drive. Idealmente firmado y publicado junto a la imagen (por ejemplo como attestation en el registro).
- Con VEX cuando el volumen lo justifique. VEX (Vulnerability Exploitability eXchange) es el documento que dice «esta CVE aparece en mi SBOM pero no me afecta, y este es el motivo». Es lo que evita que el equipo tenga que re-justificar cincuenta falsos positivos en cada escaneo.
¿Sabes qué hay dentro de tu plataforma?
En Keliam levantamos el inventario real de dependencias de tu proyecto, generamos el SBOM, priorizamos los hallazgos por riesgo explotable y te dejamos el control funcionando dentro de tu pipeline. Sin frenar las entregas.
4. Auditoría en PHP: composer audit a fondo
Desde Composer 2.4 existe composer audit, y desde la 2.6 se ejecuta automáticamente tras composer update. Es el punto de partida obligatorio en cualquier proyecto PHP, Symfony, Laravel, Drupal o WooCommerce con dependencias gestionadas.
4.1 Cómo funciona por dentro
Composer consulta el repositorio de avisos de seguridad de Packagist, alimentado principalmente por la base de datos de FriendsOfPHP y por los avisos de GitHub. Compara las versiones de tu composer.lock con los rangos afectados y devuelve los que coinciden. Importante: audita el lock, no el manifiesto, así que el resultado refleja lo que realmente se instalaría.
# Auditoría estándar (directas + transitivas)
composer audit

# Solo dependencias de producción
composer audit --no-dev

# Salida procesable para CI
composer audit --format=json

# Incluir paquetes abandonados como fallo
composer audit --abandoned=report
4.2 Códigos de salida y uso en CI
El detalle que más se olvida: composer audit devuelve exit code 0 si no hay hallazgos y distinto de 0 si los hay. Eso es lo que permite convertirlo en una puerta de calidad sin escribir código adicional. En un pipeline basta con no capturar el error para que el job falle.
Ahora bien, fallar ante cualquier hallazgo de cualquier severidad es la receta para que en tres semanas alguien añada || true y el control deje de existir. Más adelante vemos cómo definir umbrales razonables.
4.3 Prevención: roave/security-advisories
Complemento muy recomendable en proyectos PHP: el paquete roave/security-advisories es un metapaquete sin código que declara conflictos con todas las versiones vulnerables conocidas. Instalado como dependencia de desarrollo, hace que Composer se niegue a instalar una versión vulnerable, en vez de instalarla y avisarte después.
composer require --dev roave/security-advisories:dev-latestEs prevención en el momento de la resolución, que es infinitamente más barata que la remediación posterior. El coste es que a veces bloquea una actualización legítima porque el aviso es más amplio que el problema real; en esos casos se documenta la excepción y se sigue.
4.4 Deriva de versiones: composer outdated
La auditoría de seguridad no ve el riesgo de obsolescencia. Para eso:
# Solo dependencias directas, con versiones mayores disponibles
composer outdated --direct --major-only
Si esa lista tiene veinte entradas con saltos de dos versiones mayores, tienes un problema de gestión de controles técnicos antes que un problema de vulnerabilidades: cuando aparezca la CVE crítica, no vas a poder actualizar en 48 horas.
5. Auditoría en JavaScript: npm audit y el problema del ruido
En el ecosistema Node la situación es más incómoda. npm audit existe desde hace años y es útil, pero genera un volumen de hallazgos que satura a los equipos y que, en un porcentaje alto, no representa riesgo explotable en el contexto real de la aplicación.
5.1 Los comandos que importan
# Auditoría completa
npm audit

# Solo lo que llega a producción (clave para bajar el ruido)
npm audit --omit=dev

# Solo a partir de severidad alta
npm audit --audit-level=high

# Salida JSON para procesar en CI
npm audit --json

# Arreglo automático conservador (respeta semver)
npm audit fix

# Arreglo agresivo: puede romper cosas. Nunca en CI.
npm audit fix --force
Regla dura: npm audit fix --force jamás se ejecuta de forma automática ni en un pipeline. Aplica cambios de versión mayor sin preguntar y es una de las causas más habituales de «funcionaba ayer» en proyectos frontend.
5.2 Por qué npm audit exagera y qué hacer
Tres razones estructurales. Primera: cuenta cada ruta del grafo, así que una vulnerabilidad en un paquete profundo se reporta tantas veces como caminos lleven a él. Segunda: no distingue si el código vulnerable es alcanzable desde tu aplicación; una vulnerabilidad de ReDoS en un parser que solo usa la herramienta de build durante la compilación no es lo mismo que en un endpoint público. Tercera: incluye devDependencies por defecto, y el grueso del árbol de un frontend moderno es tooling.
El primer filtro, casi gratis, es --omit=dev. En proyectos reales suele reducir el recuento entre un 60 % y un 80 %. El segundo filtro es usar un escáner con análisis de alcanzabilidad. El tercero es el triaje humano documentado, que veremos en la sección 7.
5.3 Cuando no puedes esperar al mantenedor: overrides
El caso clásico: una dependencia transitiva es vulnerable, existe versión parcheada, pero el paquete intermedio la fija con un rango estricto y su mantenedor no responde. En npm 8.3+ se resuelve forzando la resolución:
{
  "overrides": {
    "libreria-vulnerable": "2.4.7"
  }
}
En Yarn el campo equivalente es resolutions; en pnpm, pnpm.overrides. Es una herramienta legítima y a menudo la única salida rápida, pero deja el proyecto en un estado no soportado por el paquete intermedio: hay que anotarlo, ponerle fecha de revisión y quitarlo cuando el mantenedor publique. Un overrides olvidado durante dos años es deuda técnica silenciosa.
5.4 Alternativas mejores: OSV-Scanner
Si solo puedes incorporar una herramienta nueva a tu proceso, que sea OSV-Scanner. Consulta la base de datos OSV.dev, que es agregada, abierta y multi-ecosistema, y trabaja directamente sobre ficheros de lock:
# Escanea todos los lockfiles que encuentre, recursivamente
osv-scanner scan source -r ./

# Escanear un SBOM ya generado
osv-scanner scan source --sbom=sbom.json

# Escanear una imagen de contenedor
osv-scanner scan image mi-registro/mi-app:1.14.2
Ventaja principal: unifica PHP, JavaScript, Python, Go, Rust y paquetes de sistema operativo en un único informe con un único criterio, lo cual es imprescindible en cuanto tienes más de un stack. En versiones recientes incorpora además análisis de alcanzabilidad para algunos ecosistemas, que es justo el filtro que le falta a npm audit.
6. Herramientas: qué usar para qué
El error habitual es acumular herramientas que hacen lo mismo. Cada una tiene un hueco concreto:
| Herramienta | Para qué sirve | Dónde encaja |
|---|---|---|
| composer audit | Vulnerabilidades en el lock de PHP | Local y CI, coste cero |
| npm / pnpm / yarn audit | Vulnerabilidades en el lock de Node | Local y CI, con --omit=dev |
| OSV-Scanner | Escaneo multi-ecosistema unificado | Informe consolidado de toda la organización |
| Syft | Generación de SBOM de imágenes y binarios | Paso de build, antes de publicar el artefacto |
| Grype / Trivy | Escaneo de imágenes de contenedor completas | Registro y despliegue; cubren el sistema operativo |
| Dependabot | PRs automáticos de actualización y alertas | Repositorios en GitHub, coste cero |
| Renovate | Actualizaciones con políticas finas y agrupación | Cuando Dependabot se queda corto o no usas GitHub |
| roave/security-advisories | Bloqueo preventivo en PHP | Resolución de dependencias, antes de instalar |
Un stack mínimo viable y gratuito para una pyme: composer audit + npm audit --omit=dev en CI, Syft generando SBOM por release, OSV-Scanner semanal sobre todos los repositorios y Renovate agrupando actualizaciones de parche automáticamente. Se monta en una tarde y cubre el 80 % del problema.
7. Triaje: cómo priorizar sin colapsar al equipo
Aquí es donde se decide si la auditoría de dependencias funciona o se convierte en un informe que nadie lee. Un escaneo inicial en un proyecto de cuatro años devuelve rutinariamente entre 80 y 300 hallazgos. Tratarlos todos por igual garantiza que no se trate ninguno.
7.1 CVSS no es suficiente
El CVSS mide severidad técnica en abstracto, no probabilidad de explotación ni impacto en tu contexto. Una vulnerabilidad 9.8 en una función que tu código nunca invoca es menos urgente que una 6.5 en la librería que procesa las peticiones de tu API pública. Usa CVSS como filtro grueso, nunca como criterio único.
7.2 Los tres criterios que sí ordenan la cola
- EPSS. Probabilidad estimada de que una vulnerabilidad se explote en los próximos 30 días. Un EPSS alto sobre una severidad media urge más que un CVSS 9 con EPSS de 0,1 %.
- CISA KEV. El catálogo de vulnerabilidades conocidas y explotadas activamente. Si un hallazgo está en KEV, deja de ser un ticket de backlog y pasa a ser una incidencia. Sin discusión.
- Alcanzabilidad y exposición. ¿El componente vulnerable está en el camino de una petición de usuario? ¿Es accesible desde internet? ¿Requiere autenticación previa? Un hallazgo en una herramienta de build que solo corre en el runner tiene un perfil de riesgo completamente distinto al de una librería en el borde, y merece un tratamiento distinto —el mismo razonamiento que aplicas al proteger la superficie de tus APIs REST.
7.3 Una matriz de decisión que funciona
| Situación | Plazo | Acción |
|---|---|---|
| En KEV + componente expuesto | 24-48 h | Parche de emergencia o mitigación compensatoria |
| Crítica/alta + alcanzable desde producción | 7 días | Actualización planificada en el sprint en curso |
| Alta pero no alcanzable | 30 días | Cola normal, documentar el motivo (VEX) |
| Media/baja en dependencia de desarrollo | Trimestral | Agrupar en una actualización de mantenimiento |
| Sin parche disponible | Inmediato | Evaluar mitigación, WAF, sustitución o aceptación formal |
Lo importante no son los plazos exactos —cada organización ajusta los suyos— sino que estén escritos y aprobados antes del primer escaneo. Definir la política después de ver los resultados es la forma más rápida de que la política se acomode a lo que ya hay.
8. Integrar la auditoría en el ciclo de desarrollo
Una auditoría de dependencias que se ejecuta a mano cuando alguien se acuerda tiene una vida útil de dos semanas. El objetivo es que el control viva en el pipeline y sea invisible mientras todo va bien.
8.1 Un pipeline de ejemplo
name: Auditoría de dependencias

on:
  pull_request:
  schedule:
    - cron: '0 6 * * 1'

jobs:
  audit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Auditoría PHP
        run: composer audit --no-dev --format=json > audit-php.json

      - name: Auditoría Node (producción)
        run: npm audit --omit=dev --audit-level=high

      - name: Generar SBOM
        run: syft dir:. -o cyclonedx-json=sbom.json

      - name: Escaneo unificado OSV
        run: osv-scanner scan source --sbom=sbom.json

      - name: Publicar SBOM como artefacto
        uses: actions/upload-artifact@v4
        with:
          name: sbom
          path: sbom.json
Tres decisiones de diseño importantes en ese fichero. Se ejecuta en cada pull request, para que el coste de un hallazgo lo pague quien lo introduce y no el equipo dentro de seis meses. Se ejecuta también semanalmente sobre la rama principal, porque una dependencia que era segura el lunes puede dejar de serlo el jueves sin que nadie toque el código. Y el SBOM se publica como artefacto, que es lo que permite responder a un incidente retroactivo.
8.2 El gate: qué bloquea y qué solo avisa
Un umbral que funciona en la mayoría de equipos:
- Bloquea el merge: hallazgos críticos o altos en dependencias de producción, y cualquier hallazgo presente en CISA KEV.
- Avisa sin bloquear: hallazgos medios, y cualquier severidad en dependencias de desarrollo.
- Informe sin ruido: bajas y paquetes abandonados, revisados en la reunión de mantenimiento mensual.
Y una regla de proceso que vale más que el propio umbral: debe existir una vía documentada de excepción, con responsable, motivo y fecha de caducidad. Si saltarse el gate legítimamente es imposible, el equipo aprenderá a saltárselo ilegítimamente.
8.3 Procedencia y firma: el siguiente escalón
Escanear vulnerabilidades conocidas no protege del ataque de xz: código malicioso deliberadamente introducido, sin CVE, sin aviso. Contra eso el control es la procedencia: poder demostrar que el artefacto que despliegas se construyó a partir del código fuente que crees, en un pipeline concreto.
Las piezas prácticas hoy son npm provenance (paquetes publicados desde CI con atestación verificable), Sigstore/cosign para firmar imágenes y artefactos, y los niveles de SLSA como marco de referencia para saber en qué escalón estás. Para una pyme, el objetivo realista a corto plazo es: builds reproducibles desde CI, artefactos firmados y verificación de firma en el despliegue. No es exótico y evita toda una familia de ataques.
9. Qué te van a exigir: ISO 27001, ENS, NIS2 y el CRA
La auditoría de dependencias ha dejado de ser una buena práctica opcional para convertirse en requisito normativo. Un resumen de qué pide cada marco:
ISO 27001:2022. El control 8.28 (codificación segura) y los controles 5.19 a 5.23 (seguridad en las relaciones con proveedores, incluyendo servicios TIC) obligan a gestionar el riesgo de los componentes de terceros. En una auditoría de certificación, la pregunta concreta es «enséñame el inventario y el registro de tratamiento de vulnerabilidades de terceros».
ENS. Las medidas del marco operacional relativas a la gestión de la configuración y a la adquisición de nuevos componentes aplican directamente a las librerías de terceros. En categoría media y alta se espera control documentado, no buena voluntad.
NIS2. Es la que ha movido el mercado: la seguridad de la cadena de suministro es una de las medidas mínimas exigidas explícitamente, y la responsabilidad alcanza al órgano de dirección. Si tu empresa está en el ámbito de aplicación, esto ya no es una conversación técnica. Lo desarrollamos en detalle en el análisis de las obligaciones de NIS2 para empresas tecnológicas.
Cyber Resilience Act. El reglamento europeo de productos con elementos digitales incorpora la obligación de mantener un SBOM y de gestionar vulnerabilidades durante el periodo de soporte, con obligaciones de notificación. Su calendario de aplicación escalonado hace que el trabajo de inventario que empieces hoy sea exactamente el que te van a pedir.
El denominador común de los cuatro es el mismo: inventario, evaluación y registro de decisiones. Si montas el proceso técnico bien, el cumplimiento sale casi gratis; si lo montas solo para cumplir, tendrás papeles y seguirás expuesto.
10. Errores que vemos una y otra vez
- Auditar el manifiesto en vez del lock. El manifiesto declara rangos; el lock declara realidad. Todas las herramientas serias trabajan sobre el lock.
- No auditar el artefacto final. El repositorio limpio no dice nada de la imagen base con 40 paquetes de sistema sin parchear.
- Ejecutar
audit fix --forceen CI. Rompe producción antes o después, y el equipo acaba desconfiando de todo el proceso. - Ignorar las devDependencies por completo. Bajarles la prioridad es correcto; ignorarlas no: se ejecutan en el pipeline, que tiene credenciales.
- Bloquear todo desde el primer día. Un gate que falla en el 100 % de los PRs se desactiva en una semana. Se empieza avisando, se mide, y se sube el listón por fases.
- Tratar el SBOM como un entregable de una vez. Un SBOM de hace ocho meses es un documento histórico, no un control.
- Confundir «sin CVEs» con «seguro». Los paquetes abandonados, las dependencias con un único mantenedor y el código propio siguen ahí. Por eso la auditoría de dependencias complementa, pero no sustituye, a una revisión del código propio y de las vulnerabilidades web del OWASP Top 10.
- No mirar las licencias. Aparece siempre en la due diligence, y siempre tarde.
11. Checklist de auditoría de dependencias
Este es el guion que puedes ejecutar tal cual sobre un proyecto propio o heredado:
- Inventario. Generar SBOM del repositorio y del artefacto desplegado. Comparar y explicar las diferencias.
- Escaneo base.
composer audit,npm audit --omit=devy OSV-Scanner sobre todos los lockfiles. - Escaneo de imagen. Trivy o Grype sobre la imagen final, incluyendo paquetes de sistema operativo.
- Enriquecimiento. Cruzar hallazgos con EPSS y con el catálogo KEV.
- Alcanzabilidad. Marcar qué hallazgos afectan a código realmente invocado desde producción.
- Obsolescencia.
composer outdated --direct --major-onlyy equivalente en Node; estimar el esfuerzo de ponerse al día. - Salud de los paquetes. Última release, número de mantenedores, actividad, cambios recientes de propiedad.
- Licencias. Detectar copyleft en producto propietario y paquetes sin licencia declarada.
- Política. Escribir umbrales, plazos y vía de excepción. Aprobarlos con negocio, no solo con IT.
- Automatización. Gate en PR, escaneo semanal programado, SBOM publicado por release.
- Actualización continua. Renovate o Dependabot con agrupación de parches y automerge de lo trivial con tests verdes.
- Revisión. Punto fijo mensual de 30 minutos: hallazgos nuevos, excepciones caducadas, deuda de versiones.
Conclusión
La auditoría de dependencias no va de ejecutar npm audit y mirar el número rojo. Va de construir el inventario de lo que realmente despliegas, de tener criterios escritos para decidir qué es urgente y qué no, y de automatizar el control para que no dependa de que alguien se acuerde. Las herramientas que hemos repasado son casi todas gratuitas y se integran en una tarde; lo caro es la política y la disciplina, y es también lo que marca la diferencia entre una organización que responde a un incidente de supply chain en horas y otra que se entera por un cliente.
Si tu plataforma lleva años acumulando dependencias y nadie sabe muy bien qué hay dentro, el orden es siempre el mismo: primero el inventario, luego el triaje, y solo entonces las actualizaciones. Empezar por actualizar sin saber qué tienes es la forma más eficaz de romper producción y no reducir riesgo.
Preguntas frecuentes
¿Cada cuánto hay que auditar las dependencias?
En cada pull request para lo que se introduce nuevo, y al menos semanalmente sobre la rama principal. Las vulnerabilidades aparecen sin que tú toques el código, así que un escaneo trimestral deja ventanas de exposición de meses.
¿Es obligatorio tener un SBOM?
Depende del marco que te aplique. Con el Cyber Resilience Act pasa a ser una obligación para productos con elementos digitales comercializados en la UE, y en contratación pública y due diligence ya se pide de facto. Aunque no te aplique hoy, es la pieza que hace operativo todo lo demás.
¿Qué hago si una dependencia vulnerable no tiene parche?
Cuatro salidas, por orden de preferencia: sustituir el paquete, aplicar un override a una versión corregida de la transitiva, mitigar en otra capa (WAF, validación de entrada, restricción de la funcionalidad afectada) o aceptar formalmente el riesgo con firma del responsable y fecha de revisión. Lo que no vale es dejarlo en el informe sin decisión.
¿Dependabot es suficiente para una pyme?
Como punto de partida sí, sobre todo por las alertas y los PRs automáticos. Se queda corto en dos cosas: no genera SBOM y no consolida varios repositorios y ecosistemas en una única foto. Complementarlo con Syft y OSV-Scanner cubre esos dos huecos sin coste de licencia.
¿Auditar dependencias sustituye a un pentest?
No. Son capas distintas: la auditoría de dependencias cubre el código de terceros y las vulnerabilidades conocidas; el pentest cubre la explotabilidad real de tu aplicación completa, incluida la lógica de negocio y la configuración. Se complementan, y en una plataforma WordPress o ecommerce con muchos plugins de terceros, ambas son necesarias.