La escena se repite en todas las empresas que acaban de certificarse. El auditor firma, llega el certificado, se cuelga en la web y alguien manda un correo de agradecimiento al equipo. Y entonces, sin que nadie lo decida explícitamente, el proyecto se cierra: la carpeta de evidencias deja de actualizarse, el análisis de riesgos se queda con la foto de hace ocho meses y el responsable de seguridad vuelve a sus tareas de siempre. Once meses después, cuando el CCN o la entidad certificadora anuncia la auditoría de seguimiento, empieza la carrera para reconstruir un año de registros en tres semanas.
Ese patrón —trabajar por picos alrededor de las auditorías— es exactamente lo contrario de lo que pide el Esquema Nacional de Seguridad. El ENS no está diseñado como un examen que se aprueba, sino como un sistema de gestión que se recorre en ciclos: el Real Decreto 311/2022 habla de reevaluación periódica, de mejora continua y de adecuación permanente de las medidas al nivel de riesgo real. La certificación es una foto en un instante; lo que se certifica es un proceso que se supone vivo.
Este capítulo es el pilar del sub-cluster de mejora continua, y trata de la parte que casi nunca aparece en los pliegos ni en las presentaciones comerciales: cómo se convierte el cumplimiento en un mecanismo que se sostiene solo. Veremos por qué el checkbox compliance falla incluso cuando pasa la auditoría, cómo se aplica el ciclo PDCA a la seguridad de la información sin convertirlo en burocracia, qué significa madurar por niveles en lugar de estar «conforme» o «no conforme», qué indicadores se pueden llevar a un comité sin aburrir a nadie, cómo se construye cultura de seguridad en equipos técnicos que ya van justos de tiempo, y cómo se monta un calendario de revisiones y auditorías internas que funcione. Cerramos con un caso práctico de dieciocho meses y con los errores que más caros salen.
Índice de la serie: mejora continua
- El ENS como motor de mejora continua — este capítulo
- Ciclo PDCA aplicado a la seguridad: del plan a la acción (próximamente)
- KPIs de seguridad: qué medir y cómo mejorar cada trimestre (próximamente)
Este sub-cluster cierra la serie de certificaciones, que empieza en la guía completa de ISO 27001 y continúa en la guía del Esquema Nacional de Seguridad.
1. El error del «checkbox compliance»
Llamamos checkbox compliance a tratar el ENS como una lista de casillas que hay que poder marcar el día de la auditoría. Es una estrategia racional a corto plazo: funciona, se certifica y cuesta menos que hacerlo bien. El problema es que produce una organización que parece segura en el papel y no lo es en la práctica, y que además acaba gastando más dinero del que se ahorró.
1.1 Por qué pasa la auditoría y aun así falla
Una auditoría de conformidad revisa evidencias, y las evidencias se pueden fabricar en un sprint. Se redacta la política de seguridad la semana antes, se genera el inventario de activos exportando el CMDB tal como esté, se imprime el registro de formación con la sesión que se hizo en enero y se presenta el plan de continuidad que nadie ha probado nunca. Todo eso es documentalmente correcto. El auditor comprueba que existe, no que se use.
La diferencia se ve cuando pasa algo de verdad. La organización que marcó casillas tiene un procedimiento de gestión de incidentes que nadie ha leído, contactos desactualizados, copias de seguridad que se restauran por primera vez el día que hacen falta y un inventario que no incluye los tres servidores que montó el equipo de datos en marzo. La que trabaja en ciclos tiene lo mismo, pero probado: el procedimiento se ha ensayado, la restauración se verifica cada trimestre y el inventario se reconcilia contra lo que hay realmente desplegado.
1.2 El coste oculto del trabajo por picos
Concentrar el esfuerzo alrededor de las auditorías tiene un coste que rara vez se contabiliza porque se reparte entre departamentos. Estos son los cuatro conceptos que aparecen siempre:
- Reconstrucción de evidencias. Recuperar once meses de registros de acceso, de revisiones de permisos y de actas que no se levantaron cuesta, en las organizaciones que hemos acompañado, entre tres y seis semanas de una persona a tiempo parcial. Cada año.
- No conformidades repetidas. Cuando la causa raíz no se corrige y solo se tapa el síntoma, el mismo hallazgo reaparece en la siguiente auditoría. Las auditorías de seguimiento son especialmente duras con esto, porque el auditor revisa expresamente el cierre de lo anterior.
- Deriva de la configuración. Entre dos auditorías, los sistemas cambian: se abren reglas de firewall «temporales», se conceden permisos de administrador para un despliegue urgente, se levanta un entorno de pruebas con datos reales. Sin revisiones periódicas, esa deriva solo se detecta un año después, cuando ya es un problema grande.
- Riesgo real no cubierto. El más caro de todos, porque no se manifiesta como coste hasta que se manifiesta como incidente. Si tienes dudas sobre por dónde empezar a cerrarlo, el punto de partida honesto está en por dónde empezar con la ciberseguridad en una empresa.
1.3 La señal de alarma más fiable
Hay una pregunta que distingue a las dos organizaciones en treinta segundos: ¿cuándo fue la última vez que se actualizó el análisis de riesgos, y qué cambió a raíz de esa actualización?
Si la respuesta es «lo revisamos hace dos meses y bajamos el riesgo de tal activo porque metimos MFA, y subimos el de aquel otro porque ahora está expuesto a internet», el sistema está vivo. Si la respuesta es «lo hicimos para la certificación» o «está el documento, déjame que lo busque», el sistema está congelado, por muy válido que sea el certificado que cuelga en la web. La metodología de análisis de riesgos no es un entregable de proyecto: es el instrumento con el que se decide dónde se gasta el presupuesto de seguridad cada trimestre.
2. El ENS como sistema vivo
El Real Decreto 311/2022 está escrito, de principio a fin, en clave de proceso. Conviene leerlo con esa lente porque cambia bastante lo que uno cree que le están pidiendo.
2.1 Lo que el propio texto exige de forma continuada
Sin entrar en el articulado completo, hay cuatro ideas que atraviesan todo el esquema:
- La seguridad como proceso integral. No es un proyecto con fecha de fin, sino una función permanente con responsables nombrados y recursos asignados.
- Gestión de la seguridad basada en riesgos. Los riesgos cambian —cambia la exposición, cambian las amenazas, cambia el negocio—, así que la valoración tiene que rehacerse periódicamente y las medidas ajustarse en consecuencia.
- Reevaluación periódica. Las medidas se revisan para comprobar que siguen siendo eficaces, no solo que siguen estando.
- Mejora continua del proceso de seguridad. El esquema espera que el nivel de protección suba con el tiempo, no que se mantenga en el mínimo exigido indefinidamente.
A esto se suma el marco operacional, que en la práctica es donde se nota si el sistema vive o no: las medidas de planificación, control de acceso y monitorización solo tienen sentido si alguien mira lo que producen con una cadencia definida. Un SIEM que nadie revisa es un gasto, no un control.
2.2 Conformidad no es lo mismo que seguridad
Merece la pena decirlo explícitamente porque es la fuente de casi todos los malentendidos con dirección: estar conforme al ENS significa que tienes implantadas las medidas que corresponden a tu categoría (básica, media o alta) y que puedes demostrarlo. No significa que no te vayan a atacar, ni que el ataque no vaya a tener éxito.
La conformidad es un suelo, y además es un suelo calculado sobre una categorización que tú mismo has hecho. Si categorizaste a la baja para ahorrarte medidas —cosa que pasa más de lo que parece—, estás conforme con un listón que no corresponde al impacto real que tendría un incidente en tu servicio. La mejora continua es precisamente el mecanismo que va corrigiendo esa distancia entre el suelo formal y el riesgo real.
2.3 Dónde encaja esto si además tienes ISO 27001
Muchas empresas que trabajan con la administración acaban con las dos: el ENS por obligación contractual y la ISO 27001 por exigencia de clientes privados. La buena noticia es que el motor de mejora continua es común a las dos, y montarlo una sola vez sirve para ambas. La ISO 27001 lo formaliza en sus cláusulas de seguimiento, medición, auditoría interna, revisión por la dirección y no conformidades; el ENS lo exige de forma menos prescriptiva pero igual de real.
El mapeo concreto entre ambos marcos —qué controla uno que el otro no, dónde se solapan y cómo aprovechar una misma evidencia para las dos auditorías— lo desarrollamos en el capítulo puente ENS vs ISO 27001: diferencias, solapamientos y sinergias. Si estás en ese escenario dual, léelo antes de montar dos sistemas de gestión paralelos, que es el error caro clásico.
3. El ciclo PDCA aplicado a la seguridad
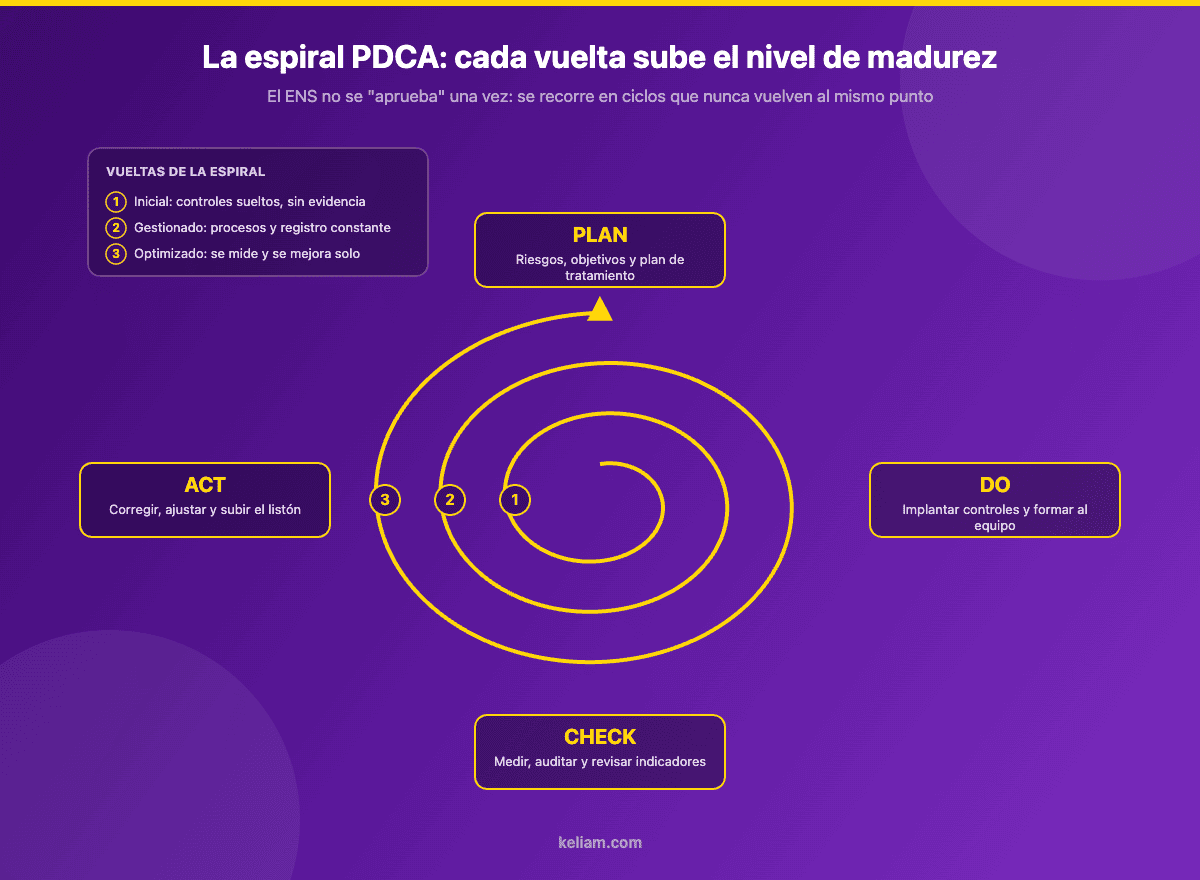
PDCA —Plan, Do, Check, Act— viene de la gestión de la calidad y tiene mala prensa entre perfiles técnicos porque suena a consultoría de los noventa. Merece una segunda oportunidad, porque es la única forma barata que conocemos de garantizar que las decisiones de seguridad se revisan en vez de acumularse.
La clave para que no degenere en burocracia es entender que no es un ciclo anual gigante, sino varios ciclos anidados de distinta frecuencia corriendo a la vez. Desarrollamos cada fase a fondo en el capítulo dedicado al ciclo PDCA aplicado a la seguridad (próximamente); aquí vemos el esqueleto y, sobre todo, cómo encajarlo en el calendario real de un equipo.
3.1 Plan: decidir en qué se gasta el próximo trimestre
La fase de planificación no es redactar documentos: es priorizar. Entra el análisis de riesgos actualizado, salen tres o cuatro objetivos concretos con responsable y fecha. «Mejorar la seguridad» no es un objetivo; «reducir a menos de 15 días el parcheo de vulnerabilidades críticas en los servidores de producción» sí lo es, porque se puede medir y se puede fallar.
Un error frecuente aquí es planificar veinte iniciativas simultáneas porque el análisis de riesgos ha dado veinte hallazgos. Con un equipo pequeño, tres objetivos por trimestre bien cerrados valen más que veinte a medias, que es lo que produce la sensación de que la seguridad «nunca avanza».
3.2 Do: implantar y, sobre todo, dejar rastro
Ejecutar los controles es la parte que los equipos técnicos hacen bien. La que se les atraganta es generar evidencia mientras se hace, en lugar de reconstruirla después. Y es una diferencia enorme de esfuerzo: registrar la revisión de permisos en el momento cuesta diez minutos; reconstruir quién revisó qué hace ocho meses puede costar dos días.
El truco que mejor funciona es no crear un sistema de evidencias aparte, sino sacarla de donde el equipo ya trabaja: tickets de Jira o Redmine con una etiqueta de seguridad, pull requests con revisor asignado, actas cortas en el mismo wiki del equipo, salidas automáticas de los escáneres guardadas en un bucket con retención. La evidencia que exige abrir otra herramienta no se genera.
3.3 Check: medir y auditar
Aquí entran los indicadores (sección 5) y las auditorías internas (sección 8). Lo importante conceptualmente es que Check tiene dos niveles distintos que suelen confundirse: la medición continua, que es automática y responde a «¿cómo vamos?», y la revisión periódica, que es humana y responde a «¿esto que estamos haciendo sirve para algo?».
Una organización puede tener excelentes métricas y un sistema inútil, si las métricas miden actividad en lugar de resultado. Medir «número de alertas procesadas» premia a quien genera ruido; medir «tiempo medio hasta detectar un incidente real» premia a quien reduce el ruido.
3.4 Act: cerrar el bucle de verdad
Es la fase que se salta casi todo el mundo, y es la que convierte el círculo en espiral. Act significa tomar lo aprendido en Check y cambiar algo estructural: modificar un procedimiento, reasignar presupuesto, subir el objetivo porque el anterior ya se cumple de sobra, o reconocer que un control no aporta y retirarlo.
Eso último importa más de lo que parece. Los sistemas de gestión tienden a acumular controles porque quitar da miedo, y acaban con procedimientos que nadie sigue porque son inviables. Retirar un control que no aporta —y documentar por qué— es una decisión de mejora continua tan legítima como añadir uno nuevo.
3.5 Las tres cadencias que funcionan en la práctica
Este es el reparto que recomendamos y que hemos visto sostenerse en el tiempo en equipos de entre cinco y cincuenta personas:
- Semanal (15 minutos). Revisión de alertas relevantes, parches críticos pendientes y cualquier incidente abierto. Puede ir pegado a una reunión que ya exista; no merece una reunión propia.
- Trimestral (media jornada). El PDCA completo: revisar indicadores, cerrar objetivos del trimestre anterior, actualizar los riesgos que hayan cambiado y fijar los tres objetivos siguientes. Es la reunión que sostiene todo el sistema.
- Anual (dos o tres jornadas). Análisis de riesgos completo, auditoría interna, revisión por la dirección, prueba real del plan de continuidad y actualización de la declaración de aplicabilidad.
Si solo puedes implantar una de las tres, implanta la trimestral. Sin ella, la semanal se convierte en apagar fuegos y la anual en reconstruir evidencias.
4. Un modelo de madurez progresiva
La conformidad es binaria: cumples o no cumples. La madurez no, y por eso es una herramienta de gestión mucho más útil para decidir dónde invertir. Dos organizaciones igualmente conformes pueden estar a años de distancia en capacidad real de resistir un incidente.
4.1 Los cinco niveles, en lenguaje de ingeniería
Adaptamos aquí la escala clásica de madurez de procesos al contexto de seguridad, que es como la usamos en nuestras auditorías:
- Inicial. La seguridad depende de que una persona concreta se acuerde. Funciona mientras esa persona esté. No hay procedimiento escrito ni registro.
- Repetible. Hay procedimientos escritos y se siguen casi siempre, pero dependen de la voluntad de cada uno y no dejan rastro consistente.
- Definido. Los procedimientos están integrados en el flujo de trabajo (pipeline, tickets, revisiones obligatorias) y generan evidencia automáticamente. Este es el nivel mínimo que consideramos sano para una empresa que da servicio a la administración.
- Gestionado. Además de ejecutarse, se mide: hay indicadores con objetivo, se revisan con cadencia y las desviaciones disparan acciones.
- Optimizado. Los datos de la medición alimentan cambios en el propio sistema. Se experimenta, se comparan resultados y se retiran controles que no aportan.
4.2 Cómo se usa de verdad: por dominios, no global
El error habitual es calcular «un nivel de madurez» para toda la organización. Ese número medio no sirve para decidir nada, porque esconde exactamente la información que necesitas: dónde está el punto débil.
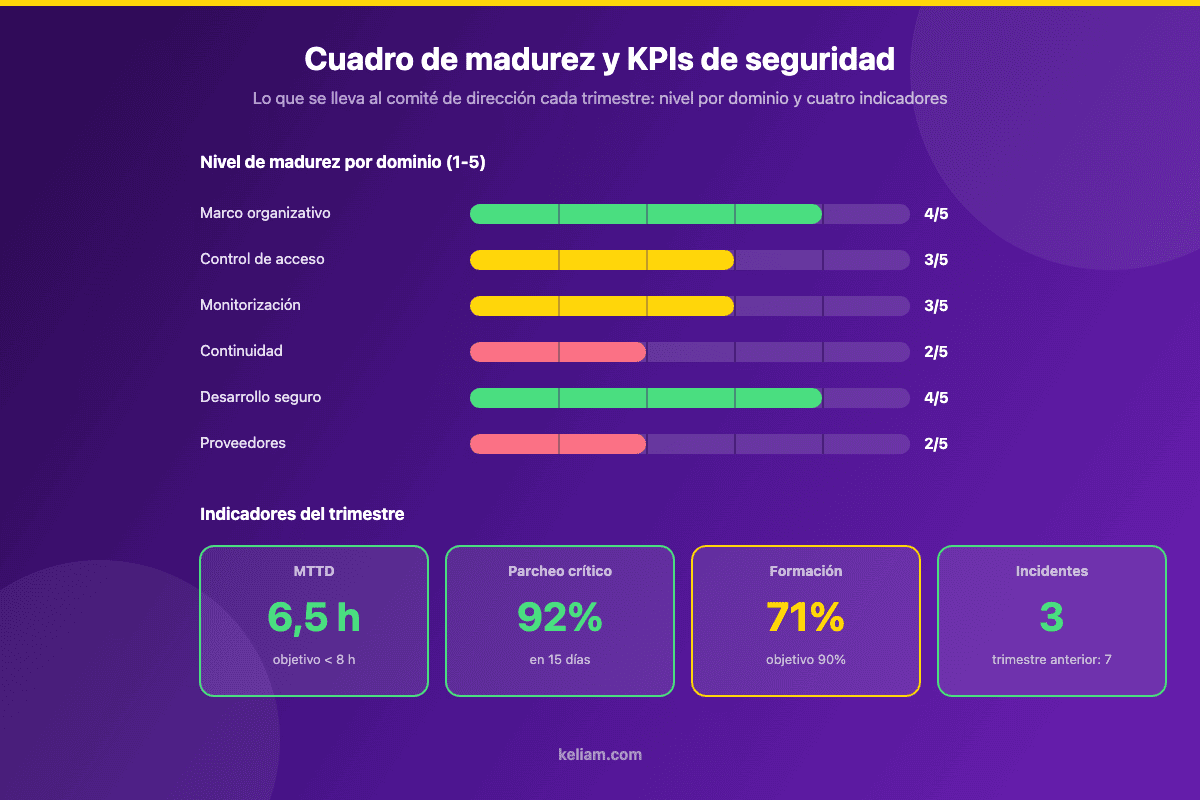
Lo útil es puntuar por dominio —marco organizativo, control de acceso, monitorización, continuidad, desarrollo seguro, gestión de proveedores— y mirar la forma del perfil. Una empresa con 4 en desarrollo seguro y 2 en continuidad no tiene «un 3 de media»: tiene un equipo técnico fuerte y un agujero de continuidad que le va a doler el día que falle un proveedor de infraestructura.
En los perfiles que más vemos, los dos dominios rezagados casi siempre son los mismos: continuidad (porque probar de verdad la restauración cuesta y nunca es urgente) y gestión de proveedores (porque implica exigir cosas a terceros con los que ya tienes contrato). No es casualidad: son los dos que no se pueden arreglar solo con trabajo técnico interno.
4.3 Subir un nivel al año, por dominio, es un objetivo realista
La ambición razonable no es «llegar a 5 en todo», que es carísimo y casi nunca justificable. Es llevar todos los dominios al nivel 3 —integrado en el flujo de trabajo y con evidencia automática— y subir a 4 solo aquellos donde un fallo tendría impacto serio en el servicio.
Ese matiz es el que hace defendible el presupuesto ante dirección: no estás pidiendo dinero para «ser más seguros», estás pidiendo dinero para subir de 2 a 3 la continuidad porque hoy no sabes cuánto tardarías en recuperar el servicio, y ese dato aparece en el contrato con penalizaciones. Los controles técnicos de acceso, cifrado y desarrollo seguro dan mucho recorrido de nivel 2 a 3 con poco coste, porque se automatizan dentro del pipeline que ya tienes.
5. Qué medir: indicadores que sirven para decidir
«Lo que no se mide no mejora» es un tópico, pero en seguridad tiene un corolario menos citado y más importante: lo que se mide mal, empeora. Un indicador elegido sin cuidado cambia el comportamiento del equipo en la dirección equivocada, y lo hace en silencio.
Los KPIs concretos, con sus fórmulas, sus umbrales y cómo montar el dashboard los desarrollamos en el capítulo KPIs de seguridad: qué medir y cómo mejorar cada trimestre (próximamente). Aquí nos quedamos con el criterio de selección, que es lo que corresponde a un pilar.
5.1 Los cuatro indicadores que sostienen un cuadro de mando
Si tuviéramos que quedarnos con cuatro para una empresa tecnológica de tamaño medio, serían estos:
- Tiempo medio de detección (MTTD). Cuánto tarda la organización en enterarse de que algo va mal. Es el indicador que mejor correlaciona con el impacto final de un incidente, porque casi todo el daño se produce en la ventana entre el compromiso y la detección.
- Cobertura de parcheo crítico. Porcentaje de vulnerabilidades críticas cerradas dentro del plazo comprometido (15 o 30 días, según la categoría). Es el mejor indicador adelantado que existe: se degrada meses antes de que pase nada.
- Cobertura de formación. Porcentaje de plantilla que ha completado la formación del periodo. Medirlo sirve sobre todo para detectar el patrón habitual: los que nunca la hacen suelen ser perfiles con privilegios altos y agendas llenas.
- Incidentes por severidad y su tendencia. En números absolutos no dice mucho; en tendencia trimestral, y separando «detectados por nosotros» de «nos los ha dicho un tercero», dice muchísimo.
5.2 Indicadores que parecen buenos y no lo son
Tres trampas que vemos repetirse:
- Número de alertas gestionadas. Premia el ruido. Un equipo que afina las reglas y reduce los falsos positivos a la mitad aparece como menos productivo.
- Número de vulnerabilidades detectadas. Penaliza escanear más. Si el número sube porque has ampliado la cobertura del escáner, el indicador te castiga por hacerlo bien. Mide el tiempo de remediación, no el recuento.
- Porcentaje de controles implantados. El clásico «estamos al 94% del ENS». Trata todos los controles como equivalentes, cuando el 6% que falta puede ser justo el que importa. Sirve para el seguimiento de un proyecto de adecuación, no para gestionar riesgo.
5.3 Cada indicador necesita objetivo, umbral y dueño
Un número sin objetivo es decoración. Para que un indicador sea accionable tiene que llevar tres cosas pegadas: el valor objetivo (MTTD por debajo de 8 horas), el umbral que dispara una acción (por encima de 24 horas se abre una revisión), y una persona concreta que responde de él. Sin el dueño, el indicador se comenta en la reunión y no pasa nada.
Y todos necesitan una cadencia de revisión fija. La trimestral es la que mejor funciona: suficientemente frecuente para corregir a tiempo, suficientemente espaciada para que los cambios hayan tenido efecto.
6. Cultura de seguridad en equipos que ya van justos
Todos los marcos mencionan la concienciación y casi ninguno explica cómo se consigue. La versión que se implanta por defecto —una sesión anual obligatoria de hora y media y un test de diez preguntas— produce cumplimiento documental y cero cambio de comportamiento.
6.1 Por qué falla la formación anual
Falla por tres motivos que son bastante evidentes cuando se enuncian: llega desconectada del trabajo real de cada perfil (el mismo contenido para administración y para el equipo de plataforma), llega una vez al año cuando las decisiones de seguridad se toman a diario, y llega en formato pasivo, que es el que peor retención tiene.
Lo que sí funciona, y es más barato: formación corta y específica por rol, repetida varias veces al año, y enganchada a momentos en los que la persona está tomando esa decisión. Una nota de tres líneas en el pull request cuando alguien introduce una dependencia nueva enseña más sobre gestión de dependencias que una diapositiva en marzo.
6.2 Simulacros: la herramienta con mejor relación coste/efecto
Dos tipos, y los dos importan:
Phishing simulado. Bien hecho, es la mejor inversión en concienciación que existe. Mal hecho, destruye la confianza del equipo en el departamento de seguridad. La diferencia está en el enfoque: el objetivo es medir la tendencia de la organización y dar formación inmediata a quien pica, nunca señalar a personas ni usarlo en evaluaciones de desempeño. Si el equipo percibe que es una trampa para castigar, deja de reportar cosas reales, que es exactamente lo contrario de lo que buscabas.
Simulacro de incidente (tabletop). Dos horas, el equipo relevante en una sala y un escenario plausible: «un ransomware ha cifrado el servidor de ficheros, son las 19:00 de un viernes». No se toca ningún sistema, solo se recorre el procedimiento en voz alta. En todos los que hemos facilitado aparecen los mismos tres agujeros: no está claro quién decide desconectar, los contactos de escalado están desactualizados y nadie sabe dónde están las copias offline. Encontrar eso en una sala cuesta dos horas; encontrarlo en un incidente real cuesta días de servicio.
6.3 La métrica cultural que de verdad importa
Si solo pudieras medir una cosa sobre la cultura de seguridad de tu organización, mide cuánta gente reporta cosas raras y cuánto tarda en hacerlo. Un equipo donde la gente avisa de un correo sospechoso a los cinco minutos, incluso cuando resulta ser legítimo, tiene una cultura sana. Un equipo donde nadie reporta nada no es un equipo sin incidentes: es un equipo donde reportar sale caro o se percibe inútil.
Ese indicador sube cuando reportar es fácil (un botón en el cliente de correo, un canal claro) y cuando el reporte recibe respuesta, aunque sea para decir «era legítimo, gracias por avisar». Baja en cuanto alguien recibe una reprimenda por un falso positivo.
7. Reporting a dirección y al CTO
La mejora continua necesita presupuesto, y el presupuesto se consigue en una reunión de dirección. Por eso el reporting no es un trámite administrativo al final del ciclo: es el mecanismo que mantiene el sistema financiado.
7.1 Por qué el informe técnico no funciona en ese foro
El informe que sirve al equipo de seguridad —listado de vulnerabilidades por CVSS, alertas por regla, cobertura de agentes— es ilegible para un comité de dirección, y lo peor es que cuando es ilegible se interpreta como «esto está controlado, siguiente punto». El resultado es que nunca se aprueba nada.
Dirección necesita responder tres preguntas: ¿estamos mejor o peor que el trimestre pasado?, ¿qué nos puede tumbar el servicio? y ¿qué decisión me estás pidiendo?. Todo lo que no ayude a contestar esas tres preguntas sobra.
7.2 Un formato de una página que funciona
La estructura que mejor nos ha funcionado, y que cabe en una diapositiva:
- Semáforo de madurez por dominio con la variación respecto al trimestre anterior. Es la imagen que resume el estado en tres segundos.
- Los cuatro indicadores con su objetivo y su tendencia. Sin tablas largas: valor, objetivo, flecha.
- Incidentes del trimestre en una línea cada uno: qué pasó, cuánto duró, qué se cambió para que no se repita.
- Riesgos principales, máximo tres, en lenguaje de negocio: no «servidor sin parchear», sino «el sistema que factura no tiene copia probada; si falla, no emitimos facturas durante X días».
- La decisión que se pide, con coste y con el riesgo que se asume si se dice que no. Explícito, en una frase.
Ese último punto es el que más cambia el resultado. Una petición de presupuesto sin alternativa se debate; una petición que dice «aprobar 18.000 € para redundar el almacenamiento, o aceptar formalmente un RTO de cinco días en el servicio X» obliga a decidir, y deja registrada la decisión, que es exactamente lo que el ENS espera de la dirección.
7.3 La aceptación formal del riesgo residual
Vale la pena insistir en esto porque protege al responsable de seguridad y al propio negocio. Cuando dirección decide no financiar una medida, eso no es un fracaso del sistema de gestión: es una decisión de aceptación de riesgo, y como tal tiene que quedar registrada con fecha, importe y firma. El ENS y la ISO 27001 contemplan el riesgo residual aceptado; lo que ninguno contempla es que nadie decidiera nada.
En términos prácticos: cada revisión por la dirección debería cerrar con una lista corta de riesgos aceptados y una fecha de reevaluación. Un riesgo aceptado no es un riesgo cerrado; vuelve a la mesa el trimestre siguiente.
¿Tu ENS está vivo o congelado desde la certificación?
En Keliam montamos el ciclo de mejora continua con el equipo que ya tienes: evaluamos la madurez real por dominio, definimos los indicadores y la cadencia de revisión, y dejamos la evidencia saliendo automáticamente de vuestras herramientas de trabajo. Sin crear un sistema paralelo que nadie mantenga.
8. Revisiones periódicas y auditorías internas
La auditoría interna tiene fama de trámite previo a la de verdad. Bien planteada es lo contrario: es el mecanismo barato para encontrar los problemas antes de que los encuentre alguien con capacidad de emitir no conformidades.
8.1 Interna no significa informal
Tres condiciones mínimas para que sirva de algo: que quien audita no sea quien implantó el control (independencia, aunque sea entre departamentos), que haya un plan escrito con alcance y criterios, y que los hallazgos se registren con responsable y fecha de cierre. Si falta la tercera, es una conversación, no una auditoría.
En organizaciones pequeñas la independencia total es imposible y no pasa nada: se resuelve con auditoría cruzada entre áreas o con apoyo externo puntual. Lo que no vale es que el responsable de seguridad audite su propio trabajo y se dé el visto bueno.
8.2 Un calendario anual que no se solapa con nada
Repartir en lugar de concentrar es la única forma de que esto sea sostenible:
- Q1: revisión del análisis de riesgos y actualización de la declaración de aplicabilidad.
- Q2: auditoría interna técnica: control de acceso, configuración, revisión de permisos privilegiados. Buen momento para una auditoría de código si desarrolláis producto propio.
- Q3: prueba real de continuidad y restauración de copias, más el simulacro de incidente.
- Q4: auditoría interna documental, revisión por la dirección y planificación del año siguiente.
Con ese reparto, cuando llega la auditoría de seguimiento externa no hay que preparar nada: la evidencia se ha ido generando sola durante doce meses.
8.3 Tratar las no conformidades como incidentes, no como deberes
Una no conformidad bien gestionada lleva análisis de causa raíz, no solo corrección del síntoma. Si el hallazgo es «tres usuarios conservaban permisos de un puesto anterior», corregir es quitarles los permisos; cerrar de verdad es preguntarse por qué el proceso de cambio de puesto no revoca accesos y arreglar ese proceso. Sin esa segunda parte, el mismo hallazgo vuelve el año que viene con nombres distintos.
Conviene además distinguir entre hallazgos de conformidad y hallazgos de seguridad. Un control documentado pero inútil pasa la auditoría y no protege; un control eficaz sin documentar protege y suspende. Ambos son problemas, pero se arreglan de forma distinta, y mezclarlos en la misma lista lleva a priorizar mal. La preparación de una auditoría de certificación detalla cómo se clasifican y se cierran formalmente.
9. Caso práctico: dieciocho meses en un proveedor de la administración
El perfil es el habitual entre nuestros clientes: empresa tecnológica de unas cuarenta personas, desarrollo y mantenimiento de plataformas para organismos públicos, ENS de categoría media exigido por contrato, certificada dos años antes y con el sistema congelado desde entonces. Los datos que siguen son un compuesto de varios proyectos reales, no de uno solo.
9.1 Punto de partida (mes 0)
La evaluación inicial de madurez por dominio dio un perfil muy reconocible: marco organizativo 3 (la documentación de la certificación estaba bien hecha), desarrollo seguro 3, control de acceso 2, monitorización 2, continuidad 1, proveedores 1. Detección de incidentes dependiente de que alguien se diera cuenta; parcheo sin plazo comprometido; copias configuradas y nunca restauradas; y ningún requisito de seguridad trasladado a los subcontratistas, pese a que dos de ellos tocaban producción.
9.2 Meses 1-6: lo barato primero
Objetivos del primer semestre, tres por trimestre:
- Centralizar logs de los sistemas de producción y definir ocho reglas de alerta con sentido, en lugar de cien genéricas. Coste bajo: se montó sobre infraestructura existente, en la línea de lo que describimos en ciberseguridad en servidores con poco presupuesto.
- Comprometer un plazo de parcheo (15 días para críticas, 30 para altas) y automatizar el informe de cumplimiento del plazo.
- Revisión trimestral de permisos privilegiados, generada automáticamente desde el directorio y revisada en ticket.
- Primera restauración real de copias en un entorno aislado. Reveló que dos de los siete sistemas no se estaban copiando completos desde un cambio de volumen hecho nueve meses antes.
Ese último hallazgo, por sí solo, justificó el proyecto entero ante dirección: llevaban nueve meses creyendo que tenían copia de algo que no la tenía.
9.3 Meses 7-12: lo que cuesta negociar
El segundo semestre atacó los dos dominios rezagados, que son los que no se arreglan solo con trabajo técnico:
- Proveedores. Anexo de seguridad incorporado a los contratos de los dos subcontratistas con acceso a producción: requisitos mínimos, obligación de notificar incidentes en 24 horas y derecho de auditoría. Uno lo firmó en tres semanas; con el otro hubo dos meses de negociación.
- Continuidad. Plan escrito, RTO y RPO acordados con negocio (no fijados por el equipo técnico en solitario) y prueba semestral calendarizada.
- Primer simulacro de incidente tipo tabletop, que dejó los tres hallazgos de siempre: cadena de decisión difusa, contactos caducados y dudas sobre las copias offline.
9.4 Meses 13-18: el sistema empieza a sostenerse solo
A partir del mes trece el cambio observable fue de dinámica más que de controles: el comité trimestral ya no lo convocaba seguridad, estaba en el calendario; los indicadores se generaban solos; y la auditoría de seguimiento se preparó en dos días en lugar de en cinco semanas.
Perfil de madurez al cierre: organizativo 4, desarrollo seguro 4, control de acceso 3, monitorización 3, continuidad 3, proveedores 2. Ningún dominio en 5, y no era el objetivo. MTTD pasó de «indeterminado» a una media de 6,5 horas. El cumplimiento del plazo de parcheo crítico se estabilizó en torno al 92%. Y hubo dos incidentes reales, ambos detectados internamente y contenidos el mismo día — lo que antes probablemente habría sido una llamada de un tercero una semana después.
9.5 Lo que costó
En esfuerzo interno: aproximadamente una jornada semanal del responsable técnico durante los seis primeros meses, bajando a media jornada después, más las medias jornadas trimestrales del comité. En herramienta, poco: casi todo se montó sobre lo que ya había. El grueso del coste real fueron las horas de negociación con proveedores y el tiempo de negocio para acordar los RTO, que son justo las partidas que nadie presupuesta.
10. Errores frecuentes al montar la mejora continua
- Crear un sistema de evidencias paralelo. Un SharePoint solo para seguridad que hay que alimentar a mano. Dura cuatro meses. La evidencia tiene que salir de donde el equipo ya trabaja.
- Medir veinte indicadores. Un cuadro de mando con veinte métricas no se revisa. Cuatro bien elegidos con dueño y objetivo valen más.
- Convertir el phishing simulado en una caza de brujas. Mata el reporte voluntario, que es el control más valioso que tienes.
- Esperar a tener el sistema perfecto para empezar a medir. Un MTTD malo medido es infinitamente más útil que un MTTD excelente imaginado.
- Dejar la continuidad para el final. Es el dominio que más tarda en madurar porque depende de probar, y probar necesita ventanas y coordinación. Si se empieza en el mes diez, no llega.
- No documentar lo que se decide no hacer. El riesgo aceptado sin registrar es el que aparece en la auditoría como falta de gobierno, y el que deja al responsable de seguridad sin respaldo cuando algo sale mal.
- Montar dos sistemas de gestión si tienes ENS e ISO 27001. Un solo ciclo, una sola evidencia, dos informes de salida.
Conclusión
El ENS pide explícitamente reevaluación periódica y mejora continua, pero no dice cómo se hacen. Esa parte —la cadencia, los indicadores, la evidencia automática, el reporting que consigue presupuesto— es trabajo de ingeniería y de gestión que cada organización tiene que montar, y es lo que separa a una empresa conforme de una empresa realmente preparada.
Lo que hemos visto funcionar no es sofisticado: un comité trimestral de media jornada, tres objetivos por trimestre, cuatro indicadores con dueño, evidencia que sale de las herramientas que el equipo ya usa, un calendario anual que reparte las revisiones en lugar de amontonarlas, y un informe de una página que obliga a dirección a decidir. Con eso, subir un nivel de madurez al año en los dominios que importan es un objetivo perfectamente alcanzable.
Y la métrica que mejor resume si lo estás consiguiendo sigue siendo la del principio: si puedes contar qué cambió en tu análisis de riesgos en los últimos tres meses, y por qué, tu sistema está vivo. Si tienes que ir a buscar el documento, todavía no. El marco regulatorio, además, empuja en esta dirección: obligaciones como las de NIS2 para empresas tecnológicas asumen justamente un proceso de gestión continuo, no una foto anual.
Preguntas frecuentes
¿Cada cuánto hay que revisar el análisis de riesgos según el ENS?
El esquema exige reevaluación periódica sin fijar un plazo único, y la práctica habitual es una revisión completa anual más actualizaciones puntuales cada vez que hay un cambio significativo: un sistema nuevo en producción, un cambio de proveedor crítico, un incidente relevante o una modificación del servicio prestado. La revisión trimestral ligera —tocar solo lo que ha cambiado— es la que hace llevadera la anual.
¿La mejora continua es obligatoria o es una recomendación?
Está en el propio RD 311/2022 como principio: la seguridad es un proceso integral que debe reevaluarse y mejorarse. En una auditoría no se audita «la mejora continua» como control aislado, pero sí se piden las evidencias que produce: revisiones documentadas, tratamiento de hallazgos anteriores, actualización del análisis de riesgos y decisiones de la dirección. Sin ellas, aparecen no conformidades.
¿Qué diferencia hay entre madurez y conformidad?
Conformidad es binaria: tienes implantadas las medidas de tu categoría y puedes demostrarlo, o no. Madurez es una escala que describe cómo las tienes: si dependen de una persona, si están escritas, si están integradas en el flujo de trabajo, si se miden y si se mejoran con los datos. Se puede estar conforme con madurez baja, y es la situación más común justo después de certificarse.
¿Puedo aprovechar el mismo ciclo para ENS e ISO 27001?
Sí, y es lo recomendable. El análisis de riesgos, el cuadro de indicadores, las auditorías internas, la revisión por la dirección y el tratamiento de no conformidades son comunes; lo que cambia es el formato de salida y el conjunto de controles de referencia. El detalle del mapeo está en ENS vs ISO 27001.
¿Cuánta dedicación interna requiere mantener esto?
En una empresa de entre 20 y 50 personas, y una vez montado, la cifra que vemos es aproximadamente media jornada semanal de un responsable técnico más una media jornada trimestral del comité. El primer año es bastante más, porque hay que construir lo que no existe, sobre todo en continuidad y en gestión de proveedores.
¿Por dónde empiezo si mi sistema lleva dos años congelado?
Por una evaluación de madurez por dominio, que en un par de semanas te dice dónde está el agujero real, y por una restauración de prueba de las copias. Esas dos acciones cuestan poco y, por experiencia, una de las dos suele descubrir algo importante. Con eso ya tienes material para la primera reunión trimestral y para pedir el presupuesto del año.
Cap. 14: Ciclo PDCA aplicado a la seguridad (próximamente) →