Casi todas las empresas con más de cinco años de historia tecnológica arrastran la misma situación: una infraestructura que ha crecido por acumulación. Un servidor que contrató un proveedor que ya no está, un VPS que alguien levantó para «una prueba» y hoy sostiene producción, backups que se configuraron una vez y nadie ha restaurado jamás, y un despliegue que sigue dependiendo de que una persona concreta suba ficheros por SFTP un viernes por la tarde. Todo funciona… hasta que deja de hacerlo.
Una auditoría de infraestructura IT es la radiografía completa de esa capa invisible: servidores, red, copias de seguridad, pipelines de despliegue y monitorización. No es un pentest (aunque comparte frontera con él) ni una auditoría de código: es la revisión sistemática de dónde corre tu software, cómo se despliega y qué pasaría si mañana un disco muere, un proveedor cierra o un ransomware cifra la mitad de tus máquinas.
En Keliam hacemos este ejercicio de forma recurrente para clientes que heredan sistemas, preparan una certificación o simplemente llevan años sin que nadie mire debajo del capó. En esta guía te contamos exactamente qué se revisa en cada área, con qué herramientas, qué hallazgos aparecen una y otra vez, y cómo se convierte todo en un plan de remediación priorizado que dirección pueda entender y aprobar. Si tu empresa está empezando de cero en seguridad, te recomendamos leer antes nuestra guía para montar un sistema de seguridad desde cero en una pyme; esta auditoría es el paso natural siguiente.
1. Qué es una auditoría de infraestructura y cuándo hacerla
La auditoría de infraestructura evalúa el estado real de los sistemas que sostienen tu negocio frente a tres preguntas: ¿es seguro?, ¿es recuperable?, ¿es sostenible? La primera mira exposición y hardening. La segunda, copias, redundancia y capacidad de volver a levantar el servicio. La tercera, si la operación depende de personas concretas, de proveedores sin contrato o de decisiones que nadie documentó.
A diferencia de una auditoría de seguridad ofensiva, aquí el enfoque es constructivo y de inventario: se trabaja con acceso a los sistemas, con el equipo interno, y el entregable es un mapa completo con hallazgos priorizados, no una demostración de intrusión. Ambas se complementan: es habitual que una auditoría de infraestructura destape superficies expuestas que luego un pentest explota para cuantificar el riesgo.
1.1 Señales de que te toca auditar
Hay disparadores claros: has heredado la infraestructura de un proveedor anterior y nadie sabe qué hay contratado; vas a certificarte en ISO 27001 o ENS y necesitas la foto de partida; has sufrido un incidente (caída larga, pérdida de datos, intrusión) y quieres que no se repita; o el gasto en cloud crece cada mes sin que nadie sepa explicar por qué. También hay disparadores silenciosos: si nadie en tu empresa puede responder en menos de una hora «¿qué servidores tenemos y quién tiene acceso root?», la auditoría no es opcional, es urgente.
2. Inventario y arquitectura: el mapa antes que el territorio
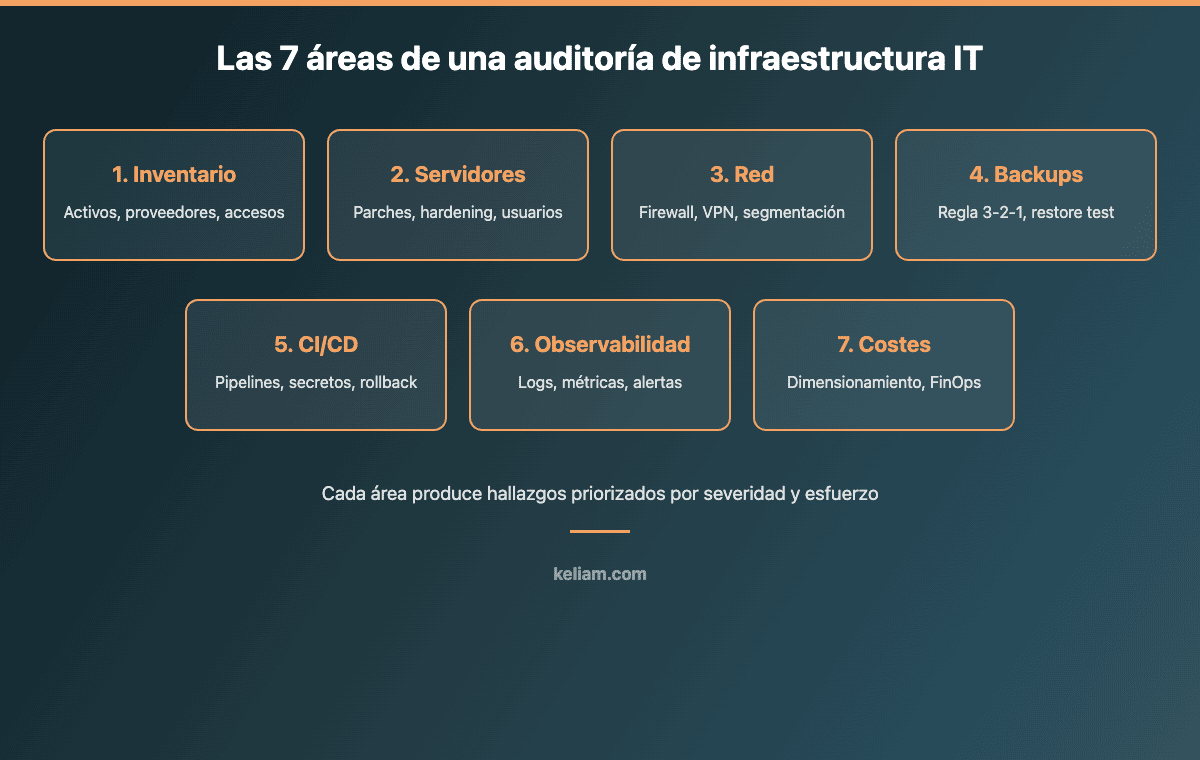
Toda auditoría empieza igual: construyendo el inventario real, que casi nunca coincide con el que la empresa cree tener. Se listan proveedores (hosting, cloud, DNS, correo, CDN, pasarelas), máquinas físicas y virtuales, contenedores, dominios y certificados, bases de datos, y los servicios SaaS críticos. Para cada activo: quién lo paga, quién tiene acceso, qué versión corre y de qué depende.
Las sorpresas típicas de esta fase justifican por sí solas el ejercicio: dominios a punto de caducar registrados a nombre de un exempleado, certificados TLS renovados a mano, servidores «fantasma» que nadie usa pero siguen facturando, y entornos de staging con datos reales de clientes accesibles desde internet. El entregable es un diagrama de arquitectura y una matriz de activos con propietario, criticidad y estado, que además es exactamente lo que pide un control de gestión de activos de la ISO 27001 si más adelante quieres certificarte.
3. Servidores y sistemas: parches, hardening y accesos
Con el mapa hecho, se baja a cada máquina. Lo primero es el ciclo de vida: versiones de sistema operativo y de los runtimes (PHP, Node, Python, Java) frente a sus fechas de fin de soporte. Encontrar un Ubuntu 18.04 o un PHP 7.4 en producción no es anécdota: es deuda con interés compuesto, porque cada mes sin parches amplía la ventana de vulnerabilidades conocidas y explotables.
Después, el hardening básico: ¿se entra por SSH con contraseña o con clave?, ¿root puede loguearse directamente?, ¿hay MFA en los paneles de control?, ¿los puertos expuestos son solo los necesarios? Un escaneo externo con nmap y una revisión de reglas de firewall local suelen destapar paneles de administración, bases de datos y servicios internos escuchando en interfaces públicas. Nuestra guía de ciberseguridad en servidores con poco presupuesto recoge la línea base que usamos como referencia: todo lo que esté por debajo de ella se convierte en hallazgo.
3.1 Usuarios, claves y el problema del offboarding
El hallazgo más repetido en esta área no es técnico, es organizativo: cuentas de personas que ya no están en la empresa con acceso vigente. Claves SSH de exempleados en authorized_keys, usuarios de paneles compartidos con contraseña en un Excel, tokens de API generados hace años sin rotación. La auditoría cruza la lista de accesos reales con la plantilla actual y documenta cada discrepancia. Si no existe un procedimiento de baja (revocar accesos el mismo día que alguien se va), ese procedimiento es la primera recomendación del informe.
4. Red y perímetro: firewall, VPN y segmentación
La capa de red es donde más diferencia hay entre pymes que «tienen internet» y empresas con una infraestructura defendible. La auditoría revisa qué hay entre tus sistemas e internet: ¿existe un firewall perimetral de verdad o solo el router de la operadora?, ¿los accesos remotos van por VPN o hay escritorios remotos y paneles expuestos?, ¿la red de oficina está segmentada respecto a servidores y dispositivos IoT?
En entornos de oficina y on-premise aplicamos el modelo que describimos en nuestro artículo sobre cómo montar un firewall detrás del router de la operadora: un perímetro propio con reglas explícitas, VPN para todo acceso de gestión y visibilidad del tráfico. En cloud, el equivalente son los security groups y las VPC: la auditoría comprueba que no haya reglas 0.0.0.0/0 sobre puertos de administración, que las bases de datos no tengan IP pública y que los buckets de almacenamiento no estén abiertos. La regla de oro que evaluamos es simple: nada de gestión expuesto a internet sin VPN o allowlist, sin excepciones «temporales» que llevan tres años.
5. Backups y recuperación: la regla 3-2-1 y el RTO que nadie ha medido
Si solo pudieras auditar un área, sería esta. La pregunta no es «¿tienes backups?» (todo el mundo dice que sí), sino «¿cuándo fue la última vez que restauraste uno completo y cuánto tardaste?». El silencio que sigue a esa pregunta es el hallazgo.
La referencia es la regla 3-2-1: tres copias de los datos, en dos soportes distintos, con al menos una fuera de la infraestructura principal — y a poder ser inmutable o desconectada, porque el ransomware moderno busca y cifra los backups accesibles antes de detonar. La auditoría verifica qué se copia (¿solo la base de datos, o también ficheros, configuraciones y secretos?), con qué frecuencia, cuánto se retiene, dónde viven las copias y quién puede borrarlas. Un backup en el mismo servidor que los datos, o en un bucket con las mismas credenciales que produce el sistema, no cuenta como copia: cuenta como espejismo.
5.1 RTO y RPO: ponerle números al desastre
La segunda mitad de esta área es la recuperación. Definimos con el cliente dos métricas: RPO (cuántos datos puedes permitirte perder: ¿una hora?, ¿un día?) y RTO (cuánto puedes estar caído). Después medimos la realidad: se restaura un backup en un entorno limpio y se cronometra. Es habitual descubrir que el RTO real es de días — porque falta documentación, porque las configuraciones no estaban en el backup, porque nadie recuerda cómo se instalaba aquello. Ese ejercicio, un restore test cronometrado, es la prueba más barata y valiosa de toda la auditoría.
¿Sabes cómo está tu infraestructura de verdad?
En Keliam auditamos servidores, red, backups y pipelines de despliegue, y te entregamos un plan de remediación priorizado por riesgo y coste. Sin humo: hallazgos concretos, comandos y presupuesto de cada fix.
6. CI/CD y despliegues: del SFTP a los pipelines
Cómo llega el código a producción dice más de la madurez de una empresa que cualquier otra métrica. En un extremo, despliegues manuales por SFTP sin control de versiones del servidor; en el otro, pipelines de CI/CD con tests, builds reproducibles y despliegue con rollback automático. La auditoría sitúa a la empresa en ese espectro y documenta los riesgos del punto en el que está.
Se revisan cuestiones concretas: ¿todo el código en producción está en Git, o hay ficheros editados a mano en el servidor?, ¿el pipeline ejecuta tests y análisis de dependencias antes de desplegar?, ¿se puede volver a la versión anterior en minutos?, ¿los despliegues quedan registrados (quién, qué, cuándo)? Un patrón peligroso que encontramos a menudo: el pipeline existe, pero el servidor también permite cambios manuales, y con el tiempo ambos divergen hasta que un despliegue «normal» borra un hotfix que solo vivía en producción.
6.1 Secretos y permisos del pipeline
El pipeline es, en la práctica, una identidad con acceso a producción, y así hay que auditarlo. ¿Dónde viven las credenciales que usa: en un gestor de secretos, en variables de CI protegidas o en un fichero .env commiteado hace dos años? ¿El token de despliegue puede solo desplegar, o tiene permisos de administración sobre toda la cuenta cloud? ¿Quién puede modificar el propio pipeline y aprobar merges a la rama principal? Estas preguntas conectan directamente con el desarrollo seguro que exige la ISO 27001: el pipeline es parte de la superficie de ataque, como demuestran los incidentes de cadena de suministro de los últimos años.
7. Observabilidad: logs, métricas y alertas que alguien mire
La pregunta clave de esta área: cuando algo falla, ¿te enteras tú o te entera un cliente? La auditoría revisa tres niveles. Primero, monitorización básica de disponibilidad: checks externos de uptime sobre los servicios críticos con avisos a un canal que alguien lea. Segundo, métricas de sistema y aplicación: CPU, memoria, disco (los discos llenos siguen tumbando más servicios que los hackers), tiempos de respuesta y tasas de error. Tercero, logs centralizados: si para investigar un incidente hay que entrar máquina por máquina a hacer grep, la respuesta a incidentes será lenta y las evidencias se perderán en la rotación.
No hace falta un stack de observabilidad de gran empresa: para una pyme, un check de uptime, node_exporter con Prometheus y Grafana o incluso las métricas del propio proveedor cloud, y una retención de logs de 30-90 días cubren el 90 % del valor. El hallazgo habitual no es la falta de herramientas, sino alertas que llegan a un buzón que nadie mira o umbrales tan mal calibrados que el equipo aprendió a ignorarlas.
8. Costes y dimensionamiento: la parte que paga la auditoría
Una auditoría de infraestructura seria incluye la dimensión económica, y es frecuente que los ahorros identificados paguen el proyecto completo. Se revisa el dimensionamiento real frente al contratado: máquinas al 5 % de CPU pagando tarifa de pico, discos provisionados que nadie usa, entornos de desarrollo encendidos 24/7, instancias reservables pagándose bajo demanda, y tráfico saliente que se dispara por una mala arquitectura de CDN.
También se evalúa la dependencia de proveedor: ¿qué costaría migrar?, ¿hay contrato y SLA con el hosting actual, o todo descansa en un plan mensual sin compromiso por ninguna de las partes? El resultado es una tabla de coste actual frente a coste optimizado, con las acciones concretas para cerrar la diferencia. No es raro encontrar reducciones del 20-40 % sin tocar rendimiento, solo eliminando lo que nadie usaba y ajustando lo sobredimensionado.
9. El informe: matriz de hallazgos y plan de remediación
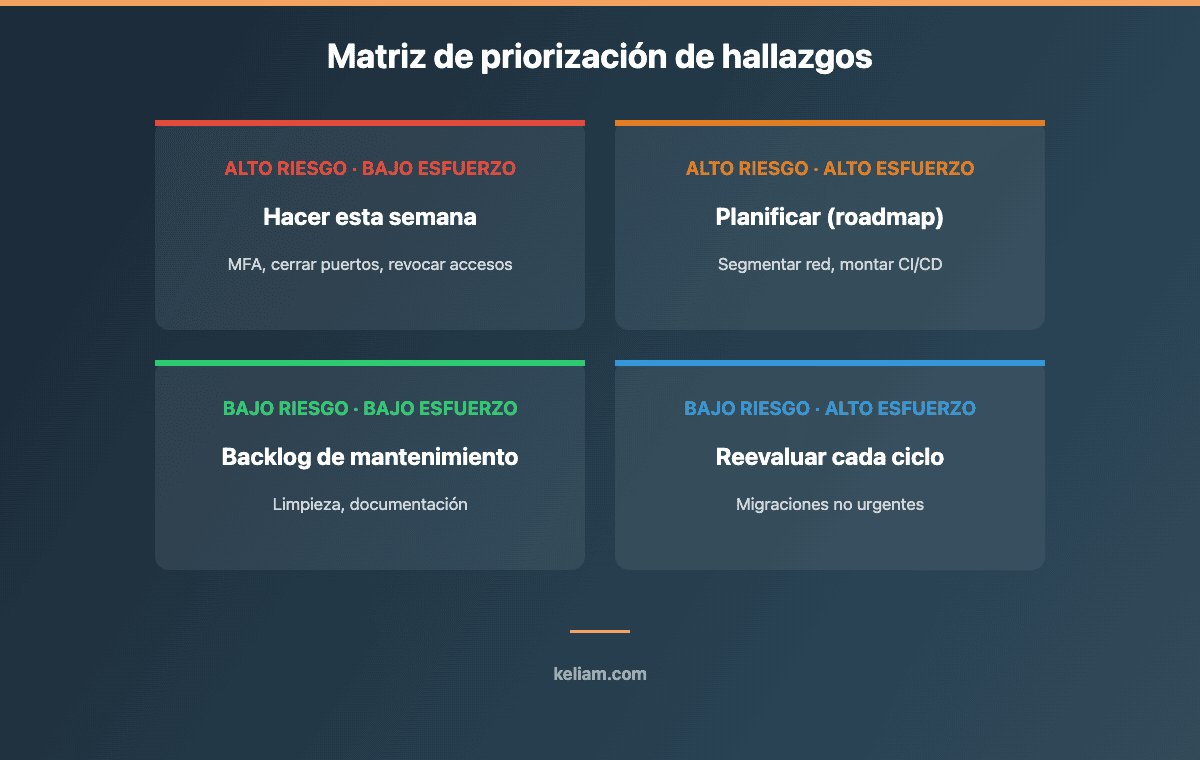
Todo lo anterior cristaliza en el entregable: un informe con cada hallazgo clasificado por severidad (crítico, alto, medio, bajo) y esfuerzo de corrección, con evidencias y con la solución recomendada paso a paso. La clave es la priorización cruzada: lo crítico y barato se hace esta semana (cerrar un puerto, revocar accesos de exempleados, activar MFA); lo crítico y caro se planifica (segmentar la red, montar el pipeline); lo menor entra en el backlog de mantenimiento.
Un buen informe tiene dos lecturas: la técnica, con comandos y configuraciones concretas para el equipo que ejecuta, y la ejecutiva, con riesgo de negocio y presupuesto para quien aprueba. Y termina con una recomendación de cadencia: la auditoría no es una foto que se hace una vez, sino un ciclo — normalmente anual, o semestral en infraestructuras que cambian rápido — que en cada iteración parte del informe anterior y mide cuánto se ha cerrado.
Conclusión: auditar antes de que duela
La infraestructura es el único activo tecnológico que se degrada estando quieto: cada mes sin parches, sin restore tests y sin revisar accesos, el riesgo crece solo. Una auditoría de infraestructura IT convierte esa incertidumbre difusa en una lista finita de problemas con dueño, precio y fecha. Las empresas que la hacen de forma recurrente no tienen menos incidentes por suerte: los tienen porque encontraron el disco lleno, el backup roto y la cuenta huérfana antes de que lo hiciera la realidad.
Si no sabes por dónde empezar, empieza por las dos preguntas que más duelen: ¿cuánto tardarías en restaurar todo desde cero? y ¿quién tiene acceso a producción ahora mismo? Si las respuestas no te gustan — o no existen — ya sabes cuál es el siguiente paso.
Preguntas frecuentes sobre la auditoría de infraestructura
¿Cuánto dura una auditoría de infraestructura?
Para una pyme con un puñado de servidores y un proveedor cloud, entre una y tres semanas: una de recogida de información y análisis, y el resto para pruebas (incluido el restore test) y redacción del informe. Infraestructuras híbridas o multi-cloud con decenas de máquinas pueden irse a cuatro-seis semanas.
¿Interfiere con la operación diaria?
Prácticamente no. El 90 % del trabajo es lectura: inventario, configuraciones, logs y facturación. Las pruebas potencialmente intrusivas (escaneos, restore tests) se pactan en ventana y se hacen sobre entornos separados. Nadie tiene que parar de desplegar.
¿En qué se diferencia de un pentest?
El pentest simula un ataque para demostrar qué puede conseguir un adversario; la auditoría de infraestructura revisa el estado completo del sistema con acceso y colaboración del equipo. El pentest encuentra caminos; la auditoría encuentra causas. Lo ideal es auditar primero, corregir, y validar después con un pentest.
¿Qué necesito preparar antes de empezar?
Poco: acceso de lectura a proveedores y sistemas, la documentación que exista (aunque esté desactualizada, sirve para medir la desviación) y una persona de contacto que conozca la historia de la infraestructura. Si no hay documentación, la auditoría la genera: el inventario y el diagrama de arquitectura forman parte del entregable.