Hay una conversación que se repite en casi todas las empresas con una plataforma web con años de recorrido: «la web va lenta». Alguien mira Google PageSpeed, ve un 62 en móvil, y el equipo se lanza a comprimir imágenes y diferir JavaScript. Dos semanas después la puntuación ha subido a 78 y los usuarios siguen quejándose de lo mismo. El motivo suele ser sencillo: el problema nunca estuvo en el navegador. Estaba en el servidor, en el tiempo que tarda tu backend en producir el primer byte de respuesta.
Una auditoría de rendimiento backend es el ejercicio sistemático de medir, instrumentar y diseccionar ese tiempo: cuánto tarda PHP en arrancar, cuántas consultas lanza a la base de datos, qué APIs externas está esperando, dónde se cae la caché y cuántas peticiones simultáneas aguanta la máquina antes de empezar a encolar. No es afinar cuatro parámetros del servidor a ojo: es un proceso con instrumentación, hipótesis, medición y verificación, cuyo entregable es un plan priorizado por impacto y esfuerzo.
En Keliam hacemos este trabajo tanto en plataformas heredadas que nadie ha tocado en años como en aplicaciones a medida que empiezan a notar el crecimiento. En esta guía te contamos exactamente cómo se ejecuta: qué métricas mirar (y cuáles ignorar), cómo instrumentar sin romper producción, cómo se lee un profiling de PHP, por qué la base de datos casi siempre acaba siendo la protagonista, y cómo convertir todo eso en decisiones que dirección pueda aprobar. Si lo que te preocupa es la capa de navegador, tenemos una guía paralela sobre auditoría de rendimiento web y sus métricas clave; esta es su hermana de servidor.
1. Qué es una auditoría de rendimiento backend (y qué no es)
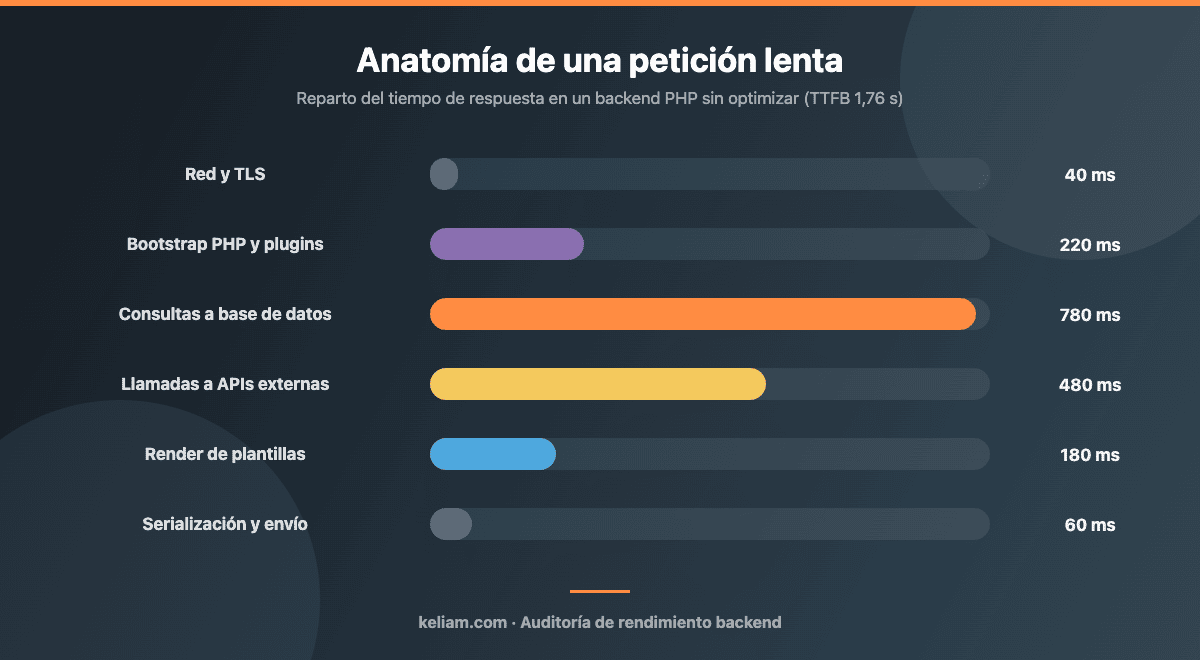
La auditoría de rendimiento backend evalúa el trabajo que hace tu servidor para responder a una petición: resolución de rutas, arranque del framework, lógica de negocio, acceso a datos, integraciones externas y generación de la respuesta. Su métrica de cabecera es el TTFB (time to first byte), pero el objetivo real es entender la distribución completa del tiempo y la capacidad del sistema bajo carga.
Conviene delimitar qué no es. No es una auditoría de frontend: si tu problema es un LCP malo por imágenes sin optimizar o un INP alto por JavaScript bloqueante, el trabajo está en el navegador y lo cubrimos en el artículo sobre Core Web Vitals e INP. Tampoco es una auditoría de seguridad, aunque comparten herramientas y a menudo se descubren cosas cruzadas: endpoints sin autenticación que además son carísimos de ejecutar son un clásico que aparece en ambas.
1.1 Las señales que la desencadenan
Los disparadores habituales son bastante reconocibles. El TTFB del listado de productos supera el segundo mientras la home carga en 200 ms. El panel de administración se ha vuelto inutilizable aunque la parte pública funcione. La factura de cloud sube cada trimestre sin que el tráfico crezca en la misma proporción. Los picos de campaña tumban el sitio aunque el resto del año sobre capacidad. O el más incómodo: el equipo ya no sabe qué tocar porque cada cambio «mejora una cosa y empeora otra».
Hay también un disparador silencioso que casi nadie identifica a tiempo: la degradación progresiva. Un sistema que hace tres años respondía en 180 ms y hoy responde en 900 ms rara vez lo hace por un único cambio catastrófico. Lo hace por acumulación de decisiones pequeñas —un plugin más, una tabla que ha crecido, una integración añadida en un endpoint caliente— y por eso solo se detecta si alguien mide en serie.
2. Las métricas que importan: percentiles, no promedios
El error metodológico más común de una auditoría mal hecha es trabajar con medias. Un tiempo medio de respuesta de 300 ms puede esconder que el 90 % de las peticiones se resuelven en 90 ms y el 10 % restante —que casualmente son el checkout y el buscador— tardan 2,5 segundos. La media es la métrica que hace que un problema grave parezca aceptable.
2.1 El conjunto mínimo de métricas
Una auditoría seria trabaja al menos con estos indicadores, siempre segmentados por endpoint o ruta, no agregados para todo el sitio:
- Latencia p50, p95 y p99. La mediana te dice cómo es la experiencia habitual; el p95 y el p99, cómo es cuando algo se tuerce. Los objetivos se fijan sobre p95, nunca sobre la media.
- Throughput (peticiones por segundo) y su relación con la latencia. Un sistema que responde en 120 ms con 5 rps y en 1.400 ms con 50 rps tiene un problema de concurrencia, no de código lento.
- Tasa de error segmentada por código: los 502 y 504 son la firma de un backend saturado o con timeouts mal puestos.
- Saturación de recursos: CPU, memoria, I/O de disco, y sobre todo el número de workers PHP-FPM ocupados frente a los disponibles.
- Consultas por petición y tiempo total en base de datos. Es la métrica que más veces señala al culpable real.
2.2 Presupuesto de rendimiento por endpoint
Antes de optimizar nada hay que decidir qué es «suficientemente rápido», y eso no es un número único. Un presupuesto razonable para una plataforma de negocio típica sería: páginas cacheables por debajo de 200 ms de TTFB en p95; páginas personalizadas (carrito, cuenta, panel) por debajo de 600 ms; endpoints de API internos por debajo de 300 ms; y procesos de escritura pesada (importaciones, informes) fuera del ciclo de petición, en cola.
Ese presupuesto es lo que convierte la auditoría en algo verificable: cada hallazgo se mide contra un objetivo explícito, y al final del proyecto se puede demostrar si se cumplió o no. Sin presupuesto, «va más rápido» es una opinión.
3. Instrumentar antes de optimizar
La regla de oro de cualquier auditoría de rendimiento es que no se optimiza lo que no se mide. Optimizar por intuición es la forma más eficiente de invertir dos semanas en el 3 % del tiempo de respuesta. Por eso la primera fase real del trabajo no es tocar código: es dejar el sistema instrumentado.
3.1 APM: la foto continua
Un APM (Application Performance Monitoring) recoge trazas de peticiones reales en producción y las descompone por capas. Las opciones habituales según presupuesto y madurez del equipo:
- New Relic o Datadog APM. Cobertura completa, agentes maduros para PHP, correlación con infraestructura. Coste alto y creciente con el volumen de hosts y datos.
- Tideways o Blackfire. Enfocados a PHP, con muestreo continuo en producción y profiling bajo demanda. Excelente relación entre coste y profundidad para plataformas PHP.
- OpenTelemetry con SigNoz, Grafana Tempo o Jaeger. La vía abierta: instrumentas con el SDK estándar y eliges dónde almacenar. Más trabajo inicial, cero dependencia de proveedor.
- Query Monitor y New Relic para WordPress cuando el entorno es WordPress o WooCommerce: la vista por hooks y por plugin ahorra días de investigación.
Lo importante no es cuál se elija, sino que el muestreo cubra suficientes peticiones reales para que aparezcan los casos malos. Un APM configurado al 1 % de muestreo en un sitio con tráfico bajo no verá nunca el p99, y el p99 es exactamente lo que estás buscando.
3.2 Trazas distribuidas y correlación
En arquitecturas con más de un servicio —una API interna, un motor de búsqueda, un microservicio de pagos— la métrica agregada deja de servir. Necesitas trazas distribuidas: un identificador que viaje en la cabecera de la petición y permita reconstruir la cascada completa. Sin eso, un endpoint que tarda 1,2 s es una caja negra; con eso, ves que 900 ms se los come una llamada síncrona a un servicio de stock que a su vez espera a un ERP.
Un detalle práctico que ahorra mucho tiempo: correlacionar el identificador de traza con los logs de aplicación y con el slow query log de la base de datos. Cuando los tres comparten un mismo request id, investigar un incidente pasa de horas a minutos.
4. Profiling de PHP en la práctica
El APM te dice qué endpoint es lento. El profiler te dice por qué. Son herramientas complementarias y confundirlas es un error frecuente: intentar diagnosticar una función concreta a partir de métricas agregadas lleva a conclusiones equivocadas.
4.1 Xdebug, Blackfire, Excimer y SPX: cuándo usar cada uno
Xdebug con su profiler es la opción de desarrollo: instrumenta cada llamada a función y genera ficheros cachegrind que se leen con KCachegrind o Webgrind. Es exhaustivo y por eso mismo distorsiona: multiplica el tiempo de ejecución por factores de 2 a 10. Sirve para entender la estructura de llamadas en local, jamás para medir tiempos absolutos ni para usar en producción.
Blackfire y Tideways funcionan con sobrecarga baja y permiten perfilar peticiones concretas en producción bajo demanda, además de comparar dos perfiles (antes y después de un cambio) con métricas de referencia. Es la herramienta natural para el ciclo hipótesis-cambio-verificación de una auditoría.
Excimer (el sampler que usa Wikimedia) y SPX son alternativas de muestreo, gratuitas y con sobrecarga casi nula. Excimer interrumpe la ejecución cada pocos milisegundos y registra la pila; con suficientes muestras obtienes un flamegraph estadísticamente fiel sin instrumentar cada llamada. Es la mejor opción si quieres profiling continuo en producción sin licencias.
4.2 Cómo se lee un flamegraph sin engañarse
La confusión más habitual al leer un perfil es mezclar tiempo inclusivo (lo que tarda una función y todo lo que llama por debajo) con tiempo exclusivo o propio (solo lo que tarda ella misma). En un flamegraph, la anchura de una barra es tiempo inclusivo; lo que buscas para optimizar es la barra ancha que además es «meseta», es decir, que no tiene mucho apilado encima: ahí es donde se consume el tiempo de verdad.
Dos patrones que aparecen casi siempre y que conviene reconocer al vuelo: la torre estrecha y altísima, síntoma de recursión o de una cadena de decoradores y middlewares excesiva; y el peine, cientos de barras finas idénticas una al lado de otra, que es la firma inconfundible de un problema N+1 —normalmente contra la base de datos, a veces contra una API.
4.3 OPcache, JIT, preloading y realpath cache
Antes de tocar una línea de código de negocio hay que descartar que el intérprete esté mal configurado, porque es la optimización más barata que existe. La lista de verificación es corta pero se falla con una frecuencia sorprendente:
- OPcache activo con
opcache.memory_consumptionsuficiente para que no haya reciclado: si el ratio de aciertos baja del 99 % o hay restarts por falta de memoria, estás recompilando código en cada petición. - opcache.max_accelerated_files por encima del número real de ficheros PHP del proyecto. Un WooCommerce con veinte plugins supera fácilmente los 15.000 ficheros y el valor por defecto se queda corto.
- opcache.validate_timestamps desactivado en producción, con purga en el despliegue. Evita comprobar la fecha de cada fichero en cada petición.
- realpath_cache_size ampliado (el valor por defecto de 4M es escaso para proyectos con muchos ficheros y autoload PSR-4 profundo).
- Autoloader de Composer optimizado con mapa de clases generado en el despliegue, no resolución dinámica en cada arranque.
- JIT: útil en cargas de cálculo intensivo, prácticamente irrelevante en aplicaciones web donde el tiempo se va en I/O. No esperes milagros y mídelo antes de activarlo.
4.4 Los sospechosos habituales por plataforma
La experiencia acumulada permite ir directo a ciertos sitios. En WordPress y WooCommerce: opciones autocargadas descontroladas (la tabla wp_options con megabytes de autoload = yes), transients almacenados en base de datos sin caché de objeto, metadatos de pedidos sin migrar a HPOS —tema que tratamos a fondo en la guía de migración a High-Performance Order Storage— y plugins que enganchan consultas costosas a init, ejecutándose por tanto en absolutamente todas las peticiones.
En Magento 2, la indexación mal configurada y los bloques no cacheados dominan el diagnóstico; lo desarrollamos en el artículo sobre optimización de rendimiento en catálogos grandes. En aplicaciones a medida con Laravel o Symfony, los sospechosos son el ORM cargando relaciones sin eager loading, la serialización masiva de entidades en respuestas de API, y los event listeners síncronos que deberían ser trabajos en cola.
5. La base de datos casi siempre es la protagonista
Si tuviéramos que apostar a ciegas dónde está el tiempo de un backend PHP lento, apostaríamos a la base de datos y acertaríamos la mayoría de las veces. No porque MySQL sea lento, sino porque es donde se acumulan las decisiones de diseño que envejecen peor: consultas escritas cuando la tabla tenía diez mil filas y hoy tiene diez millones, índices que nunca se revisaron, y patrones de acceso que multiplican las consultas sin que nadie lo note en desarrollo.
5.1 El problema N+1, que sigue siendo el número uno
El patrón es siempre el mismo: se recupera una lista de N elementos con una consulta y después, dentro del bucle de renderizado, se lanza una consulta adicional por cada elemento para traer un dato relacionado. Con 20 resultados y una base rápida no se nota. Con 200 resultados y 3 ms por consulta son 600 ms de latencia que aparecen y desaparecen según lo que devuelva el listado, lo que hace que el problema sea intermitente y difícil de reproducir.
Detectarlo es trivial una vez instrumentado: si el número de consultas por petición crece linealmente con el número de resultados mostrados, tienes un N+1. La solución pasa por precargar las relaciones en una consulta agregada (WHERE id IN (...)), usar el eager loading del ORM, o cachear el dato relacionado en la capa de objeto.
5.2 Slow query log y EXPLAIN, en ese orden
El flujo de trabajo estándar para la parte de datos de la auditoría es sencillo y no admite atajos:
- Activar el slow query log con un umbral bajo (100 ms, incluso 50 ms) durante una ventana representativa de tráfico real, incluyendo un pico.
- Agregar el resultado con
pt-query-digestomysqldumpslowpara ordenar por tiempo total acumulado, no por tiempo de la peor ejecución. Una consulta de 40 ms lanzada 50.000 veces al día hace más daño que una de 4 s lanzada dos veces. - Pasar las consultas del top por
EXPLAINy, mejor aún,EXPLAIN ANALYZE: buscartype: ALL(escaneo completo),Using filesort,Using temporaryy discrepancias grandes entre filas estimadas y filas reales. - Revisar
performance_schemapara ver esperas de bloqueo, contención de I/O y consumo real por consulta digest. - Verificar el buffer pool de InnoDB: si no cabe el conjunto de datos activo, el sistema hará I/O de disco constante y ninguna optimización de consulta lo compensará.
5.3 Índices: ni pocos ni de más
La intuición general es que faltan índices, y a menudo es cierto: columnas usadas en WHERE, JOIN y ORDER BY sin cubrir. Pero el problema contrario aparece con la misma frecuencia en sistemas veteranos: tablas con quince índices, varios redundantes entre sí, que penalizan cada escritura y engordan la memoria sin aportar nada a la lectura. Un índice sobre (a) es redundante si ya existe uno sobre (a, b), y muchas veces nadie lo ha revisado desde que se creó.
La auditoría de datos suele destapar además esquemas con problemas de fondo —tipos sobredimensionados, ausencia de particionado en tablas de log que crecen sin control, campos JSON usados donde tocaba una relación— que exceden el alcance de la optimización rápida y entran en un plan a medio plazo.
¿Tu backend tarda más de lo que debería y no sabes por dónde empezar?
En Keliam instrumentamos tu plataforma, perfilamos las rutas críticas y te entregamos un informe con los hallazgos priorizados por impacto y esfuerzo, con antes y después medido. Sin cambiar de stack ni reescribir el proyecto.
6. APIs: latencia heredada y cascadas invisibles
El segundo gran sumidero de tiempo son las llamadas a servicios externos. Aquí el rendimiento deja de estar bajo tu control, y por eso la auditoría se centra menos en acelerar y más en aislar: garantizar que la lentitud ajena no se convierta en lentitud propia.
6.1 Llamadas síncronas sin timeout: el fallo más caro
Es el hallazgo que más veces hemos convertido en una mejora inmediata. Una integración con un ERP, una pasarela o un servicio de stock llamada de forma síncrona dentro de la petición del usuario, con el timeout por defecto de la librería HTTP —que en algunos casos es infinito o de 30 segundos—. Mientras ese servicio responda en 80 ms nadie se entera; el día que se degrada a 8 segundos, tus workers PHP-FPM se quedan todos ocupados esperando y el sitio entero cae, aunque tu código no tenga ningún problema.
Las contramedidas son conocidas y baratas: timeouts agresivos y explícitos (conexión y lectura por separado), un circuit breaker que deje de llamar tras N fallos consecutivos, degradación elegante que sirva el último dato conocido en lugar de un error, y mover a cola todo lo que no sea imprescindible para pintar la respuesta. La seguridad y el rendimiento se tocan aquí de forma directa: lo tratamos también desde el otro ángulo en la guía sobre seguridad de APIs empresariales y auditoría técnica.
6.2 N+1 sobre HTTP y cascadas de dependencias
El patrón N+1 también existe fuera de la base de datos, y es bastante peor: una vista que consulta el precio o el stock de cada producto llamando al servicio externo una vez por producto. Con 40 productos y 60 ms por llamada son 2,4 segundos que ningún índice va a arreglar. La solución pasa por endpoints de lote, por caché de objeto con TTL corto o por precálculo asíncrono.
Relacionado: las cascadas de dependencias. El servicio A llama al B, que llama al C. Si cada uno añade 100 ms y su propio margen de reintentos, el usuario espera cerca de un segundo por una operación que en teoría es trivial. En la auditoría se dibuja el grafo de llamadas y se busca qué puede paralelizarse, qué puede cachearse y qué directamente no debería estar en el camino crítico.
7. Caché: cuatro niveles y sus trampas
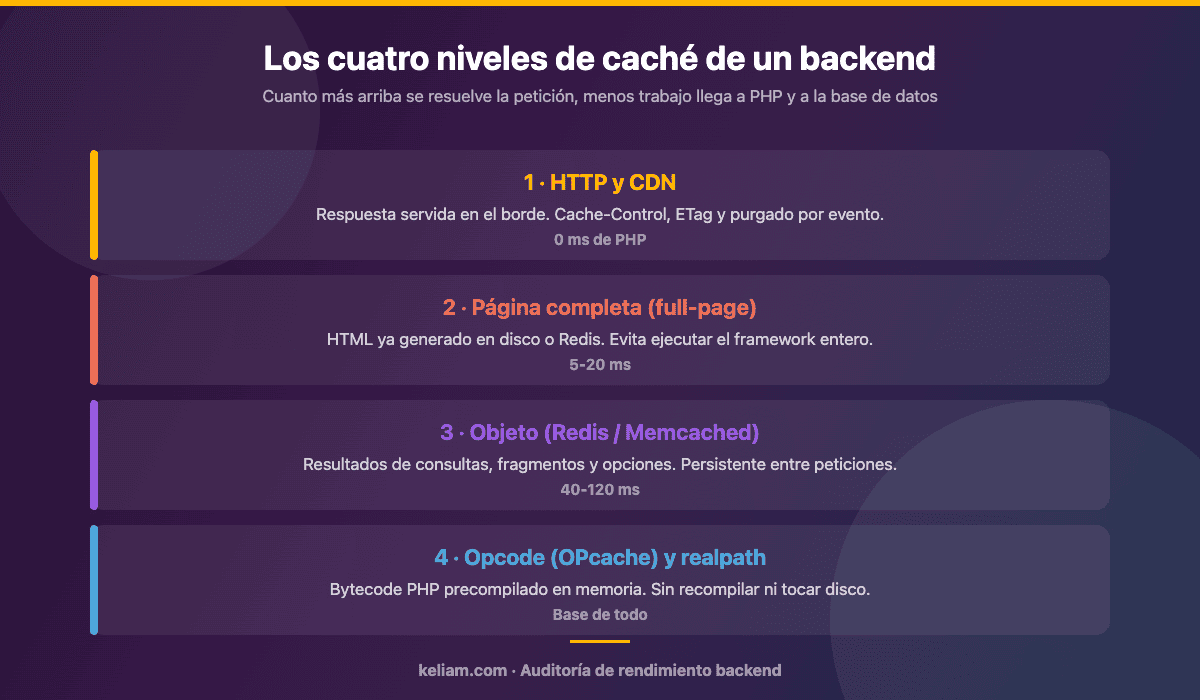
La caché es la palanca de mayor retorno de una auditoría de rendimiento backend, y también la fuente de los bugs más difíciles de diagnosticar. La forma sana de auditarla es por niveles, entendiendo qué se resuelve en cada uno y qué carga deja pasar al siguiente.
7.1 Qué revisar en cada nivel
En el nivel HTTP y CDN, la auditoría comprueba la tasa de aciertos real (no la configurada), qué cabeceras está enviando la aplicación y, sobre todo, qué está impidiendo cachear. El clásico: una cookie de sesión emitida en todas las peticiones, incluso a usuarios anónimos, que anula la caché de borde para el 100 % del tráfico. Otro clásico: parámetros de campaña en la URL que fragmentan la caché en miles de variantes inútiles.
En el nivel de página completa, se revisa qué rutas están excluidas y por qué. Es habitual encontrar exclusiones añadidas hace años para arreglar un bug puntual que hoy dejan fuera media plataforma. Cuando hay contenido personalizado, la técnica correcta no es desactivar la caché entera sino aislar los fragmentos dinámicos (ESI, inyección por JavaScript o hole punching).
En la caché de objeto, lo primero es verificar que exista: una plataforma con tráfico serio sin Redis o Memcached está guardando transients y resultados en la propia base de datos, es decir, aliviando la carga de la base con la base. Después se mira el ratio de aciertos, la política de expulsión y el tamaño de los objetos guardados: cachear un objeto de 4 MB que se deserializa en cada petición puede ser más lento que recalcularlo.
Y en el nivel de opcode, la verificación que ya vimos en la sección 4.3. Es el nivel más barato de arreglar y el que más veces está mal.
7.2 Las dos trampas: invalidación y estampida
La primera trampa es la invalidación por tiempo cuando debería ser por evento. Un TTL de 10 minutos sobre el precio de un producto significa que durante 10 minutos puedes estar vendiendo a un precio antiguo. La auditoría distingue qué datos toleran caducidad temporal y cuáles exigen purgado explícito al cambiar.
La segunda es la cache stampede: cuando una entrada muy solicitada expira, todas las peticiones simultáneas fallan el acierto a la vez y se lanzan a regenerarla, multiplicando la carga justo en el peor momento. Las soluciones son un bloqueo de regeneración (solo un proceso recalcula, el resto sirve el valor caducado), o el patrón de refresco anticipado con probabilidad creciente conforme se acerca la expiración.
8. Concurrencia: PHP-FPM, workers y trabajo asíncrono
Un backend puede ser rápido con una petición y desastroso con cincuenta. Esa diferencia rara vez está en el código: está en cómo se dimensionan los procesos y en cuánto trabajo se está haciendo dentro del ciclo de petición que no debería estar ahí.
8.1 La aritmética de PHP-FPM
El parámetro pm.max_children se configura demasiadas veces «a lo que venía» o «a lo que puso el proveedor». El cálculo correcto es simple: memoria disponible para PHP dividida entre la memoria media real por proceso (medida, no supuesta: ps o el propio status de FPM). Si el resultado son 20 workers y tienes configurados 80, bajo carga el servidor empezará a hacer swap y la latencia se disparará de forma no lineal —que es la forma técnica de decir que el sitio se cae—.
Conviene además exponer y vigilar el status page de PHP-FPM: procesos activos, cola de escucha y el máximo histórico de procesos activos. Si la cola de escucha es mayor que cero de forma sostenida, estás sirviendo peticiones que ya han esperado antes de que tu código se ejecute, y ninguna optimización de PHP lo va a arreglar.
8.2 Sacar trabajo del ciclo de petición
El principio general es que el usuario solo debe esperar lo imprescindible para ver una respuesta correcta. Todo lo demás —enviar el correo de confirmación, sincronizar con el ERP, regenerar miniaturas, recalcular informes, notificar a un webhook— debería ejecutarse en cola con reintentos y observabilidad propia.
En el ecosistema PHP hay opciones maduras para esto (Symfony Messenger, Laravel Queues, Action Scheduler en WooCommerce, o directamente RabbitMQ y Redis con workers dedicados). Un caso muy frecuente y muy rentable de la auditoría es el wp-cron de WordPress: al ejecutarse por visita, en sitios con poco tráfico las tareas no se lanzan y en sitios con mucho se lanzan de más; sustituirlo por un cron real del sistema es un cambio de cinco minutos con efecto medible.
9. Pruebas de carga: comprobar la hipótesis antes de que lo haga el tráfico
Medir en producción con el tráfico real es imprescindible, pero no basta: no puedes esperar al Black Friday para descubrir el techo. Las pruebas de carga cierran ese hueco y son la única forma honesta de responder a «¿cuánto aguanta esto?».
Las herramientas habituales son k6 (escenarios en JavaScript, excelente para CI), Locust (escenarios en Python, cómodo para lógica compleja de usuario), Gatling y, para pruebas rápidas de un único endpoint, ab o wrk. La elección importa mucho menos que la metodología:
- Escenarios realistas: navegación, búsqueda, añadir al carrito y checkout en la proporción que refleje tu analítica, no 10.000 peticiones a la home.
- Carga creciente por escalones hasta encontrar el punto de saturación, no un pico único que solo dice si aguanta o no.
- Entorno equivalente a producción en recursos y datos. Una prueba contra una base de datos con 500 productos no dice nada sobre un catálogo de 80.000.
- Datos de prueba variados: repetir siempre la misma URL mide tu caché, no tu aplicación.
- Vigilar el backend mientras corre la prueba: si no miras CPU, memoria, workers ocupados y conexiones de base de datos durante la ejecución, solo obtendrás un número sin diagnóstico.
Si tu plataforma es un ecommerce y el objetivo es la campaña, el ejercicio se solapa con la preparación de picos y con el trabajo de conversión que describimos al hablar de cómo optimizar el checkout: un checkout que tarda tres segundos por petición no solo es lento, es directamente facturación perdida.
10. El entregable: de los hallazgos al plan priorizado
Una auditoría que termina en una lista de 60 observaciones técnicas no sirve de nada. El valor está en convertir la medición en decisiones que alguien pueda aprobar, presupuestar y verificar.
10.1 Estructura del informe
El informe que entregamos en Keliam tiene siempre las mismas piezas: un resumen ejecutivo de una página con el estado actual frente al presupuesto de rendimiento y el riesgo de negocio asociado; el detalle de la medición con percentiles por endpoint, distribución del tiempo y capacidad estimada; el catálogo de hallazgos, cada uno con evidencia (traza, perfil, consulta), impacto estimado en milisegundos y esfuerzo en jornadas; y el plan de remediación por fases.
La priorización usa una matriz de impacto frente a esfuerzo. Las victorias rápidas —OPcache mal configurado, un índice que falta, un timeout ausente, cron mal montado— suelen concentrar entre el 40 % y el 60 % de la mejora total y se ejecutan en días. Las reformas estructurales —rediseñar un esquema, extraer un proceso a cola, introducir caché de objeto donde no la hay— van a una segunda fase con estimación propia.
10.2 Verificar y no volver atrás
Todo hallazgo remediado se vuelve a medir con el mismo método con el que se detectó, y la comparación entra en el informe. Sin ese antes y después, la auditoría es una opinión cara.
Y queda la parte que más se olvida: evitar la regresión. Un backend optimizado vuelve a degradarse en doce meses si no hay nada que lo impida. Las medidas que funcionan son tres: presupuestos de rendimiento comprobados en CI (que la pull request falle si un endpoint clave supera su umbral), alertas sobre p95 por endpoint en el APM en lugar de sobre medias globales, y una revisión trimestral de las consultas más costosas. Es el mismo enfoque de mejora continua que aplicamos en el desarrollo seguro según ISO 27001 y el ENS: medir, corregir y volver a medir de forma sistemática, no como reacción a un incidente.
Conclusión
La mayoría de los proyectos de rendimiento fracasan por el mismo motivo: se empieza optimizando en lugar de midiendo. Una auditoría de rendimiento backend bien ejecutada invierte el orden —instrumenta, mide en percentiles, perfila las rutas caras, identifica la causa real y solo entonces toca código— y por eso consigue mejoras que se sostienen en el tiempo.
La buena noticia es que el reparto de esfuerzo suele ser favorable. En la mayoría de las plataformas que auditamos, un puñado de correcciones baratas —configuración del intérprete, dos o tres índices, una caché de objeto que no existía, timeouts en las integraciones y un par de N+1 eliminados— recorta el TTFB a la mitad o menos. Lo estructural viene después, con datos en la mano y sin decisiones a ciegas.
Si tu plataforma va lenta y las optimizaciones de frontend ya no dan más de sí, el siguiente paso es mirar debajo. Y para eso hay que medir antes de tocar.
Preguntas frecuentes
¿Cuánto dura una auditoría de rendimiento backend?
Para una plataforma de tamaño medio, entre una y tres semanas: unos días de instrumentación y recogida de datos con tráfico real, una semana de análisis y profiling, y unos días de redacción del informe y validación con el equipo. Las victorias rápidas suelen poder ejecutarse durante el propio proyecto.
¿Hace falta parar el servicio o desplegar en producción?
No. La instrumentación con APM o con samplers como Excimer tiene sobrecarga baja y se despliega como cualquier otro cambio. El profiling puntual se activa por petición concreta. Lo único que requiere ventana acordada son las pruebas de carga, si se hacen contra producción en lugar de contra un entorno réplica.
¿Sirve para WordPress y WooCommerce o solo para aplicaciones a medida?
Sirve para ambos, con distinto foco. En WordPress y WooCommerce el análisis se centra mucho en plugins, hooks, opciones autocargadas, caché de objeto y estructura de metadatos; en aplicaciones a medida, en el ORM, la arquitectura de servicios y el diseño del esquema. La metodología de medición es la misma.
¿Merece la pena si el problema se soluciona ampliando el servidor?
Ampliar el servidor es una solución legítima y a veces la más barata a corto plazo, pero solo funciona con problemas de saturación de recursos. Si la causa es un N+1, una consulta sin índice o una llamada externa sin timeout, doblar la CPU no cambiará el tiempo de respuesta y sí la factura mensual. La auditoría precisamente sirve para saber en cuál de los dos casos estás antes de gastar.