
Una web lenta no se nota en el balance de un solo día, pero se nota en el del trimestre. Se nota en el porcentaje de usuarios que abandonan antes de que cargue la ficha de producto, en las páginas que Google indexa pero no posiciona y en el ruido de fondo de las quejas de soporte que nadie llega a registrar como incidencia. La auditoría de rendimiento web es el proceso que convierte esa sensación difusa en una lista de problemas concretos, medidos y priorizados.
Esta guía recorre las métricas que realmente importan hoy, las herramientas con las que se miden, los problemas que aparecen una y otra vez en proyectos reales y cómo convertir todo eso en un plan de trabajo ordenado. No es una lista de trucos: es el método que seguimos en Keliam cuando un cliente nos pide averiguar por qué su plataforma va lenta y qué hacer al respecto, en el mismo orden en que lo aplicamos.
El rendimiento web ya no es opcional: afecta a SEO, conversiones y UX
Google usa las Core Web Vitals como factor de ranking desde 2021. Amazon demostró que 100ms adicionales de latencia reducen las ventas un 1%. El rendimiento web no es un capricho técnico: es un factor directo de negocio que afecta a tu posicionamiento, tus conversiones y la satisfacción de tus usuarios.
Conviene entender bien el peso de ese factor de ranking, porque se malinterpreta con frecuencia en las dos direcciones. Las Core Web Vitals forman parte de las señales de experiencia de página, y Google ha sido explícito en que la relevancia del contenido pesa más: una página excelente y lenta seguirá por delante de una página mediocre y rápida. Pero entre dos páginas que compiten por la misma intención de búsqueda con contenido comparable —que es la situación real en casi cualquier sector competido— la experiencia de página sí desempata. Y el desempate ocurre justo donde más duele: en las posiciones 3 a 10, que es donde se juega la mayor parte del tráfico orgánico de una web consolidada.
El efecto sobre la conversión es más directo todavía y no depende de ningún algoritmo. Cada segundo de espera introduce un punto de fuga: usuarios que vuelven atrás, que abren la competencia en otra pestaña, que abandonan el carrito en el paso de pago porque la pasarela tarda en responder y sospechan que algo ha fallado. En comercio electrónico el patrón es especialmente cruel, porque las páginas más lentas suelen ser precisamente las más cercanas a la compra: listados con muchos filtros, fichas con galerías pesadas y procesos de checkout cargados de scripts de terceros.
Hay además un tercer efecto que rara vez se contabiliza: el coste operativo. Una web lenta suele serlo porque hace trabajo innecesario —consultas repetidas a base de datos, recursos que se descargan y no se usan, procesos sin caché— y ese trabajo se paga en servidores, en ancho de banda y en horas de equipo dedicadas a apagar fuegos. Optimizar el rendimiento casi siempre reduce la factura de infraestructura como efecto colateral.
Las métricas que importan: Core Web Vitals
LCP (Largest Contentful Paint): mide cuándo el elemento más grande del viewport está renderizado. Objetivo: menos de 2.5 segundos. INP (Interaction to Next Paint): mide la latencia de las interacciones del usuario. Objetivo: menos de 200ms. CLS (Cumulative Layout Shift): mide la estabilidad visual. Objetivo: menos de 0.1. Estas tres métricas determinan tu puntuación en Google Search Console.
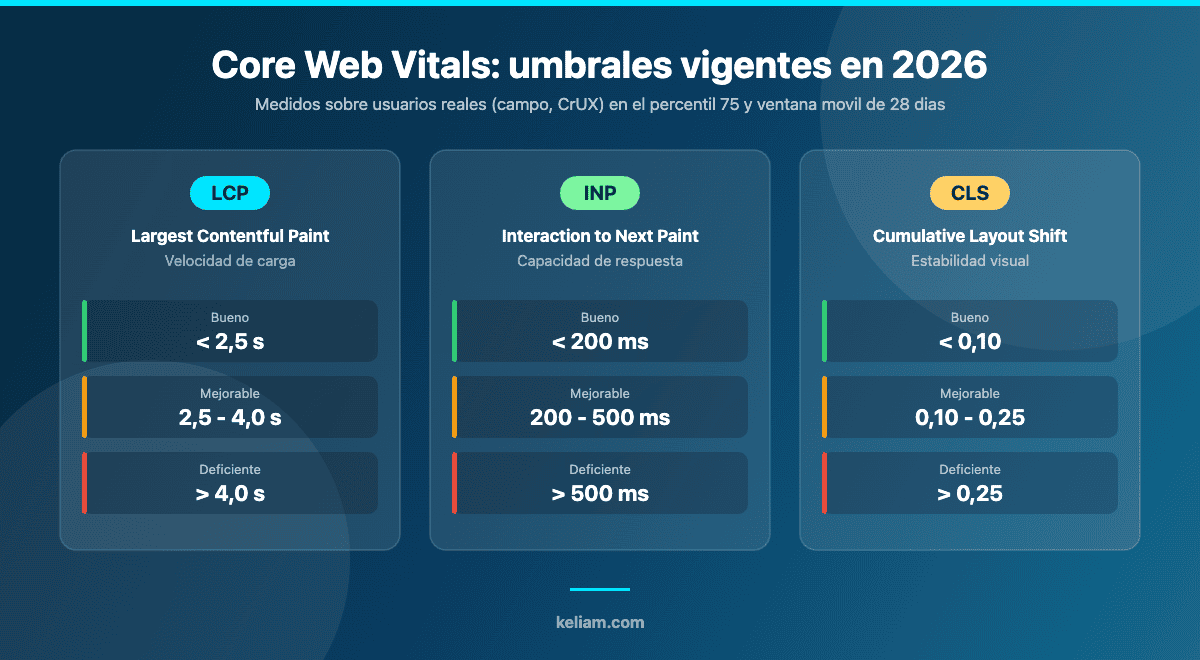
Sobre esos tres números conviene añadir algunos matices que marcan la diferencia entre medir bien y medir mal. El primero es el percentil 75: Google no evalúa la media de tus visitas, sino el valor por debajo del cual queda el 75% de ellas. Es decir, tu nota la pone el cuartil de usuarios peor servidos. Eso explica una frustración habitual: la web va perfecta en la oficina, con fibra y un portátil reciente, y sin embargo Search Console marca la URL como deficiente. La diferencia está en los usuarios con móviles modestos y redes móviles saturadas, que en muchos proyectos españoles son la mayoría del tráfico real.
El segundo matiz es la ventana de 28 días. Los datos de campo se agregan en una ventana móvil de cuatro semanas, así que una corrección desplegada hoy no se reflejará completamente hasta casi un mes después. Este desfase provoca decisiones equivocadas: el equipo optimiza, no ve movimiento en Search Console a los tres días, concluye que no ha servido de nada y revierte el cambio justo antes de que empezara a notarse. La regla práctica es sencilla: valida el efecto en laboratorio de inmediato y confirma en campo pasadas cuatro semanas.
El tercero afecta a INP, la métrica más incomprendida de las tres. Sustituyó a FID (First Input Delay) en marzo de 2024 y el cambio fue mucho más exigente de lo que parecía. FID solo medía el retardo de la primera interacción y solo hasta que el navegador empezaba a procesarla; INP mide todas las interacciones de la sesión y hasta que el resultado se pinta en pantalla. Muchas webs que lucían un FID impecable descubrieron un INP desastroso, porque el problema nunca estuvo en el primer clic sino en los menús desplegables, los filtros de catálogo y los formularios con validación en JavaScript.
Métricas de apoyo que no son Core Web Vitals pero explican el porqué
Las tres métricas principales te dicen qué va mal; para saber por qué necesitas las de diagnóstico. TTFB (Time to First Byte) mide cuánto tarda el servidor en empezar a responder y suele ser la primera sospechosa cuando el LCP es malo en todas las páginas por igual: si el TTFB ya se come 800 ms, el LCP no bajará de 2,5 s por mucho que optimices imágenes. FCP (First Contentful Paint) marca el primer píxel con contenido y ayuda a separar problemas de servidor de problemas de render bloqueado. TBT (Total Blocking Time) es el sustituto de INP en laboratorio, porque INP necesita interacciones reales y en un test automatizado no las hay.
Esta distinción entre datos de laboratorio y datos de campo es probablemente el concepto que más errores evita. Los datos de laboratorio se obtienen simulando una carga en condiciones controladas: son reproducibles, sirven para comparar antes y después de un cambio y detectan regresiones, pero no representan a tus usuarios. Los datos de campo proceden de navegaciones reales —el informe CrUX de Chrome, o tu propia instrumentación RUM— y son los que Google utiliza para evaluar la experiencia de página. Un proyecto serio usa los dos: laboratorio para iterar rápido, campo para decidir si el trabajo ha servido.
Si quieres profundizar en la interpretación de estas métricas y en cómo se traducen a acciones concretas, lo desarrollamos en detalle en nuestra guía sobre Core Web Vitals e INP en 2026 y en el artículo sobre cómo mejorar el rendimiento web de cara a Google.
Herramientas de diagnóstico
Google PageSpeed Insights combina datos de laboratorio (Lighthouse) con datos reales de usuarios (CrUX). WebPageTest permite tests desde múltiples ubicaciones y dispositivos con waterfalls detallados. Chrome DevTools Performance tab para debugging local detallado. Google Search Console muestra la experiencia real de tus usuarios agrupada por tipo de página.
Cómo usar cada una sin duplicar trabajo
El error más común es abrir PageSpeed Insights, mirar el número grande de colores y quedarse ahí. Esa puntuación de 0 a 100 es una media ponderada de métricas de laboratorio y resulta muy volátil: dos ejecuciones seguidas de la misma URL pueden diferir en diez o quince puntos por variaciones de red y de carga del servidor. Tomar decisiones sobre esa cifra lleva a perseguir ruido. Lo útil de PageSpeed Insights está más abajo: el bloque de datos de campo, cuando la URL tiene tráfico suficiente para aparecer en CrUX, y la lista de diagnósticos con el ahorro estimado de cada uno.
Search Console es la herramienta con la que conviene empezar una auditoría, no la última. Su informe de Core Web Vitals agrupa todas las URLs del sitio en grupos de páginas con comportamiento similar, lo que permite ver de un vistazo si el problema es transversal —plantilla, tema, hosting— o está localizado en un tipo concreto de página. Auditar URL por URL sin ese mapa previo es una forma eficaz de perder una semana optimizando la página equivocada.
WebPageTest es la herramienta de precisión. Permite fijar ubicación, dispositivo, velocidad de conexión y número de repeticiones, y entrega un waterfall donde se ve exactamente qué recurso bloquea a cuál. Es donde se resuelven los casos difíciles: cadenas de peticiones encadenadas, redirecciones invisibles, certificados que añaden latencia, scripts de terceros que se descargan otros scripts. Su modo de comparación entre dos URLs, con tiras de fotogramas lado a lado, es además la mejor forma de enseñar una mejora a alguien que no es técnico.
Chrome DevTools cierra el círculo en local. El panel Performance permite grabar una interacción concreta y ver qué tarea larga está bloqueando el hilo principal, que es como se diagnostican de verdad los problemas de INP. La pestaña Coverage indica qué porcentaje de cada archivo CSS y JavaScript se ha llegado a usar realmente, y suele deparar sorpresas incómodas: no es raro encontrar hojas de estilo con un 90% de reglas que nunca se aplican.
Actualización 2026: qué ha cambiado en el instrumental
Las herramientas han evolucionado bastante desde la primera versión de este artículo, y hay tres cambios que afectan a cómo se lee un informe hoy.
El primero es el salto a Lighthouse 13, que llegó a PageSpeed Insights en octubre de 2025. Además de incorporar TTFB e INP al conjunto de métricas reportadas, ajustó el factor de CPU throttling para acercarlo al rendimiento de los dispositivos reales. La consecuencia práctica pilló desprevenido a mucha gente: webs que no habían tocado una línea de código vieron empeorar su TBT y su puntuación móvil de laboratorio de un día para otro. No se habían roto; simplemente la simulación pasó a ser más realista. Si comparas informes anteriores y posteriores a esa fecha, no estás comparando lo mismo.
El segundo es la consolidación de las auditorías de rendimiento con las insights del panel Performance de DevTools. Lighthouse 13 eliminó las auditorías antiguas del informe y del JSON subyacente, de modo que ambas herramientas hablan ya el mismo idioma. Si tienes scripts propios que parsean el JSON de Lighthouse para tus paneles de seguimiento, es muy probable que necesiten revisión.
El tercero es la novedad más llamativa: la categoría Agentic Browsing, que Lighthouse incorporó a su configuración por defecto con la versión 13.3 en mayo de 2026 y que aparece ya en los informes de PageSpeed Insights. No mide velocidad, sino si tu web es navegable por agentes de IA: revisa la coherencia del árbol de accesibilidad, la estabilidad del layout —para que un agente haga clic en el botón correcto y no en el que se ha desplazado— y la presencia de un fichero llms.txt. Tiene dos particularidades importantes: no produce una nota de 0 a 100 sino una proporción de comprobaciones superadas, y no forma parte de la puntuación de rendimiento. Conviene además tomarse el apartado de llms.txt con calma: es un estándar propuesto, no adoptado, y la propia documentación de Google sobre optimización para IA publicada en mayo de 2026 aclara que no es necesario para la Búsqueda. Que Lighthouse lo compruebe no significa que Google lo utilice para posicionar.
Instrumentación propia: RUM
Las herramientas anteriores son suficientes para la mayoría de proyectos, pero a partir de cierto volumen merece la pena instrumentar la web con Real User Monitoring propio. CrUX solo cubre usuarios de Chrome que han aceptado compartir estadísticas y solo publica datos de URLs con tráfico suficiente, así que deja fuera buena parte del catálogo de una tienda mediana. Con la librería web-vitals puedes recoger LCP, INP y CLS de todas tus visitas y enviarlos a tu propio almacén de analítica, segmentados por plantilla, país, dispositivo o tipo de usuario. Ahí es donde aparecen los hallazgos que ninguna herramienta pública te va a dar: que el INP se dispara solo para usuarios logueados, o que el LCP de la página de categoría es aceptable salvo cuando el filtro de marca está activo.
Problemas más comunes
Los culpables habituales son: imágenes sin optimizar (formato, tamaño, lazy loading), JavaScript excesivo o que bloquea el render, CSS no crítico en el head, fuentes web que causan FOIT/FOUT, third-party scripts (analytics, ads, chat widgets), y falta de caché de recursos estáticos.
Merece la pena detenerse en cada uno, porque el orden en que aparecen en esa lista se corresponde bastante bien con la frecuencia con que los encontramos en auditorías reales.
Imágenes: el 40% del problema, casi siempre
Las imágenes siguen siendo la primera causa de LCP alto, y no porque sean difíciles de optimizar sino porque nadie se ocupa. Los tres fallos se repiten: se sirve el original de 3.000 píxeles de ancho a un móvil que muestra 390, se usa JPEG o PNG donde AVIF o WebP pesarían la mitad, y se aplica loading="lazy" indiscriminadamente, incluida la imagen principal de la cabecera. Este último es un error contraintuitivo pero muy caro: la imagen del hero suele ser el elemento LCP, y marcarla como diferida retrasa exactamente la métrica que quieres mejorar. Lo correcto es lo opuesto: loading="eager" y fetchpriority="high" en el LCP, y lazy solo por debajo de la línea de flotación.
A esto se añade la falta de width y height explícitos, que es la causa número uno de CLS: sin esas dimensiones el navegador no puede reservar el espacio y el contenido salta cuando la imagen termina de cargar. Es una corrección de un minuto por plantilla que suele arreglar la métrica entera.
JavaScript y el hilo principal
El JavaScript afecta sobre todo a INP, y el mecanismo es siempre el mismo: tareas largas que monopolizan el hilo principal y dejan al navegador sin capacidad de responder al usuario. Cuando alguien pulsa un botón mientras se está ejecutando una tarea de 400 ms, esa interacción espera. El patrón clásico en webs de contenido es el bundle único que lo incluye todo, cargado en todas las páginas aunque cada plantilla use una fracción. El patrón clásico en ecommerce son los filtros de catálogo que recalculan el DOM completo en cada cambio en lugar de actualizar solo lo necesario.
Las soluciones son conocidas: dividir el código por rutas, cargar bajo demanda lo que no se necesita en el primer render, trocear las tareas largas para ceder el control al navegador entre fragmentos y sacar los cálculos pesados a un Web Worker. Ninguna es exótica; lo que falta casi siempre es el diagnóstico previo que indique qué trocear.
Scripts de terceros: el gasto que no controlas
Analítica, píxeles publicitarios, mapas de calor, chat de soporte, widgets de reseñas, gestores de consentimiento. Cada uno se añadió por una buena razón y ninguno se revisó después. En auditorías de tiendas con algunos años de vida es habitual encontrar quince o veinte scripts externos, varios de ellos duplicados o pertenecientes a herramientas que ya nadie usa. El problema no es solo su peso: es que introducen conexiones a dominios nuevos, pueden cargar más scripts en cascada y, cuando su servidor va lento, arrastran a tu web con él.
La auditoría de terceros es de las tareas con mejor relación resultado/esfuerzo que existen. Listar todos los dominios externos que carga una página, preguntar a negocio cuáles siguen en uso y eliminar el resto suele recortar cientos de kilobytes y varias décimas de segundo sin tocar una línea de código propio. Lo que sobreviva, cárgalo diferido y, cuando sea posible, solo en las páginas donde de verdad haga falta —el widget de chat rara vez necesita estar en el blog entero.
Fuentes web, CSS y caché
Las fuentes web provocan dos síntomas: texto invisible mientras carga la tipografía (FOIT) o texto que cambia de aspecto a mitad de carga (FOUT). La combinación de font-display: swap, precarga del fichero de la fuente principal y subsetting —incluir solo los caracteres que realmente usas— resuelve la mayoría de los casos. Alojar las fuentes en tu propio dominio en lugar de tirar de un CDN externo ahorra además una conexión completa.
Con el CSS el patrón es el inverso al del JavaScript: el navegador no pinta nada hasta tener el CSS, así que una hoja de estilos enorme en el head retrasa el primer render entero. Extraer el CSS crítico de la mitad superior y cargar el resto de forma asíncrona es una técnica antigua y todavía eficaz. Y la caché, finalmente, es el recordatorio más básico: comprobar que los recursos estáticos se sirven con cabeceras de expiración largas y nombres versionados es de las primeras cosas que miramos, porque cuando falla afecta a todas las páginas y a todas las visitas recurrentes.
Plan de optimización por prioridad
Ataca primero lo que más impacta con menos esfuerzo: optimizar imágenes (suele ser el 40% de la mejora), configurar caché de navegador y CDN, eliminar JavaScript y CSS no utilizado, implementar lazy loading para contenido below-the-fold, y diferir la carga de third-party scripts. Después, aborda optimizaciones más complejas: server-side rendering, prefetch/preconnect, y optimización de base de datos.
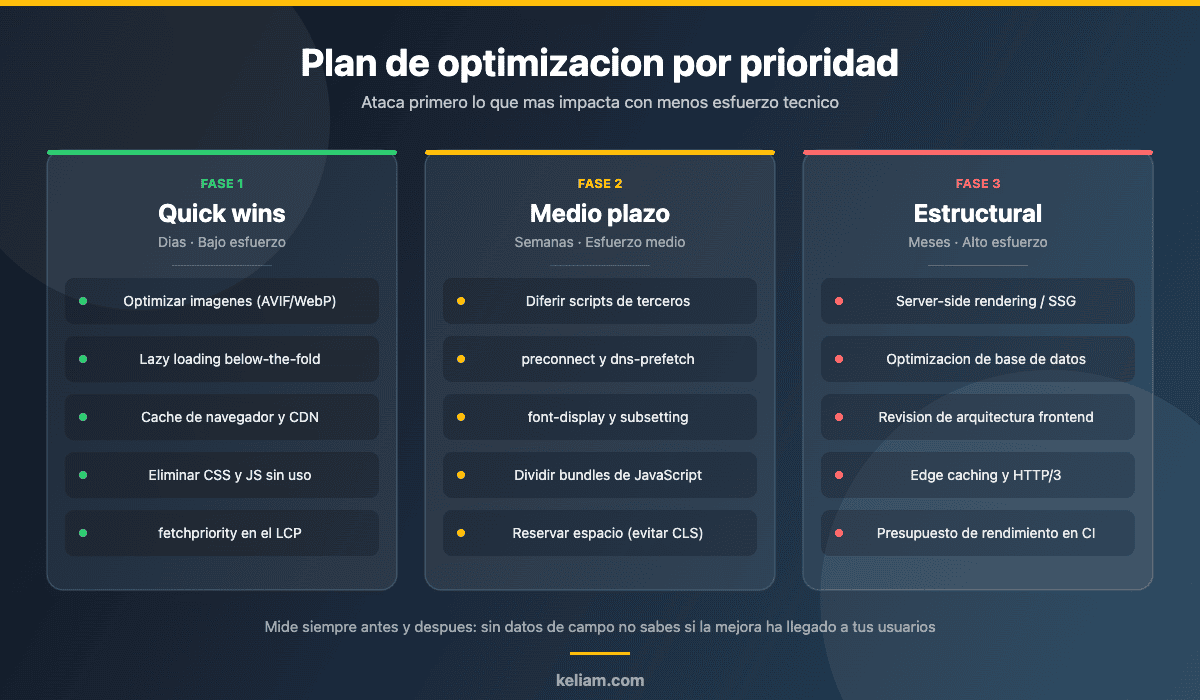
La razón de este orden no es solo técnica, es también organizativa. Una auditoría que entrega veinte recomendaciones sin priorizar suele acabar en un cajón: el equipo no sabe por dónde empezar, las tareas compiten con el roadmap de producto y al cabo de tres meses nada se ha implementado. Empezar por los quick wins genera resultados medibles en la primera o segunda semana, y esos resultados son los que consiguen que se aprueben las fases siguientes.
En la fase 1 entran los cambios que no requieren tocar la arquitectura: formatos de imagen, dimensiones correctas, prioridades de carga, cabeceras de caché, CDN y limpieza de scripts muertos. Se pueden abordar en días y no suelen necesitar más que un despliegue de configuración. En la fase 2 están los cambios que implican tocar el frontend con cierta profundidad: dividir bundles, revisar la estrategia de fuentes, reservar espacio para elementos dinámicos, establecer preconnect hacia los dominios críticos. Semanas de trabajo y pruebas. La fase 3 agrupa lo estructural: renderizado en servidor, revisión del modelo de datos y de las consultas, caché en el edge, migración a HTTP/3 y la incorporación de un presupuesto de rendimiento al pipeline de integración continua.
Ese último punto merece una nota aparte porque es el que evita repetir la auditoría dentro de un año. Un presupuesto de rendimiento es un conjunto de límites acordados —por ejemplo, 200 KB de JavaScript comprimido en la home, LCP de laboratorio por debajo de 2 s— que se comprueban automáticamente en cada pull request. Herramientas como Lighthouse CI permiten fallar la build cuando se supera el límite. Es la diferencia entre optimizar una vez y mantenerse optimizado.
Qué cambia según la plataforma
El método es el mismo en todas partes, pero los cuellos de botella habituales dependen mucho de la tecnología. En WordPress y WooCommerce el problema suele ser acumulativo: plugins que cargan sus assets en todas las páginas, temas que incluyen bibliotecas enteras para usar un componente y una tabla de opciones sobrecargada; en tiendas con mucho pedido, además, conviene revisar si está activo el almacenamiento de pedidos de alto rendimiento (HPOS), y en proyectos recientes vale la pena mirar cómo afectan los cambios de bloques y medios de WordPress 7. En PrestaShop el foco está en la caché de plantillas, el número de módulos activos y las consultas del buscador de productos, como detallamos en la guía técnica de rendimiento para PrestaShop.
En Magento el tamaño del catálogo domina el diagnóstico: indexadores, caché completa de página y estrategia de capas de navegación, que abordamos en el artículo sobre optimización de Magento 2 con catálogos grandes. En Drupal la conversación gira alrededor de la caché en varios niveles y del render diferido, tal como explicamos en optimización de rendimiento en Drupal con caché, BigPipe y Varnish. Y en Shopify, donde no controlas el servidor, casi todo el margen está en el tema y en las apps instaladas: lo tratamos en la guía para optimizar la velocidad de una tienda Shopify.
¿Tu web va lenta y no sabes por dónde empezar?
En Keliam auditamos el rendimiento de plataformas web y ecommerce con datos de campo y de laboratorio, y entregamos un plan priorizado por impacto y esfuerzo, no una lista genérica de recomendaciones.
Errores frecuentes al interpretar una auditoría
Hemos visto fallar más auditorías por interpretación que por medición. Estos son los tropiezos que más se repiten.
Perseguir el 100 de PageSpeed. La puntuación es una media ponderada de métricas de laboratorio con un margen de variabilidad considerable. Pasar de 85 a 95 puede no suponer ninguna diferencia perceptible para un usuario real, mientras que pasar de 40 a 70 sí. Por encima de cierto umbral, el esfuerzo marginal deja de compensar y es mejor invertirlo en otra parte.
Medir solo la home. Casi nunca es la página con problemas. El tráfico orgánico entra por fichas de producto, artículos y páginas de categoría, que además suelen ser las plantillas más pesadas. Audita al menos una URL representativa de cada tipo de plantilla.
Confundir una mejora de laboratorio con una mejora real. Si el cambio no se refleja en los datos de campo pasadas cuatro semanas, no ha llegado a los usuarios. A veces porque la optimización solo aplicaba a un escenario que apenas se da, y a veces porque un despliegue posterior la deshizo sin que nadie se diera cuenta.
Optimizar sin medir antes. Sin una línea base no hay forma de demostrar el resultado ni de detectar que algo empeoró. Guarda los informes de partida —capturas, JSON de Lighthouse, exportación de Search Console— antes de tocar nada.
Tratarlo como un proyecto cerrado. Es el error más caro y el que enlaza con el último apartado.
Monitorización continua
Una auditoría puntual no es suficiente. Implementa monitoring continuo de rendimiento: alertas cuando las Core Web Vitals se degradan, tests de rendimiento en el pipeline de CI/CD para detectar regresiones antes del despliegue, y revisiones mensuales de las métricas en Search Console. El rendimiento es una carrera continua, no un proyecto puntual.
En la práctica, un esquema de seguimiento que funciona tiene tres capas. La diaria y automática: comprobación sintética de un puñado de URLs representativas con alertas cuando una métrica cruza el umbral, de modo que una regresión se detecte el mismo día y no cuando alguien se queja. La por despliegue: Lighthouse CI contra el presupuesto de rendimiento acordado, que impide que el problema llegue a producción. Y la mensual y manual: media hora revisando el informe de Search Console, comparando la evolución de los grupos de URLs y comprobando si han aparecido scripts de terceros nuevos —porque marketing instala herramientas y rara vez avisa a desarrollo.
Esa revisión mensual es también el momento de contrastar el rendimiento con el resto de la salud técnica del proyecto. Una auditoría de rendimiento aislada deja fuera cosas que acaban afectándole: deuda técnica acumulada, dependencias sin actualizar, arquitectura que ya no da más de sí. Lo tratamos en el artículo sobre qué se analiza en una auditoría técnica de software, y en el caso concreto de tiendas online en la auditoría SEO para ecommerce y en la guía completa de SEO técnico para ecommerce, donde rendimiento e indexación se cruzan constantemente.
Preguntas frecuentes
¿Cuánto tarda en notarse una mejora de rendimiento en Google?
En los datos de campo de Search Console, entre cuatro y ocho semanas: la ventana de agregación es de 28 días y la actualización del informe añade algo de retraso. El efecto sobre posiciones, cuando lo hay, es posterior y más difícil de aislar del resto de factores. En laboratorio, en cambio, la mejora se ve en la siguiente ejecución.
¿La puntuación de PageSpeed Insights es un factor de ranking?
No. Lo que Google utiliza son las Core Web Vitals medidas sobre usuarios reales, no la nota de laboratorio de 0 a 100. Puedes tener una puntuación mediocre y unas Core Web Vitals correctas, y también lo contrario.
¿Hay que preocuparse por la categoría Agentic Browsing?
Hoy es informativa: no puntúa de 0 a 100 ni entra en la nota de rendimiento. Merece la pena leerla porque casi todo lo que comprueba —árbol de accesibilidad coherente, layout estable, estructura clara— beneficia también a usuarios humanos. Lo que no recomendamos es reorganizar una web alrededor de llms.txt, que sigue siendo un estándar propuesto sin adopción confirmada por los grandes proveedores.
¿Cada cuánto conviene repetir una auditoría completa?
Con monitorización continua y presupuesto de rendimiento en CI, una revisión en profundidad al año suele bastar. Sin esas dos cosas, cada seis meses, porque la degradación es silenciosa y constante: cada plugin nuevo, cada script de marketing y cada campaña con imágenes sin optimizar suma unas décimas.
Conclusión
Una auditoría de rendimiento útil no es la que produce el informe más largo, sino la que produce la lista de acciones más corta y mejor ordenada. El camino es siempre el mismo: partir de los datos de campo para saber qué grupos de páginas fallan, bajar al laboratorio para entender por qué, priorizar por impacto frente a esfuerzo y dejar montado un sistema de vigilancia que impida volver al punto de partida.
Los umbrales de las Core Web Vitals no han cambiado y probablemente no cambien pronto, pero sí lo han hecho el instrumental y el contexto: Lighthouse mide con más realismo que hace un año, INP castiga cosas que FID perdonaba y han aparecido categorías nuevas que miran la web desde la perspectiva de agentes automáticos. Lo que no cambia es el fondo del asunto: cada décima de segundo que le ahorras a un usuario es una décima de segundo que no tiene para arrepentirse.