Hay una escena que se repite en casi todas las empresas con una plataforma web crítica. Un cliente llama diciendo que el checkout va lento. Alguien del equipo abre la web, prueba, y le funciona bien. Se mira el panel del hosting: CPU al 30%, todo verde. Se pregunta en el canal de desarrollo si alguien ha tocado algo. Silencio. Media hora después el problema desaparece solo y nadie sabe qué ha pasado. Dos semanas más tarde vuelve a ocurrir, esta vez un viernes de campaña, y ya no desaparece solo.
Ese es el coste real de no tener observabilidad: no es que el sistema falle —todos los sistemas fallan—, es que cuando falla no hay forma de saber por qué sin recurrir a la intuición, al ensayo y error y a las horas del desarrollador con más antigüedad. La monitorización clásica responde a la pregunta ¿está caído?. La observabilidad responde a una mucho más útil: ¿por qué se está comportando así?, incluso cuando el problema es uno que nadie había previsto.
En esta guía vamos a bajar el concepto al terreno de una web de negocio real: una tienda online, un portal corporativo con integraciones, una plataforma SaaS de tamaño medio. Nada de arquitecturas de mil microservicios ni de presupuestos de compañía cotizada. Veremos qué son de verdad los tres pilares —métricas, logs y trazas—, qué merece la pena medir, qué stack elegir según el tamaño del equipo, cómo implantarlo en 90 días sin parar el desarrollo de producto y cómo evitar que la factura de telemetría acabe costando más que los servidores que vigila.
1. Observabilidad y monitorización no son lo mismo
Los dos términos se usan como sinónimos en el material comercial de las herramientas, pero la diferencia práctica es grande y condiciona las decisiones técnicas que vas a tomar.
Monitorizar es comprobar de forma continua un conjunto de condiciones que has definido de antemano: que el servidor responde, que el disco no pasa del 85%, que el certificado no caduca, que el proceso está vivo. Son preguntas cerradas con respuesta binaria, y se resuelven con paneles y alertas fijas.
Observar es otra cosa: es diseñar el sistema para que emita suficiente información como para poder hacerle preguntas nuevas, que no habías anticipado, sin desplegar código adicional. Si mañana alguien pregunta «¿por qué los usuarios que pagan con Bizum desde Android tardan el doble en el paso 3 del checkout?», un sistema observable puede contestar con los datos que ya está emitiendo. Un sistema solo monitorizado obliga a añadir logs, desplegar y esperar a que el problema vuelva a ocurrir.
1.1 Lo conocido y lo desconocido
La forma más clara de entenderlo es la vieja clasificación de los cuatro cuadrantes. Los known knowns son los problemas que conoces y ya vigilas: el disco se llena, el certificado caduca. Los known unknowns son problemas que sabes que pueden ocurrir aunque no sepas cuándo: una query se degrada al crecer la tabla. Para ambos basta con monitorización bien puesta.
El terreno donde vive la observabilidad son los unknown unknowns: la combinación de una promoción, un bot rastreando el catálogo, una caché mal invalidada y un proveedor externo con latencia alta, todo a la vez. Nadie escribe una alerta para eso. Solo se puede diagnosticar si puedes explorar los datos de forma libre, cruzando dimensiones que no habías definido de antemano.
1.2 Por qué importa en una web de negocio
Existe la idea de que la observabilidad es cosa de sistemas distribuidos enormes. Es al revés: cuanto más pequeño es el equipo, más valiosa es, porque no hay diez personas para dedicar una tarde entera a reproducir un incidente. En una plataforma de comercio o en un portal con integraciones a CRM, ERP y pasarela de pago, la superficie de fallo ya es distribuida aunque el código viva en un monolito. Cada llamada a un sistema externo es un punto donde el tiempo puede irse sin que nadie lo vea.
Si además tu plataforma ha crecido hacia una arquitectura de microservicios, el problema se multiplica: una petición de usuario se convierte en ocho o diez llamadas internas, y sin trazas distribuidas localizar el eslabón lento es literalmente adivinar.
2. Los tres pilares: métricas, logs y trazas
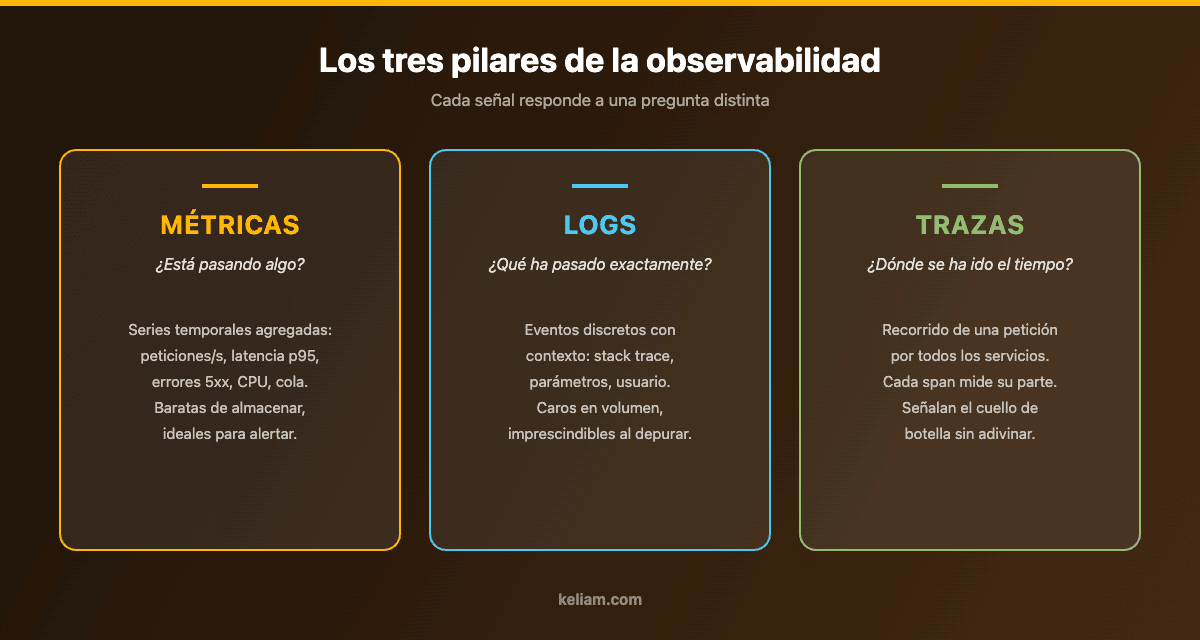
La telemetría de un sistema se organiza en tres tipos de señal. Tener las tres no es un lujo: cada una resuelve una fase distinta del diagnóstico, y con dos de las tres siempre te falta el paso intermedio.
2.1 Métricas: el sistema nervioso
Una métrica es un valor numérico agregado en el tiempo: peticiones por segundo, latencia del percentil 95, errores 5xx por minuto, profundidad de una cola, memoria usada. Son extremadamente baratas de almacenar porque no guardan el detalle de cada evento, solo el agregado por intervalo, y por eso se pueden conservar durante meses sin que el coste se dispare.
Su uso natural es alertar y ver tendencias. Un consejo que ahorra disgustos: olvida la media. La latencia media es una métrica que miente sistemáticamente, porque una mayoría de respuestas rápidas esconde la cola de peticiones lentas que son justo las que sufren tus clientes. Trabaja siempre con percentiles: p50 para el comportamiento típico, p95 y p99 para lo que de verdad genera llamadas a soporte.
El otro error clásico es la explosión de cardinalidad: etiquetar una métrica con el ID de usuario o el ID de pedido. Cada valor distinto de la etiqueta crea una serie temporal nueva, y una métrica con tres etiquetas de alta cardinalidad puede generar millones de series y tumbar el sistema de almacenamiento. Las etiquetas deben tener valores acotados: endpoint, método, código de estado, entorno, versión.
2.2 Logs: el detalle del evento
Un log es el registro discreto de algo que ha ocurrido, con todo el contexto que hayas querido adjuntar. Es la señal más rica y la más cara: el volumen crece linealmente con el tráfico y el almacenamiento indexado no es barato.
La transformación que más rendimiento da aquí es pasar de logs de texto a logs estructurados. En vez de escribir una frase que luego habrá que parsear con expresiones regulares, se emite un objeto JSON con campos: nivel, mensaje, identificador de traza, usuario, endpoint, duración, versión de despliegue. Un log estructurado se puede filtrar y agregar como si fuese una base de datos; un log de texto plano solo se puede leer.
Tres reglas más que evitan problemas serios: nunca registres datos personales, tarjetas, tokens ni contraseñas —lo que entra en el log sale del perímetro de control y acaba siendo un problema de cumplimiento, como se explica al detalle en los controles técnicos de ISO 27001—; usa niveles con criterio, porque un sistema que escribe todo en INFO es un sistema sin niveles; e incluye siempre el identificador de correlación, que es lo que permite unir el log con su traza.
2.3 Trazas: dónde se ha ido el tiempo
Una traza distribuida sigue una petición concreta a lo largo de todo su recorrido: entra por el balanceador, pasa por la aplicación, consulta la base de datos, llama a la pasarela de pago, escribe en la cola. Cada uno de esos tramos es un span con su duración, y el conjunto forma un gráfico en cascada donde el cuello de botella se ve de un vistazo.
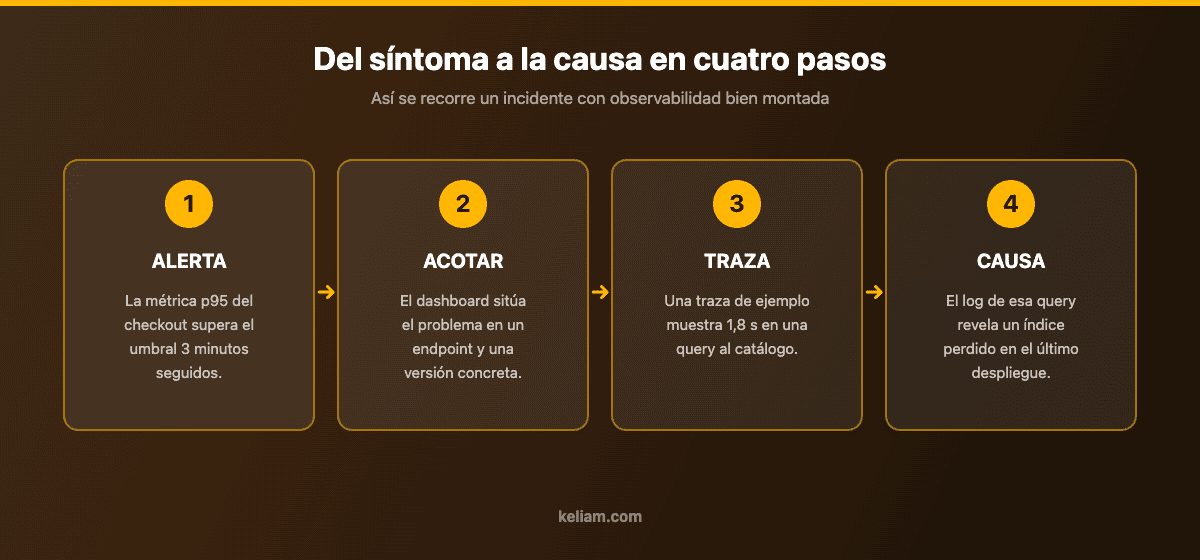
Es la señal que menos equipos tienen implantada y la que más tiempo de diagnóstico ahorra. Cuando una traza te dice que de los 2,3 segundos de una petición, 1,8 se han ido en una sola consulta al catálogo, se acabó la discusión sobre si el problema es del frontend, del servidor o del proveedor. Y si el tiempo se va en una llamada a una API externa, tienes la prueba objetiva para hablar con ese proveedor —algo especialmente relevante cuando esa API es además una superficie de ataque, como tratamos en el artículo sobre seguridad de APIs empresariales.
El muestreo es la clave para que las trazas sean asequibles: no hace falta guardar el 100% de las peticiones. Con un 1-5% de muestreo aleatorio más una regla que conserve siempre las peticiones con error o por encima de cierta latencia, tienes cobertura real con una fracción del coste.
3. Qué medir en una web de negocio
El instinto al montar observabilidad es medirlo todo. Es un error caro: genera ruido, dispara el coste y termina en paneles que nadie mira. Conviene empezar por un conjunto pequeño y defendible.
3.1 Las cuatro señales de oro
Para cada servicio con el que trabajes, cuatro números resumen su salud:
- Latencia: cuánto tarda en responder, separando peticiones correctas de erróneas (un error 500 instantáneo mejora artificialmente la media).
- Tráfico: cuántas peticiones recibe por unidad de tiempo. Sin esta cifra no se interpreta ninguna de las otras tres.
- Errores: porcentaje de peticiones fallidas, distinguiendo el 4xx del cliente del 5xx del servidor.
- Saturación: cuán lleno está el recurso más limitado: conexiones a base de datos, workers libres, cola pendiente, memoria.
Con estas cuatro señales por servicio y un panel que las muestre juntas se cubre el 80% de los incidentes reales.
3.2 Métricas de negocio: las que hacen que dirección escuche
Aquí está la diferencia entre un sistema de observabilidad que sobrevive al primer recorte y uno que no. Junto a la latencia y la CPU, instrumenta lo que le importa a la empresa: pedidos por hora, tasa de conversión del checkout paso a paso, altas de usuario, tickets creados, importe medio, formularios enviados.
Estas métricas tienen dos virtudes. La primera es que detectan incidentes que la infraestructura no ve: si los pedidos caen a cero pero todos los servidores responden con 200, hay un fallo funcional —un JavaScript roto, una pasarela rechazando, un stock mal sincronizado— que ninguna alerta técnica habría detectado. La segunda es política: cuando puedes enseñar que 300 milisegundos de latencia extra cuestan un porcentaje medible de conversión, la conversación sobre invertir en rendimiento deja de ser una petición del equipo técnico y pasa a ser un caso de negocio. Si ese dato quieres además explotarlo con más profundidad, tiene sentido conectarlo a la capa de BI, algo que comparamos en el artículo sobre dashboards a medida frente a Power BI o Metabase.
3.3 El frontend también cuenta
Toda la telemetría anterior vive en el servidor, y el servidor puede estar respondiendo en 80 milisegundos mientras el usuario mira una pantalla en blanco durante cuatro segundos. La monitorización de usuario real (RUM) recoge desde el navegador lo que de verdad experimenta la gente: tiempos de carga por dispositivo y país, errores de JavaScript, y las métricas de Core Web Vitals —especialmente INP, que sustituyó a FID y mide la capacidad de respuesta a las interacciones. Hemos tratado el detalle de estas métricas y sus umbrales en la guía sobre Core Web Vitals e INP, y la parte de diagnóstico en la de auditoría de rendimiento web.
¿Tu plataforma falla y nadie sabe explicar por qué?
En Keliam montamos observabilidad sobre plataformas que ya están en producción: instrumentación con OpenTelemetry, paneles con las métricas técnicas y de negocio que importan, alertas que no despiertan a nadie sin motivo y un plan de retención que no dispara la factura. Empezamos midiendo el estado real de tu sistema.
4. Qué stack elegir y cuánto cuesta
No hay una respuesta única, pero sí un criterio bastante fiable: el factor decisivo no es el precio de la licencia, es cuántas horas de tu equipo puedes dedicar a operar la propia plataforma de observabilidad.
4.1 Open source autohospedado
La combinación más extendida es Prometheus para métricas, Grafana para visualización, Loki para logs y Tempo o Jaeger para trazas. Es potente, no tiene coste de licencia y los datos se quedan en tu infraestructura, lo que simplifica cualquier discusión de cumplimiento normativo.
El coste está en otro sitio: hay que dimensionar el almacenamiento, gestionar la retención, actualizar componentes y responder cuando se cae el propio sistema de monitorización —que, por cierto, debe vivir fuera de la infraestructura que vigila; monitorizar un servidor desde ese mismo servidor es un chiste que solo tiene gracia hasta el primer corte real. Como referencia realista, una implantación completa para una plataforma mediana son entre tres y seis jornadas de trabajo inicial y unas horas al mes de mantenimiento.
4.2 SaaS gestionado
Datadog, New Relic, Grafana Cloud, Honeycomb o Better Stack eliminan el trabajo de operación y ofrecen correlación entre señales desde el primer día. El riesgo es económico y está bien documentado: el modelo de precios se basa en volumen de datos ingeridos, hosts y usuarios, y una aplicación que empieza a registrar más de la cuenta puede multiplicar la factura en un mes sin que nadie lo note hasta que llega.
Si vas por esta vía, tres precauciones: fija un presupuesto máximo y activa las alertas de gasto del propio proveedor; define la retención por tipo de dato desde el principio; y guarda una copia de las métricas críticas en un sistema propio para no quedar atado si un día decides cambiar.
4.3 OpenTelemetry, la decisión que más te va a durar
Al margen de dónde almacenes, instrumenta con OpenTelemetry. Es el estándar que ha ganado la partida: un único conjunto de librerías y un colector que recoge métricas, logs y trazas y los envía a donde tú decidas. La ventaja práctica es enorme: si dentro de dos años el SaaS sube precios o el open source deja de encajar, cambias la configuración del colector y no tocas ni una línea de código de aplicación. Instrumentar con el SDK propietario de un proveedor es hipotecar la decisión.
La instrumentación automática cubre además la mayor parte del trabajo sin escribir código: framework web, cliente HTTP, acceso a base de datos y colas quedan trazados con solo activar el agente. Lo que sí hay que añadir a mano son los spans y atributos de negocio, que es justo lo que después marca la diferencia.
5. Implantación realista en 90 días
La forma de fracasar es intentar instrumentarlo todo de golpe en un proyecto paralelo de tres meses que compite con la hoja de ruta de producto. La forma de conseguirlo es por capas, entregando valor en cada una.
5.1 Días 1 a 30: ver lo básico
Objetivo: dejar de estar ciego. Métricas de infraestructura de todos los servidores, comprobaciones de disponibilidad desde fuera (un servicio externo pidiendo la home y el checkout cada minuto), centralización de logs de aplicación y servidor web en un único sitio consultable, y un panel con las cuatro señales de oro del servicio principal. Además, dos o tres alertas, no más: caída total, tasa de error por encima del umbral y disco a punto de llenarse.
5.2 Días 31 a 60: entender
Objetivo: pasar del qué al por qué. Aquí entra OpenTelemetry con instrumentación automática en la aplicación principal, las primeras trazas distribuidas con muestreo, la conversión de los logs a formato estructurado con identificador de correlación, y el panel de métricas de negocio. Es también el momento de instalar RUM en el frontend.
5.3 Días 61 a 90: operar
Objetivo: convertirlo en proceso. Definir objetivos de nivel de servicio (SLO) para los recorridos críticos, revisar y podar las alertas que han demostrado ser ruido, escribir runbooks de dos páginas para los tres incidentes más frecuentes, y ajustar retención y muestreo con los datos de coste reales de los dos meses anteriores. Al final de esta fase deberías poder responder en menos de diez minutos a la pregunta de por qué algo va lento.
6. Alertas que no queman al equipo
El mayor enemigo de un sistema de observabilidad no es la falta de datos: es la fatiga de alertas. Un equipo que recibe cuarenta notificaciones al día deja de leerlas en dos semanas, y el día que llega la que importa se pierde entre el ruido.
La regla que mejor funciona es brutalmente simple: si una alerta no requiere que un humano haga algo ahora mismo, no es una alerta. Es una métrica en un panel o, como mucho, un aviso en un canal de chat sin notificación. Solo debe despertar a alguien lo que afecta a usuarios reales y no se arregla solo.
De ahí se derivan varias prácticas concretas. Alerta sobre síntomas visibles para el usuario —el checkout devuelve errores— y no sobre causas intermedias —la CPU está al 90%—, porque la CPU alta puede ser perfectamente normal y el usuario es el único juez. Exige persistencia antes de disparar: una condición que se cumple durante cinco minutos seguidos, no un pico de treinta segundos. Define umbrales a partir de los SLO acordados con negocio, no de números inventados. Y cada alerta debe llevar enlazado un runbook que explique qué mirar y qué hacer, porque la persona que la reciba a las tres de la mañana puede no ser quien la configuró.
Una revisión trimestral de alertas —cuáles dispararon, cuáles eran falsas, cuáles se ignoraron— suele permitir eliminar entre un tercio y la mitad de ellas sin perder cobertura real.
7. Controlar el coste antes de que te controle a ti
La telemetría genera datos a un ritmo sorprendente, y el coste no crece con el tráfico de negocio sino con el detalle que decidas guardar. Cuatro palancas lo mantienen bajo control.
Retención escalonada. No todos los datos merecen vivir lo mismo. Un esquema razonable: logs de depuración 3-7 días, logs de aplicación 30 días, métricas con resolución fina 15 días y agregadas a cinco minutos durante un año, trazas muestreadas 7-15 días. Las métricas agregadas ocupan una fracción y son las que necesitas para comparar con el mismo periodo del año pasado.
Muestreo inteligente en trazas. Guardar el 100% no aporta información adicional relevante. Un porcentaje bajo de muestreo aleatorio más retención garantizada de todo lo que tenga error o latencia alta da la misma capacidad de diagnóstico a una fracción del coste.
Disciplina en el nivel de log. Revisa periódicamente qué está generando volumen. Es habitual encontrar un bucle que escribe una línea por iteración o una librería con el modo verboso activado desde un despliegue de hace meses.
Control de cardinalidad. Ya mencionado, pero es la causa número uno de facturas inesperadas en plataformas de métricas. Antes de añadir una etiqueta nueva, pregúntate cuántos valores distintos puede llegar a tener.
8. Los errores que más se repiten
De todas las implantaciones que hemos visto de cerca, estos son los tropiezos habituales:
- Instrumentar sin preguntas. Se instala el agente, se llenan diez paneles y nadie sabe qué debería mirar. Empieza al revés: escribe las cinco preguntas que hoy no puedes responder y monta lo necesario para contestarlas.
- Señales desconectadas. Métricas en una herramienta, logs en otra, trazas en una tercera y ningún identificador común. El valor está justo en poder saltar de la métrica a la traza y de la traza al log de esa petición concreta.
- Olvidar el frontend. Medir solo el servidor deja fuera la mitad de la experiencia real.
- Monitorizar desde dentro. Si el sistema de observabilidad vive en la misma máquina o el mismo proveedor que vigila, se apagará justo cuando más lo necesites.
- No tener dueño. Sin una persona responsable de revisar paneles, podar alertas y ajustar retención, cualquier implantación se degrada en seis meses.
- Datos sensibles en la telemetría. Correos, DNI o tokens acabando en logs que se envían a un tercero es un problema de protección de datos, no un descuido menor.
- Dejarlo para la fase de escalado. Es uno de los errores técnicos que más frenan a las startups al pasar del MVP al producto: cuando por fin llega el tráfico, no hay forma de saber qué se está rompiendo.
Conclusión
La observabilidad no es un producto que se compra ni un panel que se instala: es una propiedad que se le da al sistema para poder hacerle preguntas nuevas sin tocar código. En una web de negocio se traduce en algo muy concreto: cuando el cliente llame diciendo que algo va lento, tener la respuesta en el panel antes de colgar el teléfono.
El camino sensato empieza pequeño. Elige el recorrido crítico de tu plataforma —normalmente el checkout, el login o el formulario que genera oportunidades—, instrumenta ese flujo de punta a punta con las tres señales, añade dos métricas de negocio y tres alertas que de verdad exijan actuar. Con eso ya estás por delante de la mayoría. Después se amplía servicio a servicio, con los datos de coste reales en la mano y un responsable claro que mantenga el sistema vivo.
Lo que no funciona es la alternativa que muchas empresas siguen practicando: esperar a que el cliente avise, reproducir a ciegas y confiar en que la persona que conoce el sistema siga en la empresa el día del incidente grave.
Preguntas frecuentes
¿Cuál es la diferencia entre monitorización y observabilidad?
La monitorización comprueba condiciones que definiste de antemano y responde si el sistema está caído. La observabilidad emite suficiente telemetría como para poder investigar problemas que nadie había anticipado, cruzando datos sin necesidad de desplegar código nuevo.
¿Necesita observabilidad una empresa pequeña?
Sí, y probablemente más que una grande: con menos gente disponible, el tiempo de diagnóstico es el recurso más escaso. Una implantación básica con métricas, logs centralizados y tres alertas útiles se monta en pocos días y ya cambia por completo la forma de responder a incidentes.
¿Qué cuesta montar observabilidad en una plataforma mediana?
Depende del modelo. Con open source autohospedado el gasto es principalmente de horas de implantación y operación, más el almacenamiento. Con SaaS hay una cuota recurrente ligada al volumen de datos y al número de hosts, que conviene acotar con límites de gasto y políticas de retención desde el primer día.
¿Por dónde empiezo si no tengo nada?
Por tres cosas en este orden: comprobaciones de disponibilidad desde fuera de tu infraestructura, centralización de logs de aplicación en un único sitio consultable y un panel con latencia, tráfico, errores y saturación del servicio principal. Con eso cubierto, el siguiente paso es instrumentar con OpenTelemetry el recorrido crítico de negocio.