Hay un momento concreto en la vida de una instancia de n8n en el que deja de ser una herramienta y pasa a ser infraestructura. Normalmente llega sin avisar: un cliente nuevo multiplica los webhooks, un workflow con llamadas a modelos de IA empieza a tardar minutos en lugar de segundos, y de pronto las ejecuciones se acumulan en una instancia que hace de editor, de receptor de webhooks y de motor de ejecución al mismo tiempo.
La respuesta de n8n a ese problema es el modo queue, y la plataforma natural para explotarlo es Kubernetes. En esta guía repasamos la arquitectura completa (qué procesos hay y qué hace cada uno), la configuración exacta que hay que tocar, cómo se despliega con el Helm chart oficial, dónde están las trampas de persistencia que rompen un despliegue en producción, qué métricas vigilar y cuánto cuesta realmente la factura a fin de mes — incluida la partida que casi todos los cálculos se dejan fuera.
Cuándo necesitas escalar n8n
Una instancia básica de n8n con Docker maneja sin problemas decenas de workflows y cientos de ejecuciones diarias. Pero cuando gestionas automatizaciones para múltiples clientes, procesas miles de webhooks por hora, o ejecutas workflows pesados con llamadas a IA, necesitas una arquitectura que escale horizontalmente. Ahí es donde Kubernetes entra en juego.
Las señales de que te has quedado corto
Antes de montar nada, conviene confirmar que el problema es de arquitectura y no de un workflow mal escrito. Estas cinco señales apuntan a lo primero:
- El editor va lento mientras se ejecutan workflows. Es el síntoma más claro de que un solo proceso está haciendo demasiadas cosas: la interfaz compite por CPU con las ejecuciones.
- Webhooks que llegan y se pierden en picos. Si la instancia está ocupada ejecutando, puede tardar en aceptar la petición entrante y el emisor da por fallida la entrega.
- Un reinicio te cuesta ejecuciones. Sin cola, lo que estaba en vuelo cuando el pod se reinicia se pierde. Con Redis por medio, el trabajo vuelve a la cola y lo recoge otro worker.
- Picos muy marcados. Si la carga de la hora punta es diez veces la del valle, pagar todo el día por la capacidad del pico es tirar dinero. Es el caso de libro del autoescalado.
- Workflows pesados que bloquean a los ligeros. Una sincronización masiva no debería retrasar un webhook de alta de cliente. Con varios workers, deja de hacerlo.
Si ninguna de las cinco te suena y el problema es más bien que no sabes qué automatizar, el salto a Kubernetes es prematuro: empieza por el catálogo de automatizaciones con n8n que usamos en una agencia de desarrollo y vuelve aquí cuando el volumen lo pida.
Arquitectura n8n en modo Queue
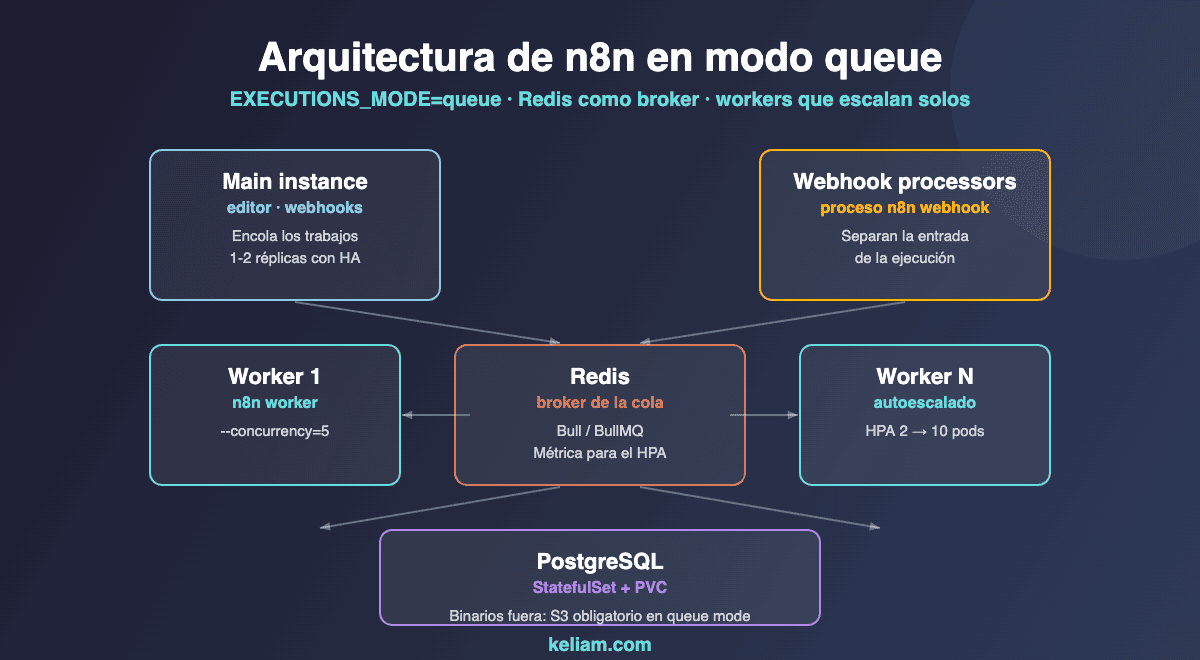
n8n soporta un modo de ejecución distribuido llamado Queue Mode. En lugar de que una sola instancia ejecute todos los workflows, la arquitectura se divide en: un Main instance (maneja el editor, webhooks y scheduling), múltiples Workers (ejecutan los workflows en paralelo), y Redis como broker de mensajes entre el main y los workers.
Esta arquitectura permite escalar workers independientemente según la carga. Si un lunes por la mañana se disparan 500 workflows simultáneamente, Kubernetes puede auto-escalar de 2 a 10 workers en segundos con un HPA (Horizontal Pod Autoscaler) basado en la profundidad de la cola de Redis.
La configuración mínima de queue mode
La documentación oficial reduce el arranque a un puñado de variables de entorno, que deben estar presentes en el main, en los workers y en los webhook processors:
EXECUTIONS_MODE=queue
N8N_ENCRYPTION_KEY=<la misma clave en todos los procesos>
QUEUE_BULL_REDIS_HOST=redis
QUEUE_BULL_REDIS_PORT=6379
QUEUE_BULL_REDIS_PASSWORD=<si Redis lo exige>
Dos detalles que causan la mayoría de los despliegues fallidos. El primero: N8N_ENCRYPTION_KEY tiene que ser idéntica en todos los procesos. Si cada pod genera la suya, los workers no pueden descifrar las credenciales y los workflows fallan con errores de autenticación que parecen de la API de destino y no lo son. El segundo: los procesos se arrancan con subcomandos distintos de la misma imagen — n8n worker para los workers y n8n webhook para los procesadores de webhooks.
Sobre la concurrencia, la recomendación de n8n es no bajar de 5 (n8n worker --concurrency=5). El motivo no es el rendimiento sino el pool de conexiones a base de datos: valores muy bajos combinados con muchos workers acaban agotándolo.
Task runners: el cambio que no puedes ignorar
Si tu referencia de n8n es de hace un par de versiones, este es el punto que más ha cambiado. Los task runners son el mecanismo que ejecuta el código de los nodos Code (JavaScript y Python) aislado del proceso principal. Sin ellos, cualquiera con permiso para editar un workflow puede alcanzar la base de datos, la clave de cifrado, las credenciales guardadas y las variables de entorno del propio n8n: es decir, el nodo Code se convierte en una ejecución de código arbitrario con los privilegios del servidor.
Lo relevante para un despliegue en Kubernetes:
- Desde n8n 2.0 vienen habilitados por defecto, y la documentación es explícita: hay que usarlos siempre en producción.
- El modo interno (el runner como proceso hijo del main) está deprecado desde la 3.0 y no se considera seguro para producción, porque el runner hereda los mismos permisos que n8n.
- El modo recomendado es el externo: un contenedor sidecar aparte que ejecuta los runners mediante un launcher. Se activa con
N8N_RUNNERS_MODE=external, unN8N_RUNNERS_AUTH_TOKENcompartido y, cuando hay varios contenedores,N8N_RUNNERS_BROKER_LISTEN_ADDRESS=0.0.0.0.
En un cluster esto encaja de forma natural: el runner va como contenedor adicional en el pod del worker, con sus propios límites de CPU y memoria y sin acceso a los secretos del main. Es, además, uno de los controles que un auditor espera encontrar — la lógica es la misma que describimos en desarrollo seguro según ISO 27001 y el ENS.
Despliegue con Helm Chart
n8n ofrece un Helm chart oficial que simplifica el despliegue en Kubernetes. El chart incluye: el deployment del main instance, el deployment de workers (con réplicas configurables), el StatefulSet de PostgreSQL (o puedes apuntar a un servicio managed como RDS/Cloud SQL), el deployment de Redis, Ingress con TLS, y ConfigMaps/Secrets para la configuración.
Para equipos DevOps que ya gestionan clusters de Kubernetes, integrar n8n es natural. Puedes incluirlo en tu pipeline de CI/CD con Jenkins y gestionarlo como cualquier otro servicio del cluster.
Los valores del chart que conviene tocar
El chart arranca con una configuración pensada para probar, no para producción. Estos son los puntos que casi siempre hay que ajustar antes de poner tráfico real:
- Réplicas de workers y HPA. Un mínimo de 2 para que un reinicio no deje la cola parada, y un máximo que tenga sentido con los nodos que hay. Escalar a 20 pods en un cluster de 3 nodos solo produce pods en Pending.
- Requests y limits. Los workers de n8n consumen memoria a ráfagas. Poner un limit ajustado garantiza reinicios por OOMKilled en el primer dataset grande; dejarlo sin límite garantiza que un workflow se lleve por delante al nodo entero. El punto medio razonable: request holgada y limit al doble.
- Base de datos externa. El PostgreSQL que despliega el chart vale para una demo. En producción se apunta a un servicio gestionado (RDS, Cloud SQL) y se olvida uno de los backups del StatefulSet.
- Secrets de verdad. La clave de cifrado y las credenciales de Redis y Postgres no van en
values.yaml: van en un Secret gestionado por el proveedor o por un operador de secretos. - Ingress con TLS y límite de tamaño. Los webhooks con payload grande chocan con el límite por defecto del Ingress Controller mucho antes que con el de n8n.
Tres errores de despliegue que se repiten
- Escalar el main a varias réplicas sin pensarlo. El main gestiona el scheduling: varias réplicas sin un mecanismo de elección de líder significan workflows programados que se disparan por duplicado.
- Dejar los webhooks en el main. Funciona, pero desaprovecha media arquitectura. Separar el proceso
webhookes lo que permite absorber picos de entrada sin tocar la capacidad de ejecución. - Actualizar la imagen sin leer las notas de versión. n8n publica versiones con frecuencia y los saltos de versión mayor han traído cambios de comportamiento relevantes, como el de los task runners. Fijar la etiqueta de la imagen y actualizar de forma deliberada evita sorpresas en producción.
Persistencia y alta disponibilidad
En Kubernetes, la persistencia de datos requiere atención especial. PostgreSQL debe usar PersistentVolumeClaims con una StorageClass adecuada (por ejemplo, gp3 en AWS, pd-ssd en GCP). Redis puede ser efímero (los mensajes en cola son transitorios), pero para mayor resiliencia, usa Redis Cluster o un servicio managed como ElastiCache.
Para alta disponibilidad del main instance, configura un deployment con al menos 2 réplicas y un leader election mechanism. Los workers son stateless por naturaleza, así que escalarlos es trivial. Monitoriza la salud de cada componente con probes de Kubernetes y métricas de Prometheus.
Los datos binarios: el detalle que rompe el modo queue
Este es el punto que más despliegues tumba y el que menos se anticipa. La documentación de n8n es tajante: el modo queue no soporta el almacenamiento de datos binarios en el sistema de ficheros. El motivo es evidente en cuanto se piensa en la arquitectura: si un worker escribe un adjunto en su disco local y otro worker (en otro nodo) tiene que continuar con ese dato, no lo encuentra.
La solución es almacenamiento de objetos externo compatible con S3, configurado antes de que el primer workflow mueva un PDF o una imagen. Si se descubre tarde, el síntoma es desconcertante: workflows que funcionan en el editor (donde se ejecutan en el main) y fallan de forma intermitente en producción, justo los que manejan ficheros, y solo cuando el trabajo cae en un worker distinto.
Backups: lo que hay que poder restaurar
Un cluster se puede reconstruir en una tarde; los datos, no. El inventario mínimo de lo que debe estar respaldado y, sobre todo, probado en una restauración real:
- La base de datos. Contiene los workflows, las credenciales cifradas y el histórico de ejecuciones. Con un servicio gestionado, basta con activar las copias automáticas y verificar la retención.
- La clave de cifrado. Sin ella, el backup de la base de datos es inútil: las credenciales no se pueden descifrar. Guardarla fuera del cluster, en un gestor de secretos.
- Los workflows como código. Exportarlos a un repositorio Git es la mejor red de seguridad y, de paso, da trazabilidad de los cambios. Encaja de forma natural en el mismo pipeline de CI/CD que ya usa el equipo.
- El bucket de binarios. Con versionado activado, que cubre tanto el borrado accidental como el workflow que sobrescribe lo que no debía.
Monitorización del cluster n8n
n8n expone métricas en formato Prometheus (/metrics) que incluyen: número de workflows activos, ejecuciones en cola, tiempo medio de ejecución, errores por tipo, y uso de memoria. Combina estas métricas con las de Kubernetes (CPU, memoria, network) en un dashboard de Grafana para tener visibilidad completa.
Configura alertas para: cola de workers creciendo (indica que necesitas más workers), errores de credenciales (puede indicar tokens expirados), y consumo de memoria alto (algunos nodos de n8n pueden consumir mucha RAM al procesar datasets grandes).
Las cuatro métricas que de verdad deciden
De todo lo que se puede graficar, estas cuatro son las que cambian una decisión:
- Profundidad de la cola. Es la métrica rectora. Una cola que crece de forma sostenida (no en picos) significa que la capacidad de ejecución está por debajo de la carga, y es la señal correcta para el autoescalado.
- Tiempo de espera en cola, separado del tiempo de ejecución. La suma de los dos es lo que percibe el usuario, pero cada uno se arregla de una manera distinta: la espera con más workers, la ejecución optimizando el workflow. Confundirlos lleva a escalar cuando el problema era una consulta mal hecha.
- Tasa de error por workflow, no agregada. Un 2 % de error global puede ser un workflow al 90 % y treinta y nueve perfectos. El agregado esconde exactamente lo que hay que arreglar.
- Memoria por worker en percentil 95. La media no sirve de nada aquí: el pico es el que provoca el OOMKilled, y el percentil alto es el que anticipa que hay que subir el límite antes de que ocurra.
Alertas que alguien va a atender
Una alerta que salta todas las noches deja de ser una alerta. Tres criterios para que el sistema siga siendo creíble: alertar sobre tendencias sostenidas y no sobre valores instantáneos (cola por encima del umbral durante diez minutos, no un pico de treinta segundos); separar lo que requiere acción inmediata de lo que se revisa el lunes; y acompañar cada alerta de qué mirar primero. Si quien recibe el aviso tiene que reconstruir el contexto desde cero a las tres de la mañana, la alerta ha hecho la mitad de su trabajo.
Costes y optimización
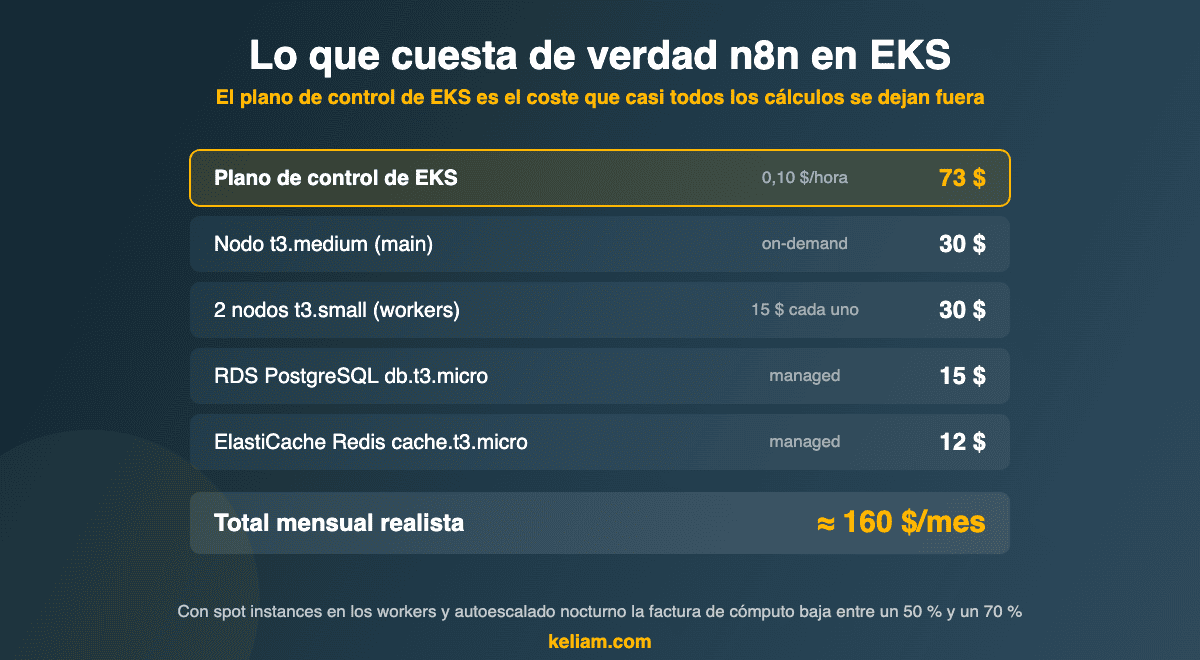
El coste de ejecutar n8n en Kubernetes depende del cluster. Un setup mínimo en AWS EKS: un nodo t3.medium para el main ($30/mes), dos nodos t3.small para workers ($15/mes cada uno), RDS PostgreSQL db.t3.micro ($15/mes), ElastiCache Redis cache.t3.micro ($12/mes). Total de cómputo y datos: ~$87/mes para una plataforma de automatización sin límites de workflows ni ejecuciones. Comparado con las alternativas SaaS el ahorro es significativo, y además es estable: Zapier facturó históricamente por tramos de tasks y en 2026 ha reordenado su catálogo en Free (100 tasks al mes), Professional desde 19,99 $/mes, Team desde 69 $/mes y Enterprise a medida, siempre con el precio ligado al volumen de tareas. Un despliegue propio no tiene ese techo: el coste lo marca la infraestructura, no el número de ejecuciones.
Para optimizar costes, usa Spot Instances para los workers (si un worker se interrumpe, el job vuelve a la cola y otro worker lo recoge), configura cluster autoscaler para reducir nodos en horarios de baja actividad, y programa los workflows pesados (reportes, backups, sincronizaciones masivas) en horarios valle.
La partida que casi nadie suma: el plano de control
El desglose anterior cubre el cómputo y los datos, pero deja fuera el coste del propio cluster. AWS cobra 0,10 $ por hora y cluster por el plano de control de EKS, lo que son unos 73 $/mes que hay que sumar antes de comparar con nada. El total realista del escenario mínimo no son 87 $ sino unos 160 $/mes.
Hay una segunda partida que sorprende aún más cuando llega: si el cluster se queda en una versión de Kubernetes que sale del soporte estándar (14 meses), pasa automáticamente a soporte extendido a 0,60 $/hora durante los doce meses siguientes. Son unos 438 $/mes por el mismo cluster, seis veces más, solo por no haber actualizado. Es el argumento económico más directo para mantener el calendario de actualizaciones al día.
Cuándo Kubernetes no compensa
Con esas cifras encima de la mesa, conviene decirlo claro: por debajo de cierto volumen, Kubernetes es la respuesta equivocada. Si una sola instancia con Docker aguanta tu carga, el coste de 160 $/mes es lo de menos — lo caro es el tiempo del equipo manteniendo un cluster. Las alternativas razonables antes de dar el salto son una instancia vertical más grande, o n8n en modo queue con Docker Compose en una sola máquina, que ya da la separación main/workers sin orquestador.
Kubernetes empieza a pagarse cuando se cumple alguna de estas tres: ya tienes un cluster para otras cargas y n8n solo es un namespace más; necesitas autoescalado real porque los picos son muy marcados; o hay requisitos de disponibilidad que una sola máquina no cubre. Si no se cumple ninguna, la decisión correcta es esperar. Es el tipo de disyuntiva que conviene razonar con alguien que haya pagado las dos facturas — y una auditoría técnica suele costar menos que un trimestre de infraestructura sobredimensionada.
¿Tu n8n se ha quedado pequeño?
En Keliam desplegamos y mantenemos plataformas de automatización en producción: migración a modo queue, despliegue en Kubernetes con autoescalado, monitorización con Prometheus y Grafana, y revisión de la factura cloud antes de que se dispare.
Seguridad del despliegue
Una plataforma de automatización concentra las credenciales de medio ecosistema: CRM, ERP, pasarelas de pago, correo, almacenamiento. En la práctica es uno de los sistemas más sensibles de la empresa, y casi nunca se trata como tal. Lo mínimo exigible en un despliegue sobre Kubernetes:
- El editor no se expone a internet. Webhooks sí, por fuerza; la interfaz de administración, detrás de VPN o con acceso restringido por IP. Son dos Ingress distintos, no uno.
- Task runners en modo externo. Como se explicaba más arriba, es lo que separa el código de usuario de las credenciales. En producción no es opcional.
- Autenticación en los webhooks. Una URL larga no es un secreto: si se filtra en un log o en un historial, cualquiera puede disparar el workflow. Firma de petición o cabecera compartida, siempre.
- NetworkPolicies. Que los workers solo puedan hablar con Redis, Postgres y lo que necesiten de salida. Es barato de configurar y limita mucho el alcance de una credencial comprometida.
- Rotación de la clave de cifrado y de los secretos. Con un procedimiento escrito y probado, no improvisado el día que haga falta.
- Registro de quién cambia qué. Un workflow modificado es un cambio en producción como cualquier otro y debería dejar rastro.
Si este inventario te parece lejano, el orden de prioridades para empezar está en nuestra guía de ciberseguridad para empresas, y si ya te han pedido certificarte, la guía de certificación ISO 27001 explica dónde encajan estos controles dentro del sistema de gestión.
Preguntas frecuentes
¿Cuántos workers necesito?
No hay número mágico: depende de la concurrencia de cada worker y de la duración media de tus ejecuciones. El método que funciona es empezar con dos y una concurrencia de 5, medir la profundidad de la cola durante una semana real y dejar que el HPA ajuste el resto. Lo que sí conviene fijar desde el principio es el máximo, para que un workflow en bucle no escale el cluster hasta la factura del mes siguiente.
¿Puedo usar Redis gestionado en lugar de desplegarlo en el cluster?
Sí, y es lo recomendable en producción. ElastiCache, Memorystore o equivalente te quitan el mantenimiento y la alta disponibilidad de encima. El coste es pequeño comparado con el de depurar una pérdida de mensajes en un Redis autogestionado.
¿Qué pasa si se cae Redis?
Los trabajos encolados que no se hayan persistido se pierden y los workers dejan de recibir trabajo nuevo. El main sigue aceptando webhooks pero no puede encolar. Por eso Redis, aunque los mensajes sean transitorios, merece el mismo trato de disponibilidad que la base de datos.
¿Funciona esto también en GKE, AKS u OpenShift?
Sí: el chart es estándar de Kubernetes. Lo que cambia entre proveedores son las clases de almacenamiento, el Ingress Controller y el precio del plano de control (GKE y AKS tienen esquemas distintos al de EKS, y conviene comprobarlo antes de dar por buena una comparativa).
¿Cómo migro desde una instancia con Docker sin perder nada?
El camino con menos riesgo: levantar el cluster en paralelo, restaurar una copia de la base de datos y la misma clave de cifrado, verificar que las credenciales descifran correctamente, mover los webhooks apuntando el DNS y mantener la instancia antigua apagada pero intacta unos días. La parte que más falla es la clave de cifrado; el resto es rutina.
¿Y si mis workflows usan mucha IA?
Es justo el caso que más se beneficia del modo queue, porque las llamadas a modelos son lentas y bloquean un worker durante segundos o minutos. Dos ajustes concretos: subir la concurrencia por worker (gran parte del tiempo es espera de red, no CPU) y poner timeouts explícitos, porque una llamada colgada retiene el slot indefinidamente. Lo desarrollamos en el artículo sobre workflows inteligentes con n8n, ChatGPT y Claude.
Conclusión
Pasar n8n a modo queue sobre Kubernetes resuelve un problema concreto y bien delimitado: separar quién recibe el trabajo de quién lo ejecuta, para poder escalar lo segundo sin tocar lo primero. La arquitectura no es complicada — main, webhook processors, workers, Redis y Postgres — y el Helm chart oficial se encarga de la mayor parte del trabajo mecánico.
Lo que marca la diferencia entre un despliegue que aguanta y uno que da sustos está en cuatro detalles que no aparecen en el primer tutorial que encuentras: la misma N8N_ENCRYPTION_KEY en todos los procesos, los datos binarios en S3 desde el día uno, los task runners en modo externo, y el plano de control sumado a la hoja de costes antes de comparar con cualquier alternativa SaaS. Con esos cuatro resueltos, lo demás es operación normal de Kubernetes.