Casi todos los equipos de desarrollo con los que trabajamos han pasado por la misma escena: llega el correo de asesoría legal con un PDF sobre protección de datos, alguien lo reenvía al canal de ingeniería y ahí se queda. El documento habla de bases de licitud, de principios y de derechos, y el equipo no sabe qué commit tiene que hacer mañana. Mientras tanto la aplicación sigue guardando el DNI en un campo de texto libre, los logs siguen escribiendo el email completo en cada petición y el dump de producción que se usa para depurar sigue dando vueltas por tres portátiles.
El RGPD no es un problema de abogados que luego se traduce a software: es un conjunto de requisitos técnicos verificables sobre cómo tu sistema recoge, guarda, mueve, enseña y borra datos de personas. El artículo 25 lo dice sin rodeos: la protección de datos tiene que estar en el diseño y por defecto. Eso es una decisión de arquitectura, no una cláusula del aviso legal.
Esta guía está escrita para quien toca el código y para quien decide la arquitectura. No repasa la norma artículo por artículo: traduce las obligaciones que de verdad afectan a un proyecto de software a decisiones concretas de modelo de datos, de control de acceso, de cifrado, de retención, de logs, de entornos y de respuesta a incidentes. Al final hay una hoja de ruta de 90 días para un equipo que empieza desde cero, y la lista de errores que nos encontramos prácticamente en cada auditoría técnica que hacemos. Si tu punto de partida es más normativo que técnico, nuestro repaso de cumplimiento de NIS2 y RGPD en el desarrollo web sirve como contexto previo.
1. Lo que el RGPD te pide realmente cuando escribes código
El reglamento se apoya en un puñado de principios del artículo 5 que, leídos con mentalidad de ingeniería, se convierten en restricciones de diseño muy concretas: licitud y transparencia, limitación de la finalidad, minimización, exactitud, limitación del plazo de conservación, integridad y confidencialidad, y responsabilidad proactiva. Todos ellos se pueden comprobar mirando un esquema de base de datos y un pipeline de datos.
1.1 De «cumplir el RGPD» a requisitos verificables
Un requisito es verificable cuando alguien externo puede comprobar si se cumple sin preguntarte. «Cumplimos el RGPD» no lo es. «Ningún campo de la tabla de usuarios se guarda sin una finalidad declarada en el registro de tratamientos» sí lo es. «Los logs de aplicación no contienen direcciones de correo, y hay un test que falla si aparecen» también.
La traducción práctica es esta: cada principio se convierte en un control, cada control en una comprobación automatizable y cada comprobación en algo que se ejecuta en CI o en una revisión periódica. Ese es el mismo salto conceptual que se hace al implantar los controles técnicos de ISO 27001, y por eso los equipos que ya han pasado por ahí llegan al RGPD con la mitad del trabajo hecho.
1.2 Responsable y encargado: quién decide y quién ejecuta
La distinción importa porque cambia quién responde. El responsable del tratamiento decide para qué se usan los datos: normalmente tu cliente, o tu propia empresa si el producto es vuestro. El encargado trata los datos por cuenta del responsable siguiendo sus instrucciones: ahí entra la agencia de desarrollo, el proveedor de hosting, el servicio de envío de correos transaccionales, la herramienta de analítica, el CRM.
Si desarrollas o mantienes la plataforma de un cliente, lo habitual es que seas encargado. Eso implica tres cosas muy tangibles: necesitas un contrato de encargo de tratamiento firmado, no puedes usar los datos para fines propios (incluido entrenar modelos o alimentar demos) y no puedes subcontratar sin autorización. En la práctica, el punto que más se incumple es el tercero: se mete un servicio nuevo en el stack sin avisar a nadie y aparece un subencargado no declarado.
2. Base legal, finalidad y minimización: decisiones de modelo de datos
Aquí es donde el cumplimiento deja de ser abstracto. La minimización no se arregla con una política: se arregla borrando columnas.
2.1 Cada campo necesita una finalidad
El ejercicio más rentable que puede hacer un equipo técnico es sentarse con el esquema de la base de datos y escribir, al lado de cada campo que contenga datos personales, tres cosas: para qué se usa, en qué base legal se apoya y cuánto tiempo hace falta conservarlo. En cuanto se hace, aparecen los sospechosos habituales:
- Campos de fecha de nacimiento que solo se usaban para un cálculo de edad que ya no existe.
- Números de documento de identidad guardados «por si acaso» en formularios de contacto.
- Direcciones completas en una tabla de leads donde solo se necesita la provincia.
- Teléfonos duplicados en tres tablas porque nadie quiso tocar la integración antigua.
- Columnas de notas libres donde los agentes de soporte han escrito de todo durante cinco años.
Ese último caso es el peor y el más frecuente: los campos de texto libre son un sumidero de datos sensibles imposible de clasificar. La solución técnica no es revisar el histórico a mano, sino cerrar la puerta hacia delante (sustituir el textarea por campos estructurados) y aplicar una política de retención agresiva sobre el histórico.
2.2 Consentimiento, interés legítimo y contrato en la práctica
En producto, la base legal determina cómo se comporta la interfaz. Si el tratamiento se apoya en el consentimiento, necesitas poder demostrar que se dio: hay que guardar qué se consintió, cuándo, con qué texto a la vista y desde dónde. Eso es una tabla de eventos de consentimiento con versión del texto legal, no un booleano en la tabla de usuarios.
Si se apoya en la ejecución de un contrato (procesar un pedido, por ejemplo), no hace falta casilla, pero sí limitarse a lo necesario para ese contrato. Y si se apoya en el interés legítimo, necesitas poder justificar el balance y ofrecer oposición sencilla, lo que de nuevo es un flag en el modelo que todos los procesos por lotes tienen que respetar.
El error clásico en ecommerce es mezclar: se da de alta al cliente para procesar el pedido y se le mete en la lista de marketing con la misma casilla. Técnicamente eso significa que un solo booleano está haciendo el trabajo de dos consentimientos distintos, y cuando llega una reclamación no hay forma de demostrar nada.
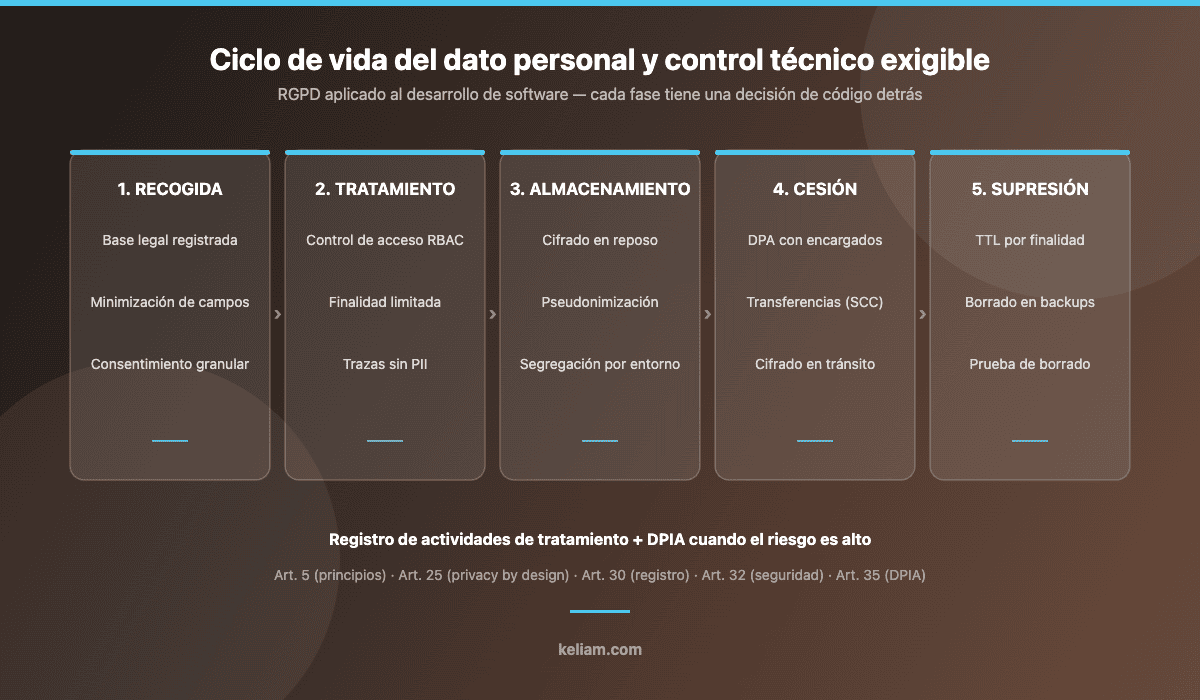
3. Privacy by design: el artículo 25 traducido a arquitectura
El artículo 25 obliga a aplicar medidas técnicas y organizativas apropiadas «tanto en el momento de determinar los medios de tratamiento como en el momento del propio tratamiento». En lenguaje de equipo: las decisiones de privacidad se toman en el diseño, no en el sprint de corrección anterior a la auditoría.
3.1 Privacy by default: lo que viene desactivado por defecto
La parte «by default» es la que más se incumple y la más fácil de arreglar. Significa que la configuración inicial de cualquier funcionalidad debe ser la más protectora posible, y que es el usuario quien decide ampliar. Traducido a decisiones concretas:
- El perfil de un usuario nuevo nace privado, no público.
- Las casillas de marketing nacen desmarcadas, y el botón de aceptar todo no es más grande ni más llamativo que el de rechazar.
- La geolocalización, las notificaciones y el acceso a contactos se piden cuando se necesitan, no en el onboarding.
- Las integraciones de analítica y mapas de calor no cargan hasta que hay consentimiento. Si usas herramientas de grabación de sesión, el bloqueo de campos sensibles se configura antes de la primera grabación, no después.
- Los identificadores en URLs no son secuenciales ni adivinables, para evitar enumeración de perfiles.
3.2 Dónde encaja en el ciclo de desarrollo
Nuestra recomendación práctica es meter la privacidad en tres puntos del flujo que ya existen, para no crear un proceso paralelo que nadie usará:
- Plantilla de historia de usuario: dos campos obligatorios, «datos personales que toca» y «finalidad». Si la respuesta es «ninguno», se cierra en diez segundos.
- Checklist de pull request: ¿se añaden campos nuevos con datos personales? ¿se escribe algo nuevo en logs? ¿se envía algo a un tercero? ¿hay un test de retención?
- Definition of done: el registro de tratamientos se actualiza en el mismo PR que introduce el campo, igual que la documentación de la API.
Esta integración ligera es la diferencia entre un cumplimiento vivo y un PDF de hace dos años. Es el mismo enfoque que seguimos cuando implantamos desarrollo seguro según ISO 27001 y el ENS: controles pequeños en los puntos de paso que el equipo ya atraviesa.
4. Pseudonimización, cifrado y tokenización: qué resuelve cada uno
El artículo 32 pide medidas apropiadas al riesgo y menciona expresamente la pseudonimización y el cifrado. En las conversaciones técnicas los tres términos se usan como sinónimos, y no lo son: resuelven problemas distintos y se combinan.
4.1 Cifrado en reposo y en tránsito
El cifrado en tránsito es, hoy, un requisito de base: TLS en todo, incluidas las llamadas internas entre servicios y las conexiones a la base de datos si salen de la máquina. El punto que suele fallar no es el certificado del sitio público, sino los caminos secundarios: el cron que descarga un CSV por FTP, el webhook de un proveedor que llega por HTTP, la réplica de base de datos que viaja sin cifrar entre dos centros de datos.
El cifrado en reposo tiene una trampa conceptual importante. Cifrar el disco completo protege frente al robo físico del servidor y frente a que un disco retirado acabe en manos ajenas, pero no protege frente a una inyección SQL: la aplicación tiene las claves montadas y la consulta devuelve texto plano. Para los campos de riesgo alto (documentos de identidad, datos de salud, datos financieros) hace falta cifrado a nivel de columna o de aplicación, con claves gestionadas fuera de la base de datos. Eso implica aceptar la contrapartida: un campo cifrado a nivel de aplicación no se puede indexar ni buscar de forma eficiente, y eso hay que diseñarlo antes, no descubrirlo en producción.
4.2 Pseudonimización frente a anonimización
La pseudonimización sustituye los identificadores directos por un alias, pero conserva la posibilidad de reidentificar con información adicional guardada aparte. Sigue siendo dato personal y sigue bajo el RGPD; lo que consigue es reducir el riesgo y abrir la puerta a tratamientos que de otro modo serían difíciles de justificar.
La anonimización, en cambio, es irreversible: si de verdad lo es, el dato sale del ámbito del reglamento. El problema es que la anonimización real es más difícil de lo que parece. Quitar el nombre y el email de un conjunto de datos que incluye código postal, fecha de nacimiento y sexo no anonimiza nada: esa combinación identifica a una persona en la mayoría de los municipios españoles. Si el objetivo es analítica, lo honesto es agregar (contar por tramos) en lugar de pretender que un registro individual sin nombre es anónimo.
4.3 Hashing y tokenización
El hashing con sal es obligatorio para contraseñas y nada más que para contraseñas: hashear un email con un algoritmo rápido no lo protege, porque el espacio de posibles emails es pequeño y se puede recorrer. La tokenización (sustituir el valor por un token sin significado, con la correspondencia guardada en un servicio aparte muy restringido) es la respuesta razonable para datos de pago y documentos de identidad, y es el patrón que exige el estándar de la industria de tarjetas. Si manejas pagos, nuestra guía sobre auditar una tienda online heredada recoge los puntos donde suelen aparecer estos datos guardados donde no deberían.
5. Los derechos del interesado son endpoints, no un email
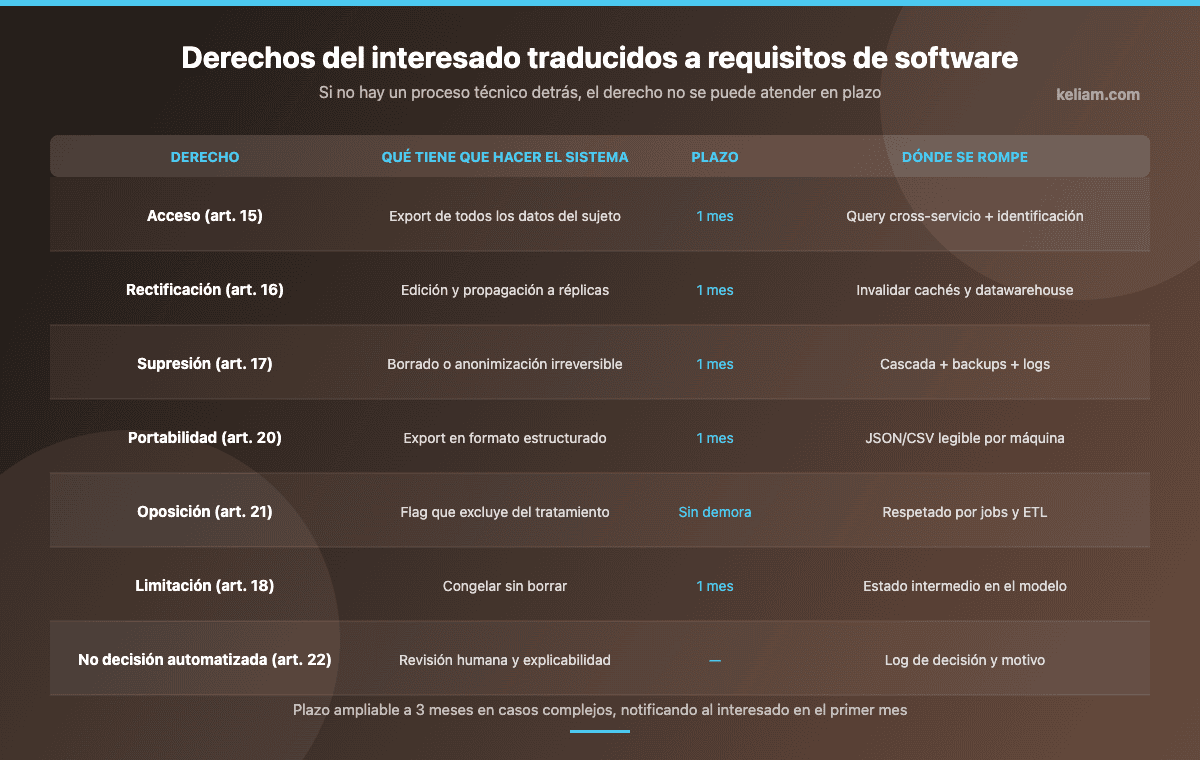
La mayoría de las organizaciones atiende los derechos de acceso o supresión a mano: llega un correo, alguien del equipo entra en el panel de administración, busca al usuario y hace lo que puede. Funciona mientras haya tres peticiones al año. En cuanto hay volumen, o en cuanto los datos de una persona están repartidos entre la base de datos principal, el CRM, la herramienta de email, el almacén analítico y los logs, el proceso manual falla y se incumple el plazo.
5.1 Acceso y portabilidad
El derecho de acceso exige entregar todos los datos que tienes de una persona; el de portabilidad, hacerlo en un formato estructurado y legible por máquina cuando el tratamiento se basa en consentimiento o contrato. La implementación sensata es un único job que, dado un identificador de sujeto, recorre un inventario declarado de orígenes y produce un paquete.
La clave está en ese inventario: un archivo de configuración que lista, por cada sistema, cómo se localizan los datos de un sujeto. Mantenerlo es trabajo, pero es el mismo trabajo que exige el registro de tratamientos, así que se hace una vez. Y hay un detalle que se olvida: antes de entregar nada hay que verificar la identidad del solicitante, porque un endpoint de acceso mal protegido es un canal de exfiltración perfecto.
5.2 Supresión: el borrado en cascada que nadie prueba
El derecho de supresión es el que rompe más arquitecturas, por cuatro motivos: las claves ajenas sin regla de borrado dejan filas huérfanas; hay obligaciones legales que impiden borrar (una factura hay que conservarla), de modo que el borrado real es casi siempre una anonimización parcial del registro conservando lo que la ley exige; los datos replicados en el almacén analítico y en las herramientas de terceros no se enteran; y los backups contienen al sujeto durante todo el periodo de retención.
La recomendación es implementar el borrado como un proceso con estados y trazas: se registra la petición, se ejecutan los borradores de cada sistema, se guarda el resultado por sistema y se conserva una prueba del borrado (fecha, sistemas afectados, identificador de la petición) sin conservar el dato borrado. Esa prueba es lo que te salva en una inspección.
6. Retención y borrado: TTL por finalidad y el problema de los backups
La limitación del plazo de conservación es el principio que casi nadie implementa, porque borrar da miedo y almacenar es barato. Pero conservar datos personales sin plazo es una infracción por sí misma, y además amplía la superficie de cualquier brecha futura.
El patrón que funciona es asignar un plazo a cada finalidad, no a cada tabla: los datos de un carrito abandonado no necesitan el mismo plazo que una factura. Después, un job periódico aplica esos plazos y deja un informe de lo que ha borrado. Algunos plazos razonables que usamos como punto de partida y se ajustan con asesoría legal: candidaturas de empleo, uno o dos años con consentimiento; carritos abandonados, semanas; logs de aplicación con IP, de treinta a noventa días; grabaciones de sesión, pocos meses; datos de facturación, el plazo fiscal y mercantil que corresponda.
Los backups son el punto incómodo. Nadie espera que abras una copia de seguridad de hace ocho meses para borrar a una persona, y el criterio aceptado es que la retención de backups sea finita, documentada y razonablemente corta, y que si se restaura una copia antigua se reapliquen las supresiones pendientes. Eso significa que el registro de peticiones de borrado debe sobrevivir a la restauración, lo que en la práctica implica guardarlo fuera del mismo ciclo de backup o reconstruirlo tras cada restauración. Si tu política de copias todavía no está escrita, conviene cerrarla antes de prometer plazos de borrado.
¿Sabes qué datos personales guarda de verdad tu aplicación?
En Keliam revisamos el esquema, los logs, las integraciones y los entornos de desarrollo de tu plataforma, y te entregamos el inventario de datos personales con los puntos donde el RGPD se incumple y el esfuerzo real de arreglarlos. Sin plantillas genéricas: código, consultas y configuración.
7. Logs, trazas y telemetría: la fuga silenciosa
Si tuviéramos que señalar un solo sitio donde los datos personales se escapan sin que nadie lo decida, serían los logs. Son el punto donde el equipo técnico tiene control total y donde casi nunca se aplica criterio de privacidad.
7.1 Qué no debe entrar en un log
La lista es corta y aburrida, y precisamente por eso se incumple: cuerpos completos de peticiones y respuestas, cabeceras de autorización, cookies de sesión, tokens, contraseñas (incluidas las que llegan en un intento fallido de login), direcciones de correo, teléfonos, documentos de identidad, datos de tarjeta y cualquier volcado de excepción que arrastre el objeto de usuario completo. Las trazas distribuidas y los sistemas de captura de errores merecen atención especial: por defecto suelen enviar variables locales y contexto de petición a un servicio de un tercero, posiblemente fuera de la Unión Europea.
7.2 Redacción automática y retención de logs
Lo que funciona es no confiar en la disciplina. Un formateador de logs con lista de claves sensibles que enmascara antes de escribir, una capa de depuración en el cliente de captura de errores, y un test de integración que recorre los logs generados por la batería de pruebas y falla si encuentra un patrón de email, de documento de identidad o de tarjeta. Es media jornada de trabajo y cierra el agujero de forma permanente.
La IP de los visitantes es dato personal y suele vivir eternamente en los logs del servidor web. O se anonimiza al escribir (truncando el último octeto o el grupo final en IPv6) o se le pone una retención corta y automática. Para el análisis forense posterior a un incidente conviene saber qué se puede reconstruir con lo que queda: nuestra guía de forense de red con TShark y tcpdump es útil justo para medir ese equilibrio entre privacidad y capacidad de investigación.
8. Entornos de desarrollo y datos de prueba
Pregunta incómoda pero necesaria: ¿cuántas copias de la base de datos de producción hay ahora mismo fuera de producción? En la mayoría de los proyectos que heredamos la respuesta es «no lo sabemos», y eso significa datos personales reales en portátiles sin cifrar, en entornos de preproducción accesibles desde internet y en adjuntos de tickets.
8.1 Anonimización de dumps
Usar producción en desarrollo no está prohibido como tal, pero es un tratamiento con una finalidad distinta y difícil de justificar, y multiplica el riesgo. La alternativa práctica no es prohibirlo por decreto, es hacer que lo correcto sea más fácil: un script de un comando que genera un dump y lo pasa por un anonimizador antes de que salga del servidor, sustituyendo nombres, correos, teléfonos y documentos por valores coherentes pero falsos. Si el dump anonimizado se genera en un minuto, nadie volverá a copiar el de producción.
Dos detalles que suelen romperlo: hay que mantener la integridad referencial y la forma de los datos (un email falso tiene que seguir siendo un email válido y único), y hay que anonimizar también los campos de texto libre, que es donde está lo peligroso. Para esos campos, lo razonable es truncar o sustituir por texto de relleno en lugar de intentar limpiarlos.
8.2 Datos sintéticos
Para proyectos nuevos, la opción limpia es no tener nunca datos reales fuera de producción: un generador de datos sintéticos con los volúmenes y la distribución suficientes para que las pruebas de rendimiento sean realistas. Cuesta más al principio y elimina la categoría entera de problema. Además permite compartir el entorno con terceros (una auditoría externa, un proveedor nuevo) sin ningún trámite de protección de datos.
9. Encargados del tratamiento, subprocesadores y transferencias
Un producto web moderno reparte datos personales entre una docena de terceros sin que nadie lo haya decidido conscientemente. Cada uno de ellos es un encargado o subencargado del tratamiento, y cada uno necesita contrato, justificación y control.
9.1 El inventario que nadie tiene
El ejercicio es sencillo y suele ser revelador: listar todos los servicios externos a los que la aplicación envía datos, incluyendo los que el equipo de marketing ha añadido por el gestor de etiquetas. Un inventario típico incluye hosting, CDN, proveedor de correo transaccional, plataforma de email marketing, analítica, mapas de calor y grabación de sesión, chat de soporte, pasarela de pago, CRM, herramienta de captura de errores, servicio de notificaciones push, proveedor de firma electrónica y, cada vez más, algún proveedor de modelos de lenguaje.
Ese último merece una pausa. Si tu aplicación envía texto escrito por usuarios (tickets de soporte, descripciones, comentarios) a un servicio de IA, estás cediendo datos personales a un tercero. Hace falta contrato de encargo, hay que comprobar si el proveedor usa esas entradas para entrenar y hay que decidir qué se filtra antes de enviar. Es el punto de cumplimiento que más deprisa se ha deteriorado en los últimos dos años, porque las integraciones se añaden en una tarde.
9.2 Transferencias internacionales
Si el proveedor trata datos fuera del Espacio Económico Europeo, hace falta un mecanismo válido de transferencia (decisión de adecuación o cláusulas contractuales tipo con un análisis de impacto de la transferencia) y, cuando corresponda, medidas suplementarias como el cifrado con claves gestionadas por ti. Desde el punto de vista técnico hay una decisión mucho más efectiva que cualquier cláusula: elegir la región europea del servicio cuando existe, y comprobar que la configuración lo refleja de verdad, porque muchas herramientas permiten elegir región de almacenamiento pero procesan en otra.
10. Brechas de seguridad: las 72 horas empiezan al detectarla
El RGPD obliga a notificar a la autoridad de control una violación de seguridad de datos personales en un máximo de 72 horas desde que se tiene conocimiento, salvo que sea improbable que suponga un riesgo. Ese plazo es lo que convierte la detección y la respuesta en requisitos técnicos y no en buenas intenciones.
10.1 Detección: si no te enteras, el plazo no corre pero el daño sí
El escenario real no es el de una alarma sonando: es que un cliente avisa de que su correo aparece en una filtración, o que alguien ve un pico de tráfico raro tres semanas después. Para que la detección exista hacen falta cosas modestas: monitorización de integridad de ficheros, alertas sobre exportaciones masivas desde el panel de administración, revisión de los accesos privilegiados, y logs de acceso a datos sensibles con retención suficiente para investigar. Nuestra guía de ciberseguridad en servidores con poco presupuesto cubre cómo montar ese mínimo sin una inversión grande.
10.2 El runbook que hay que tener escrito antes
El runbook de brecha no se improvisa a las dos de la madrugada. Debe estar escrito, probado una vez al año y contener: quién decide que esto es una brecha, cómo se contiene (rotación de credenciales, revocación de sesiones, aislamiento del sistema afectado), cómo se evalúa el alcance (qué categorías de datos, cuántos sujetos), quién redacta la notificación y con qué plantilla, cómo se comunica a los afectados si el riesgo es alto, y qué se registra. Importante: hay que llevar un registro interno de todas las violaciones, incluso de las que se decide no notificar, con el razonamiento de por qué no se notificó.
Si eres encargado del tratamiento, tu obligación es distinta y más estricta en tiempos: notificar al responsable sin dilación indebida, para que él pueda cumplir sus 72 horas. Conviene que esté en el contrato con un plazo concreto en horas.
11. DPIA y registro de actividades para equipos técnicos
La evaluación de impacto relativa a la protección de datos es obligatoria cuando el tratamiento entraña un riesgo alto: tratamiento a gran escala de categorías especiales de datos, observación sistemática de zonas accesibles al público, decisiones automatizadas con efectos significativos, cruces de fuentes, uso de tecnologías innovadoras. Para un equipo técnico es menos burocrático de lo que suena: lo valioso del ejercicio es el diagrama de flujo de datos y la lista de riesgos con su medida de mitigación, que es exactamente el documento que querrías tener al diseñar.
El registro de actividades de tratamiento del artículo 30 es el otro documento que conviene llevar como código y no como hoja de cálculo olvidada. Un fichero versionado en el repositorio, con una entrada por tratamiento (finalidad, categorías de datos, categorías de interesados, base legal, destinatarios, transferencias, plazo de conservación, medidas de seguridad) y una regla en la revisión de código que obliga a actualizarlo cuando se añade un campo o una integración. Así deja de ser un documento que se rehace cada año y pasa a ser el inventario que alimenta los procesos de acceso, supresión y retención descritos arriba.
12. Cómo encaja con ISO 27001, el ENS y NIS2
Las cuatro cosas se solapan bastante y conviene no implantarlas por separado. El RGPD protege a las personas y exige medidas apropiadas al riesgo sin decir cuáles. ISO 27001 aporta el sistema de gestión y un catálogo de controles concretos que sirve perfectamente como respuesta al artículo 32; si tu organización está en ese camino, nuestra guía completa de certificación ISO 27001 y el detalle de controles organizativos ahorran mucho trabajo de redacción. El ENS aplica si trabajas con el sector público y añade requisitos específicos de categorización y medidas. NIS2 añade obligaciones de ciberseguridad y de reporte para sectores concretos, con plazos de notificación propios que conviven con las 72 horas del RGPD.
La forma eficiente de abordarlo es un solo inventario de activos y datos, un solo análisis de riesgos, un solo conjunto de controles técnicos y varias trazabilidades hacia cada marco. Implantar los controles técnicos tres veces porque los pidió tres normas distintas es el desperdicio más común en empresas medianas.
13. Los diez errores que aparecen en casi toda auditoría
- Datos personales en logs sin enmascarar y con retención indefinida.
- Dump de producción en portátiles y entornos de preproducción sin anonimizar.
- Sin política de retención: nada se borra nunca, incluidas candidaturas de hace ocho años.
- Un booleano para dos consentimientos distintos, sin prueba de qué texto se aceptó.
- Scripts de terceros cargando antes del consentimiento, especialmente analítica y mapas de calor.
- Borrado que no cascada: se borra el usuario y quedan sus datos en cinco tablas y dos servicios externos.
- Campos de texto libre llenos de datos sensibles que nadie puede clasificar.
- Accesos de administración compartidos y sin traza de quién consultó qué.
- Proveedores sin contrato de encargo, descubiertos al revisar el gestor de etiquetas.
- Sin runbook de brecha: nadie sabe quién decide ni quién notifica.
Ninguno de los diez es un problema teórico y ninguno requiere un proyecto de seis meses. Casi todos se arreglan en una o dos iteraciones, y la mayoría se detecta en una auditoría de código bien planteada.
14. Hoja de ruta de 90 días
Para un equipo que parte de cero, este es el orden en el que recomendamos atacarlo. Está pensado para que cada bloque entregue algo verificable.
Días 1-30, saber qué tienes. Inventario de campos con datos personales en el esquema. Inventario de servicios externos que reciben datos. Revisión de qué se escribe en logs y qué se envía al capturador de errores. Resultado: dos listas y un diagrama de flujo de datos.
Días 31-60, cerrar las fugas evidentes. Enmascarado en logs con test automático. Anonimización de IP o retención corta. Retención automática en los dos o tres sitios más gruesos. Script de dump anonimizado. Revisión de qué carga antes del consentimiento. Resultado: menos datos almacenados y menos datos saliendo.
Días 61-90, construir los procesos. Endpoints o jobs de acceso, portabilidad y supresión con traza de ejecución. Registro de actividades de tratamiento versionado en el repositorio. Checklist de privacidad en la plantilla de pull request. Runbook de brecha escrito y una prueba de mesa. Resultado: un cumplimiento que se mantiene solo porque está dentro del flujo de trabajo.
Si en algún punto del camino quieres una mirada externa, es buen momento: revisar el inventario con alguien que no lo haya escrito es la forma más rápida de encontrar lo que falta. Y si todavía estás antes del paso uno, por dónde empezar con la ciberseguridad de la empresa es la lectura previa adecuada.
Conclusión
El RGPD aplicado al desarrollo de software no se resuelve con un aviso legal más largo ni con un banner de cookies mejor diseñado. Se resuelve en el modelo de datos, en el formateador de logs, en el job de retención, en el script que genera los entornos de prueba y en el runbook que alguien escribió antes de necesitarlo. Son cambios pequeños, aburridos y comprobables, y esa es exactamente la razón por la que funcionan: se pueden meter en un sprint y se pueden auditar después.
La buena noticia es que casi todo lo que exige el reglamento coincide con lo que querrías tener por razones puramente técnicas. Guardar menos datos reduce el coste de almacenamiento y la superficie de ataque. Tener un inventario de qué va a dónde acelera cualquier migración. Poder borrar a un sujeto de forma fiable implica que tu modelo de datos está bien entendido. Privacy by design, al final, es casi un sinónimo de arquitectura ordenada.
Si quieres saber en qué punto está tu plataforma de verdad, el camino más corto es mirarla: esquema, logs, integraciones y entornos. En Keliam lo hacemos como parte de nuestros servicios IT y de la auditoría técnica, y el entregable es una lista de acciones ordenada por riesgo y esfuerzo, no un informe de cien páginas.
Preguntas frecuentes
¿El RGPD obliga a cifrar todos los datos personales?
No de forma literal. El artículo 32 pide medidas apropiadas al riesgo y menciona el cifrado como ejemplo, no como obligación universal. En la práctica, el cifrado en tránsito es exigible siempre, el cifrado en reposo del almacenamiento es el estándar razonable, y el cifrado a nivel de campo se reserva para datos de riesgo alto como documentos de identidad, datos de salud o información financiera.
¿Puedo usar una copia de la base de datos de producción en desarrollo?
Es un tratamiento con una finalidad distinta de la original y difícil de justificar, además de multiplicar el riesgo. No está prohibido de forma absoluta, pero la opción defendible es trabajar con dumps anonimizados o con datos sintéticos. Si por algún motivo hay que usar datos reales, debe ser en un entorno con los mismos controles que producción, con acceso restringido, plazo corto y registro de quién lo usó.
¿Cuánto tiempo puedo guardar los logs con direcciones IP?
No hay una cifra fijada en el reglamento: depende de la finalidad. Para seguridad y detección de abusos, un plazo de treinta a noventa días es el rango que se acepta habitualmente como proporcionado, siempre que esté documentado en el registro de tratamientos. Si el objetivo es solo estadístico, lo correcto es anonimizar la IP en el momento de escribirla.
¿Tengo que borrar a una persona de los backups cuando ejerce el derecho de supresión?
No se espera que se abran y modifiquen las copias de seguridad. El criterio aceptado es tener una retención de backups finita, documentada y razonablemente corta, y garantizar que si se restaura una copia antigua se reaplican las supresiones pendientes. Para eso el registro de peticiones de borrado tiene que sobrevivir a la restauración.
Si mi agencia de desarrollo accede a datos de clientes, ¿qué necesito?
Un contrato de encargo de tratamiento que fije finalidad, instrucciones, confidencialidad, medidas de seguridad, régimen de subencargados, plazo de notificación de brechas y qué pasa con los datos al terminar. Además, accesos nominales y revocables (no credenciales compartidas) y traza de las operaciones realizadas sobre datos personales.
¿Puedo enviar texto escrito por usuarios a un servicio de IA?
Solo si ese proveedor es un encargado del tratamiento con contrato, el tratamiento tiene base legal y finalidad compatible, y has comprobado qué hace con las entradas (en particular si las usa para entrenar). Lo prudente es filtrar o pseudonimizar los identificadores antes de enviar, elegir región europea si el servicio la ofrece y reflejar el proveedor en el registro de tratamientos y en la información al usuario.