
El stack perfecto no existe, pero el stack equivocado sí
Elegir el stack tecnológico de una startup es una de las decisiones más importantes y menos reversibles. Un stack sobredimensionado consume recursos y ralentiza el desarrollo. Un stack infradimensionado limita el crecimiento. La clave es elegir tecnologías que se ajusten a tu fase actual pero que permitan escalar.
Escribimos esta guía en 2025 y el criterio de fondo no ha cambiado: elegir por la fase en la que estás, no por la que te gustaría estar. Lo que sí ha cambiado es parte del terreno —versiones, licencias y algunas modas que se han desinflado—, así que hemos ampliado el artículo con lo que hoy haríamos distinto y con el detalle que faltaba en cada apartado. Si estás en el punto de partida, nuestra guía sobre cómo llevar un MVP a producto escalable cubre la parte de proceso que acompaña a estas decisiones técnicas.
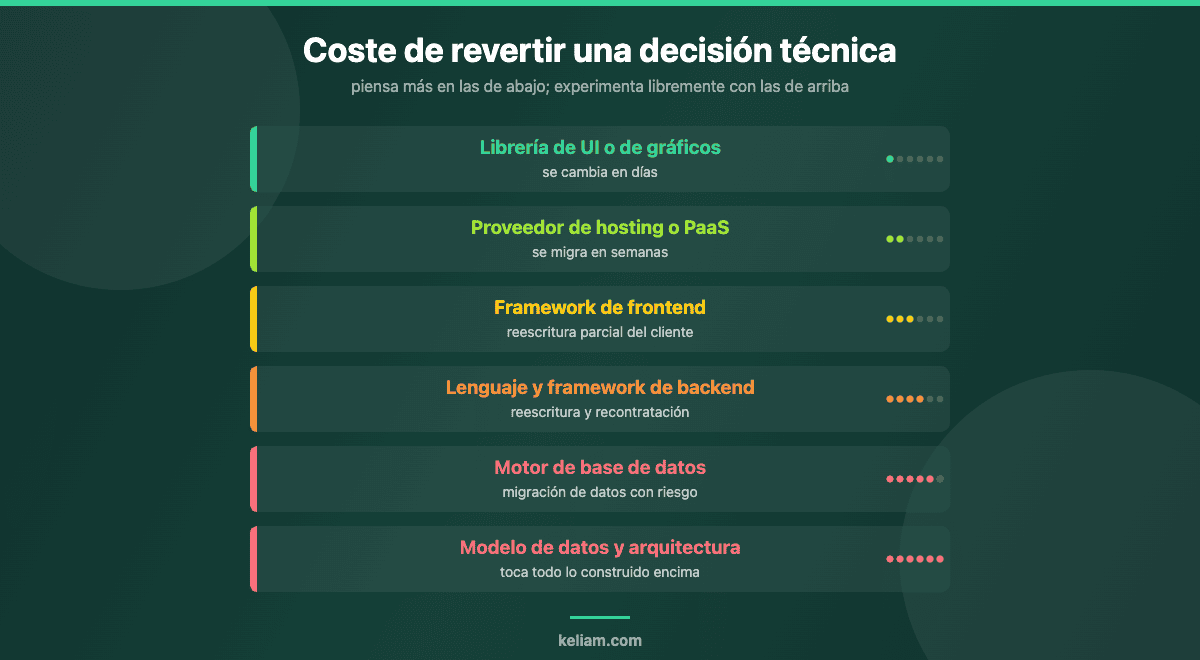
Cómo decidir: el coste de revertir, no la lista de features
Las comparativas de tecnologías suelen enfrentar funcionalidades, y esa es la conversación equivocada. En una startup casi cualquier herramienta moderna es capaz de hacer lo que necesitas los dos primeros años; lo que cambia radicalmente entre unas y otras es cuánto cuesta cambiar de opinión. Esa es la variable que conviene poner en el centro.
Cambiar una librería de gráficos cuesta una tarde. Cambiar de PaaS cuesta un par de semanas de fontanería. Cambiar el framework de frontend obliga a reescribir el cliente. Cambiar el lenguaje del backend obliga además a recontratar. Y cambiar el modelo de datos toca absolutamente todo lo que hayas construido encima. La regla práctica que aplicamos con nuestros clientes es simple: dedica el tiempo de deliberación en proporción inversa a la facilidad de revertir. Discutir tres días qué librería de componentes usar mientras se decide el esquema de la base de datos en una reunión de veinte minutos es exactamente al revés de como debería ser.
Frontend: React sigue dominando
React con Next.js es la combinación más segura para startups en 2025. Ecosistema enorme, facilidad para encontrar desarrolladores, rendimiento excelente con SSR/SSG, y compatibilidad con prácticamente cualquier backend. Alternativas válidas: Vue.js + Nuxt para equipos que prefieren una curva de aprendizaje más suave, o Svelte + SvelteKit para proyectos donde el rendimiento del bundle es crítico.
Backend: depende de tu equipo
El mejor lenguaje de backend es el que tu equipo domina. Node.js con Express o Fastify es la opción más popular por compartir lenguaje con el frontend. Python con Django o FastAPI es excelente para proyectos con componente de datos/ML. PHP con Laravel sigue siendo muy productivo y tiene un ecosistema maduro. Go y Rust son opciones para proyectos con requisitos de rendimiento extremos, pero la curva de aprendizaje es mayor.
Base de datos: PostgreSQL como default
PostgreSQL debería ser tu base de datos por defecto en 2025. Es robusta, escalable, soporta JSON nativo para datos semi-estructurados, tiene extensiones potentes (PostGIS para geodatos, pgvector para embeddings de IA), y es gratuita. Para caché y sesiones, Redis. MongoDB solo si tus datos son genuinamente no relacionales.
Infraestructura: empieza simple
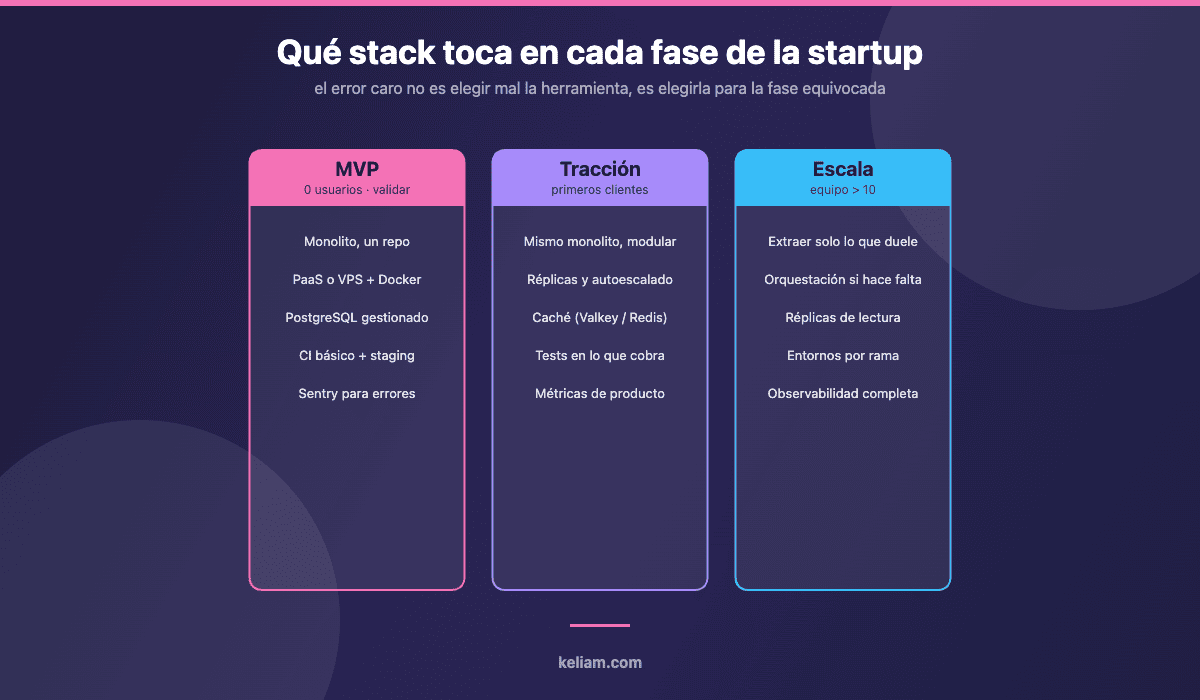
Para un MVP, no necesitas Kubernetes. Un PaaS como Railway, Render, Vercel (frontend) o incluso un VPS con Docker Compose es suficiente para empezar. AWS/GCP/Azure son potentes pero añaden complejidad operativa. Migra a infraestructura más compleja cuando tu tráfico o tu equipo lo justifiquen.
Lo que sí necesitas desde el día uno
Independientemente del stack, hay cosas que debes tener desde el principio: control de versiones (Git, por supuesto), CI/CD básico (GitHub Actions es gratuito), un entorno de staging, backups automáticos de la base de datos, monitoring básico (al menos Sentry para errores), y documentación mínima de la API.
Anti-patrones que vemos en startups
Errores frecuentes: adoptar microservicios antes de tener product-market fit, elegir tecnologías exóticas que dificultan la contratación, usar un framework frontend para una landing page que podría ser HTML estático, o gastar semanas en infraestructura DevOps cuando el producto aún no tiene usuarios. Optimiza para velocidad de iteración, no para escala que aún no necesitas.
Qué ha cambiado desde que escribimos esta guía
Tres movimientos del ecosistema afectan a las recomendaciones de arriba y conviene tenerlos presentes.
El frontend se ha estabilizado, pero los Server Components siguen siendo opcionales
React con Next.js sigue siendo la apuesta más segura, y el App Router —con React Server Components por defecto— ha pasado a ser la configuración más usada del ecosistema, superando por primera vez al Pages Router. Ahora bien, conviene leer la letra pequeña: alrededor del 45% de los desarrolladores dice haber usado Server Components, pero solo un tercio de ellos declara una experiencia positiva. Muchos equipos los activaron esperando una mejora automática de rendimiento y se encontraron con restricciones arquitectónicas y acoplamientos inesperados.
La conclusión para una startup no es evitarlos, sino no convertirlos en el eje de la arquitectura antes de tener producto. Si tu aplicación es un panel detrás de login, el renderizado en servidor te aporta poco y añade complejidad; si es un sitio público donde el SEO y el primer pintado deciden la conversión, ahí sí paga. Y las alternativas del artículo original siguen vigentes: si quieres comparar con calma, lo desarrollamos en la comparativa entre Next.js, Nuxt y Astro. Para una web de contenido o una landing, Astro es hoy la respuesta que damos con más frecuencia, y enlaza directamente con uno de los anti-patrones que ya señalaba este artículo.
PostgreSQL ha ganado por goleada, y con ventaja nueva
La recomendación de PostgreSQL por defecto no solo se mantiene: se ha reforzado. La versión 18 incorporó un subsistema de entrada/salida asíncrona que en algunas cargas de lectura llega a triplicar el rendimiento anterior, y pgvector se ha consolidado como el almacén vectorial de facto, con tipo vector, varios operadores de distancia e índices IVFFlat y HNSW. Esto tiene una consecuencia práctica muy concreta: si tu producto va a incorporar búsqueda semántica o funcionalidades de IA, probablemente no necesitas una base de datos vectorial aparte. Postgres con pgvector suele ganar a las alternativas especializadas por pura simplicidad operativa, y para una startup tener un sistema menos que administrar vale más que un punto de benchmark.
Su licencia, además, no tiene riesgo de cambio ni de dependencia de un propietario, algo que no puede decirse de todas las alternativas.
Redis dejó de ser software libre y apareció Valkey
Este es el cambio que más configuraciones ha afectado y el que menos gente tiene en el radar. Redis cambió en 2024 la licencia de su núcleo, abandonando BSD por un esquema dual con SSPL. La comunidad reaccionó con un fork, Valkey, respaldado por AWS, Google y Oracle, que hoy es la opción por defecto en los servicios gestionados de los grandes proveedores cloud. Redis 8 añadió después AGPLv3 como opción de licencia, pero el ecosistema de contribuidores ya se había desplazado.
Para una startup el impacto práctico es menor de lo que parece —Valkey es compatible a nivel de protocolo, y en la mayoría de casos basta con cambiar el destino de la conexión—, pero sí hay una decisión que tomar conscientemente: si usas un servicio gestionado, comprueba qué estás contratando exactamente, y si alguna vez piensas empaquetar y revender tu producto, revisa las implicaciones de la licencia SSPL antes de que sea un problema legal y no técnico.
El equipo decide más que la tecnología
El artículo ya lo apuntaba para el backend: el mejor lenguaje es el que tu equipo domina. Merece la pena desarrollarlo, porque es el factor que más veces hemos visto hundir un stack técnicamente impecable.
Contratar es la restricción real
Una tecnología minoritaria reduce tu mercado de candidatos y alarga cada contratación. En una empresa de doscientas personas eso es una molestia; en una de cinco, un mes extra buscando perfil es un trimestre de retraso en el producto. Antes de adoptar algo poco común, haz la comprobación más barata que existe: busca cuántos perfiles con esa tecnología hay en tu ciudad o en tu franja horaria. Si la respuesta son cuatro, ya tienes la decisión tomada.
El reverso también importa: una tecnología popular te da candidatos, pero te obliga a saber distinguirlos. Cómo estructurar esa evaluación lo tratamos en la guía sobre cómo evaluar desarrolladores para CTOs y responsables de contratación.
El factor autobús
Si solo una persona del equipo entiende una parte del sistema, esa parte es un riesgo con independencia de lo bien construida que esté. En equipos pequeños la solución no es documentarlo todo —no hay tiempo— sino elegir tecnologías legibles: un Django o un Laravel convencional lo entiende cualquier desarrollador senior en una tarde; una arquitectura propia con abstracciones inventadas, no. Para una startup, aburrido es una virtud.
La IA ha cambiado la ecuación, pero no como se dice
Los asistentes de código han reducido mucho el coste de escribir la primera versión de algo, y eso tienta a construir más de lo necesario. Nuestra experiencia es la contraria: lo que ahorran en escritura lo devuelven en revisión y mantenimiento si el equipo no controla el resultado. Donde sí son un multiplicador claro es en las tecnologías con ecosistema grande y bien documentado —otro argumento a favor de elegir lo mayoritario— y en tareas como las pruebas automatizadas y la detección de bugs, donde el coste de escribirlas a mano era justo lo que hacía que muchos equipos no las escribieran.
El mínimo técnico imprescindible, en concreto
La lista del apartado anterior es correcta pero merece concreción, porque «monitoring básico» significa cosas muy distintas para cada persona. Esto es lo que consideramos el mínimo defendible en un producto con usuarios reales:
- Control de versiones con ramas protegidas. Git no basta: el
maindebe estar protegido y requerir revisión, aunque seáis dos. Es la única barrera barata contra el despliegue accidental. - CI que ejecute algo. Un pipeline que solo instala dependencias da una falsa sensación de seguridad. Aunque sean cuatro pruebas, que cubran el flujo que genera ingresos: registro, pago, entrega.
- Staging que se parezca a producción. Mismo motor de base de datos y misma versión. Un entorno de pruebas con SQLite y una producción con PostgreSQL es una fuente inagotable de sorpresas.
- Backups probados. El backup que nunca has restaurado no es un backup, es una carpeta. Programa una restauración real cada trimestre y cronométrala: ese número es tu tiempo de recuperación ante un desastre.
- Gestión de secretos. Ni en el repositorio ni en un mensaje del chat del equipo. El gestor de secretos de tu proveedor es suficiente al principio, pero tiene que existir desde el primer día: retirar claves filtradas después es muchísimo más caro.
- Errores y trazas. Sentry para excepciones sigue siendo la recomendación. Añade registro estructurado con un identificador de petición desde el principio: reconstruir el rastro después, cuando ya tienes un incidente encima, es imposible.
- Un tablero con cuatro números. Peticiones por minuto, tasa de error, latencia del percentil 95 y uso de CPU o memoria. Si no puedes contestar en treinta segundos si la aplicación está bien, no tienes monitorización.
- Cumplimiento desde el diseño. Si manejas datos personales de usuarios europeos, el RGPD aplica desde el primer usuario, no desde la primera ronda de financiación. Lo que implica en la práctica lo detallamos en el artículo sobre cumplimiento de NIS2 y RGPD en el desarrollo web.
Nada de esto requiere un equipo de plataforma ni una herramienta de pago: son un par de días de trabajo bien invertidos que evitan semanas de incidentes más adelante.
Más anti-patrones (y por qué son tan tentadores)
A los que ya recogía el artículo añadimos estos, que vemos con la misma frecuencia y que comparten una raíz: todos parecen decisiones responsables en el momento de tomarlas.
- Construir una plataforma antes que un producto. Sistemas de plugins, capas de configuración, abstracciones «por si algún día». Se justifica como flexibilidad y acaba siendo el 60% del código manteniendo funcionalidad que nadie usa. Construye lo concreto; la abstracción correcta se descubre a la tercera vez que repites algo, no antes.
- Elegir el stack por la ronda que esperas levantar. «Kubernetes porque los inversores preguntarán por la escalabilidad». Ningún inversor serio ha invertido nunca por el orquestador de contenedores; sí han dejado de hacerlo por productos que no llegaron a salir.
- Multi-cloud desde el principio. La independencia de proveedor es real, pero su coste se paga por adelantado y su beneficio llega, como pronto, dentro de años. Empieza atado a un proveedor y mantén la puerta entreabierta: base de datos estándar, almacenamiento compatible con S3, sin funciones propietarias en el núcleo del producto.
- Cero pruebas o cobertura total. Los dos extremos hacen daño. Sin pruebas, cada despliegue es una apuesta; persiguiendo el 100% de cobertura se gastan semanas en validar getters. Cubre los caminos que generan ingresos y los que, si fallan, te obligan a escribir un correo de disculpa.
- Reescribirlo todo al primer dolor. La reescritura completa es casi siempre la peor opción disponible: paras la evolución del producto durante meses para acabar con los mismos problemas expresados de otra forma. Extrae la parte que duele, mídela, y decide después.
- No medir la deuda técnica ni mirarla. Deuda técnica no es «código feo»: es trabajo que has aplazado y que devengará intereses. Anotar en el backlog qué se aplazó y por qué convierte una queja difusa en una decisión revisable. Si el código ya viene de fuera o de otra etapa, una auditoría de código profesional pone números a lo que hay antes de decidir qué hacer con ello.
Hay un momento concreto en que estas decisiones dejan de ser internas y las mira alguien de fuera con lupa: cuando levantas una ronda o te compran. Qué se revisa exactamente en ese examen lo contamos en el artículo sobre due diligence técnica, y leerlo antes de necesitarlo es la mejor forma de no llevarse sustos.
Una forma práctica de decidir en una tarde
Si estás ahora mismo delante de esta decisión, este es el orden que seguimos cuando nos sentamos con un equipo fundador. Se responde en una sesión de trabajo.
- ¿Qué sabe hacer bien el equipo que tienes hoy? No el que te gustaría tener. Esta respuesta ya descarta la mitad de las opciones.
- ¿Qué tiene de peculiar el producto? Geolocalización, tiempo real, documentos, vídeo, IA. Si hay un requisito de verdad exigente, manda sobre lo demás; si no lo hay —y casi nunca lo hay—, elige lo aburrido.
- ¿Cuántos usuarios tendrás dentro de un año, siendo honesto? Multiplica tu mejor estimación por diez y comprueba que el stack aguanta. Si aguanta, deja de preocuparte por la escala.
- ¿Qué es lo caro de revertir aquí? Identifica esas dos o tres decisiones y dedícales el tiempo. Al resto, una hora como máximo.
- ¿Cuánto tarda alguien nuevo en desplegar un cambio? Si son más de dos días, tu problema no es el stack: es el entorno de desarrollo.
- Escríbelo. Una página con qué elegisteis y por qué. Dentro de un año, cuando alguien pregunte por qué usáis eso, la alternativa a ese documento es una discusión de dos horas basada en recuerdos.
Conclusión
El stack tecnológico de una startup no es una declaración de identidad ni una apuesta sobre el futuro: es una herramienta para llegar a la siguiente fase con el equipo y el dinero que tienes hoy. La recomendación central de este artículo sigue intacta —React con Next.js si necesitas frontend rico, el backend que domine tu equipo, PostgreSQL por defecto, infraestructura simple hasta que el tráfico diga lo contrario— y el tiempo le ha dado la razón sobre todo en la base de datos, donde Postgres ha absorbido incluso los casos de uso vectoriales que hace poco pedían un sistema aparte.
Lo que conviene incorporar es el criterio de decisión: gasta el debate en lo caro de revertir, elige lo mayoritario salvo que tengas una razón concreta para no hacerlo, y ten desde el primer día las cuatro cosas que te permiten dormir —copias probadas, secretos fuera del repositorio, errores visibles y un entorno de pruebas honesto—. Todo lo demás se puede cambiar después, que es exactamente de lo que se trata.
¿Estás decidiendo el stack de tu producto?
En Keliam acompañamos a startups desde el MVP hasta el producto escalable: elegimos contigo las tecnologías, montamos la base técnica y nos quedamos para mantenerla.
- Servicios IT — desarrollo e infraestructura para producto
- Auditoría Técnica — revisión del stack y de la deuda que arrastras
- Mantenimiento de software — que el producto siga en pie mientras creces