Un despliegue pasa los tests, el pipeline sale verde y dos horas después un comercial avisa de que el botón de «Finalizar pedido» ha desaparecido en móvil. No se ha roto ninguna función: el formulario envía, la API responde, el pedido se graba. Lo que se ha roto es el layout, y de eso ningún test unitario sabe nada. El cambio de una clase de utilidad, una actualización menor del framework de CSS o un overflow: hidden heredado han bastado para empujar el botón fuera de la pantalla.
El testing de regresión visual existe exactamente para eso: comparar cómo se ve la interfaz antes y después de un cambio, y avisar cuando la diferencia no estaba prevista. Es una red de seguridad que lleva más de una década dando vueltas, pero que en los últimos años se ha vuelto por fin razonable de mantener: Playwright trae comparación de capturas integrada, Vitest 4 la incorporó para componentes, y las herramientas de revisión en la nube han bajado lo suficiente de precio como para que no haga falta ser Netflix para usarlas.
Dicho esto, es también la categoría de test que más equipos abandonan a los tres meses. Siempre por el mismo motivo: no por falta de herramienta, sino por falsos positivos. Una suite visual que falla cada dos ejecuciones por un píxel de antialiasing acaba en el mismo sitio que las alertas de Nagios que nadie mira: el equipo aprende a actualizar las imágenes de referencia sin leer el diff, y a partir de ese momento la suite es decorativa.
En este artículo vamos al grano: cómo funciona por dentro una comparación de capturas, qué umbrales tienen sentido, qué herramientas usar según el tamaño del equipo, y —sobre todo— cómo construir un entorno determinista para que el verde signifique algo. Lo escribimos desde el lado de quien mantiene proyectos de clientes en producción, no desde la documentación de un vendor.
1. Qué es el testing de regresión visual (y qué no es)
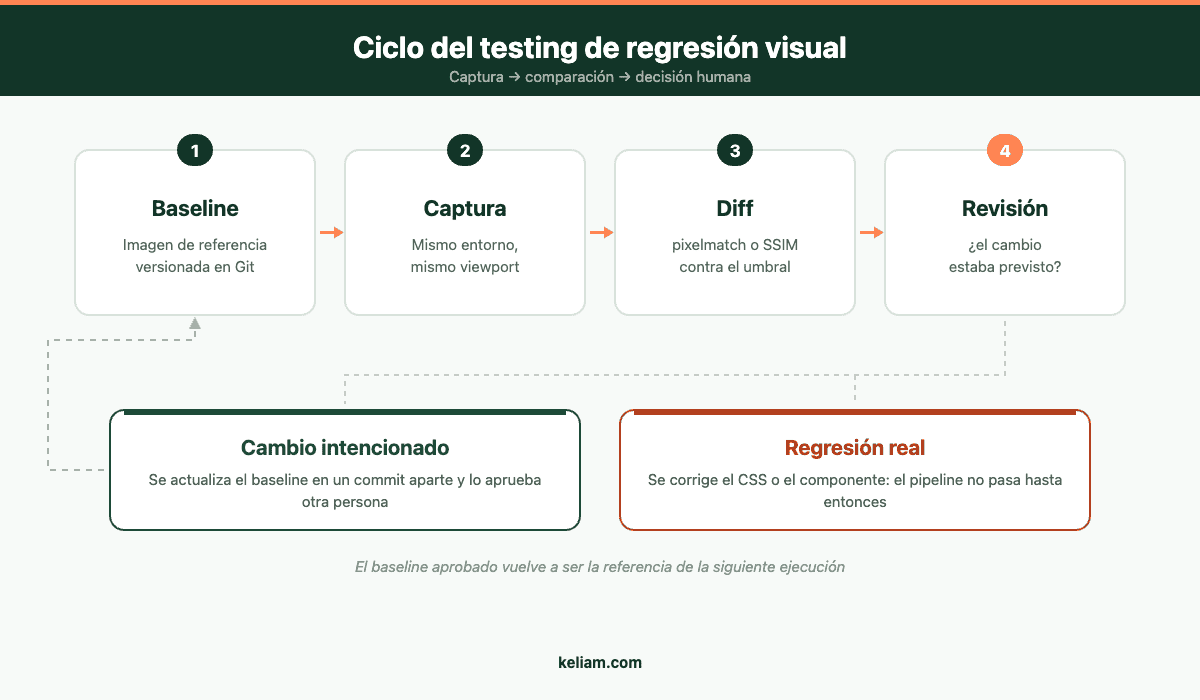
La definición es sencilla: se captura una imagen de un componente, una página o un paso de un flujo, se guarda como baseline (imagen de referencia), y en cada ejecución posterior se vuelve a capturar y se comparan las dos imágenes. Si la diferencia supera el umbral configurado, el test falla y alguien tiene que decidir si el cambio era intencionado.
La parte interesante no es la comparación —eso lo resuelve una librería— sino las dos decisiones que la rodean: qué capturas y quién aprueba los cambios.
1.1 La diferencia con los tests funcionales
Un test funcional afirma cosas concretas: «al pulsar este botón, la cesta tiene tres artículos». Un test visual no afirma nada: solo dice «esto se parece a lo de antes». Esa falta de intención explícita es su mayor ventaja y su mayor defecto.
La ventaja es la cobertura por defecto. No hay que enumerar todo lo que puede salir mal en un layout —y nadie lo haría bien— porque la captura lo cubre entero: tipografías, espaciados, colores, estados de foco, orden de los elementos, recortes. El defecto es que cualquier cambio deliberado también aparece como fallo, así que hay un coste de revisión humana permanente que no desaparece nunca.
Por eso los dos tipos no compiten, se complementan. El funcional protege el comportamiento; el visual protege la presentación. Si tu equipo aún no tiene una base de tests funcionales razonable, el visual no es el siguiente paso: es una manera carísima de descubrir que el checkout no funciona.
1.2 Qué fallos detecta de verdad
Por nuestra experiencia en mantenimiento, estos son los casos en los que la suite visual se paga sola:
- Actualizaciones de dependencias de CSS. Un salto menor de Tailwind, Bootstrap o un sistema de diseño propio que cambia un valor de
line-heighty descoloca cincuenta pantallas a la vez. - Refactors de CSS. Renombrar clases, eliminar reglas «muertas» o unificar variables. Es el escenario clásico: el refactor está bien en el 95% de las vistas y roto en el 5% que nadie miró.
- Cambios de contenido en el CMS. Un título más largo de lo previsto, una imagen sin recortar, un bloque que desborda el contenedor.
- Cambios de navegador. Una versión nueva de Chrome o Safari que cambia el renderizado de
inputnativos, debackdrop-filtero de fuentes variables. - Regresiones de accesibilidad visibles. Un estado de foco que desaparece al cambiar un
outline, o un contraste que se degrada. No sustituye a una auditoría —para eso conviene leer qué exige la European Accessibility Act en materia de accesibilidad web— pero sí detecta el momento exacto en que se rompe. - Emails transaccionales y PDFs generados. Olvidado casi siempre, y donde los fallos pasan meses sin que nadie los vea.
Y, siendo honestos, lo que no detecta: nada que no sea visible. Si la web se ve exactamente igual pero el precio que se envía al TPV es el anterior, el diff será perfecto y el pipeline verde.
2. Cómo funciona por dentro: baseline, captura y diff
Entender el motor de comparación no es un lujo académico: es lo que permite elegir umbrales con criterio en lugar de a base de prueba y error.
2.1 Comparación por píxeles
La inmensa mayoría de herramientas del ecosistema JavaScript usan por debajo pixelmatch (o un derivado). El algoritmo recorre las dos imágenes píxel a píxel, convierte cada par de colores a un espacio perceptual YIQ y calcula una distancia. Si la distancia supera el parámetro threshold, ese píxel se marca como distinto. Al final se cuentan los píxeles marcados.
Esto tiene dos consecuencias prácticas. La primera: threshold no es «cuánto puede cambiar la página», es «cuánto puede cambiar un píxel para seguir considerándose igual». La segunda: el antialiasing de texto genera siempre decenas o cientos de píxeles técnicamente distintos sin que nada haya cambiado. De ahí los falsos positivos.
2.2 Comparación perceptual
La alternativa son los comparadores perceptuales, que trabajan por bloques en lugar de por píxel. El más conocido es SSIM (structural similarity), que compara luminancia, contraste y estructura en ventanas de la imagen. Un desplazamiento de un píxel en todo un bloque de texto, que para pixelmatch es un terremoto, para SSIM es prácticamente idéntico.
El coste es el contrario: SSIM puede pasar por alto cambios pequeños pero importantes, como un icono que cambia de color sin cambiar de forma. La regla que seguimos: pixelmatch para componentes aislados con fondo controlado, SSIM (o el modo «visual AI» de las herramientas comerciales, que es una variante entrenada de lo mismo) para páginas completas con mucho texto.
2.3 Umbrales: los tres parámetros que importan
Tanto en Playwright como en Vitest la configuración gira alrededor de tres valores, con nombres distintos y el mismo significado:
| Concepto | Playwright | Vitest 4 | Para qué sirve |
|---|---|---|---|
| Sensibilidad por píxel | threshold |
threshold |
Absorber antialiasing y perfiles de color |
| Tolerancia absoluta | maxDiffPixels |
allowedMismatchedPixels |
Componentes pequeños, donde un % es engañoso |
| Tolerancia relativa | maxDiffPixelRatio |
allowedMismatchedPixelRatio |
Páginas completas de altura variable |
Si se configuran a la vez la tolerancia absoluta y la relativa, Vitest aplica la más estricta de las dos; conviene no asumir que una «desactiva» a la otra. Y un consejo que ahorra discusiones: fija la tolerancia relativa en el proyecto (algo entre el 0,1% y el 0,5% suele ser suficiente para absorber ruido sin tapar cambios reales) y usa la absoluta solo como excepción en tests concretos. Un valor global generoso es la manera más rápida de tener una suite que no detecta nada.
3. Las tres escalas: componente, página y flujo
Montar «testing visual» sin decidir a qué nivel se captura es la causa número uno de suites inmantenibles. Hay tres niveles y cada uno tiene un perfil de coste y de ruido muy distinto.
3.1 Nivel componente
Se captura un componente aislado, normalmente servido por Storybook o por el browser mode de Vitest. Es el nivel con menos ruido, porque no hay datos reales, ni red, ni contenido de CMS: el componente recibe props fijas y se renderiza igual siempre.
Es también el nivel que detecta los fallos más baratos de arreglar, porque el diff apunta directamente al componente culpable. Si tienes un sistema de diseño, aquí es donde debe estar el 80% de tu cobertura visual.
3.2 Nivel página
Se captura una URL completa, normalmente con fullPage: true. Detecta los fallos de composición que el nivel componente no puede ver: dos componentes correctos que juntos se solapan, un grid que colapsa, un footer que se come el contenido.
El problema es el ruido: una página real trae datos reales, y los datos cambian. Aquí es obligatorio trabajar con fixtures o con una base de datos de prueba congelada, no con el entorno de preproducción que alimenta el cliente. Si la portada muestra «últimos productos», cada despliegue será un fallo visual.
3.3 Nivel flujo
Capturas en varios pasos de un recorrido: ficha de producto, cesta, datos de envío, pago, confirmación. Es el nivel más caro de mantener y el que más valor tiene en ecommerce, porque el checkout es donde un fallo de layout se traduce en dinero en el mismo día. Si estás reconstruyendo o heredando una tienda, este nivel encaja de forma natural con el trabajo de auditoría técnica de una tienda online heredada: primero se inventaría qué hay, luego se blinda lo que no debe moverse.
Nuestra recomendación para empezar: entre 8 y 15 capturas en total, cubriendo las dos o tres plantillas más usadas y el flujo de conversión, con dos viewports (móvil y escritorio). No cuarenta. Una suite pequeña y fiable se amplía; una suite grande y ruidosa se borra.
4. Playwright: el camino más corto para empezar
Si el proyecto ya tiene Playwright para tests end-to-end —y en 2026 es lo más habitual— la regresión visual no requiere instalar nada. La aserción toHaveScreenshot() ya está ahí.
4.1 El test mínimo
import { test, expect } from '@playwright/test';

test('portada no cambia @visual', async ({ page }) => {
  await page.goto('/');
  await expect(page).toHaveScreenshot('portada.png', {
    fullPage: true,
    animations: 'disabled',
    caret: 'hide',
    maxDiffPixelRatio: 0.002,
  });
});
En la primera ejecución no hay baseline: Playwright la genera y el test pasa. A partir de la segunda, compara. Las imágenes se guardan junto al archivo de test, en una carpeta con el sufijo -snapshots, y el nombre del fichero incluye el navegador y el sistema operativo, porque Chromium, Firefox y WebKit renderizan distinto y mezclarlos no tiene sentido.
4.2 Las cuatro opciones que quitan el 90% del ruido
animations: 'disabled'— congela las animaciones CSS y las transiciones y las lleva a su estado final. Sin esto, cualquier fade-in convierte el test en una lotería.caret: 'hide'— oculta el cursor de texto parpadeante. Un clásico: el test falla una de cada dos veces en un formulario y nadie entiende por qué.mask: [locator]— tapa con un rectángulo sólido las zonas volátiles: fechas, contadores, avatares de terceros, banners de publicidad. Es preferible a excluir la captura entera.stylePath— inyecta una hoja de estilo solo durante la captura. Es la herramienta más potente de todas: permite ocultar el widget de chat, fijar la fuente, deshabilitarposition: stickyo neutralizar el lazy loading de imágenes, sin tocar el código de producción.
Una hoja de estilos de captura típica cabe en diez líneas:
/* screenshot.css */
*, *::before, *::after {
  animation: none !important;
  transition: none !important;
  caret-color: transparent !important;
}
[data-chat-widget], .cookie-banner, .ad-slot { display: none !important; }
img { image-rendering: pixelated; }
html { scrollbar-width: none; }
4.3 Organizar los baselines
Por defecto los nombres de fichero se derivan del título del test, lo que significa que renombrar un test deja huérfana su imagen. Para proyectos con más de veinte capturas conviene fijar la ruta explícitamente con snapshotPathTemplate en playwright.config.ts, de modo que el árbol de imágenes sea predecible y los conflictos de Git sean legibles.
Y una decisión de gobierno, no técnica: los baselines se versionan en el repositorio. Son binarios, sí, y engordan el repo. Pero si viven en un bucket o en caché de CI, tarde o temprano alguien no sabe contra qué se está comparando. Si el peso se vuelve un problema real, ese es el momento de pasar a un servicio en la nube, no de inventar un almacenamiento propio.
4.4 Actualizar baselines sin perder la confianza
El comando npx playwright test --update-snapshots regenera las referencias. Es también la puerta por la que se cuelan todas las regresiones del mundo, porque es muchísimo más rápido ejecutarlo que mirar el diff.
Dos reglas que funcionan en equipos reales: la actualización de baselines va siempre en un commit separado, nunca mezclada con el cambio funcional; y ese commit se revisa mirando las imágenes, no el diff de texto —que es ilegible por definición. Si tu plataforma de revisión de código no muestra previsualización de imágenes en los pull requests, es señal de que necesitas una herramienta con interfaz de revisión.
5. Vitest 4 y el testing visual de componentes
Vitest 4, publicado el 22 de octubre de 2025, quitó la etiqueta de experimental al Browser Mode e incorporó comparación de capturas con la aserción toMatchScreenshot(). Para proyectos que ya testean componentes con Vitest, esto elimina el salto a una herramienta distinta solo para lo visual.
import { expect, test } from 'vitest';
import { render } from 'vitest-browser-react';
import Button from './Button';

test('boton primario', async () => {
  const screen = render(<Button variant="primary">Comprar</Button>);
  await expect(screen.getByRole('button'))
    .toMatchScreenshot('button-primary', {
      comparatorName: 'pixelmatch',
      comparatorOptions: { allowedMismatchedPixelRatio: 0.001 },
    });
});
Dos detalles que conviene saber de antemano. Primero, las referencias se guardan en __screenshots__ con el navegador y la plataforma en el nombre del fichero (...-chromium-darwin.png, ...-chromium-linux.png), y la documentación es explícita: hay que commitearlas. Segundo, además de pixelmatch se pueden registrar comparadores perceptuales como SSIM o GMSD cuando la comparación por píxel genera demasiado ruido.
La propia documentación de Vitest advierte de lo que vamos a tratar en el apartado siguiente, y vale la pena citarlo porque resume el problema entero: incluso entornos aparentemente idénticos pueden producir diferencias de renderizado sutiles.
¿Montamos la red de seguridad visual de tu proyecto?
En Keliam implantamos suites de regresión visual sobre Playwright o Vitest, las metemos en tu pipeline y dejamos el entorno dockerizado para que el verde signifique algo. Si lo que necesitas es primero saber en qué estado está el proyecto, empezamos por la auditoría.
6. El problema real no es la herramienta, es el entorno
Aquí es donde se decide si la suite sobrevive. Todas las herramientas serias dicen lo mismo: las capturas solo son comparables si se generan en un entorno controlado y estable.
6.1 Por qué tu portátil nunca va a coincidir con el runner
El renderizado de una página depende del sistema operativo, de las fuentes instaladas, del motor de suavizado de texto, de la versión del navegador, de la aceleración por GPU, del factor de escala de pantalla y del perfil de color. La documentación de Playwright añade incluso un factor que suena a broma y no lo es: si el portátil está enchufado o con batería, porque eso cambia las decisiones de la GPU.
La consecuencia operativa: los baselines generados en macOS no sirven en un runner Linux. No hay umbral razonable que arregle eso; las diferencias de hinting tipográfico afectan a cada letra de la página.
6.2 Docker con versión fijada
La solución estándar es ejecutar las capturas dentro de la imagen oficial de Playwright, tanto en CI como en local. Dos condiciones, y las dos se incumplen a menudo:
- La etiqueta de la imagen debe coincidir exactamente con la versión de
@playwright/testdelpackage.json. Usar:latestsignifica que un día la imagen cambia de versión de Chromium y toda la suite falla a la vez, sin que nadie haya tocado el código. - La imagen debe traer las fuentes del proyecto. Si tu web usa una tipografía de pago instalada en el equipo de diseño, en el contenedor se renderiza con la fuente de reemplazo. Hay que instalarla en la imagen o servirla como web font desde el propio proyecto, y en cualquier caso esperar a que la fuente haya cargado antes de capturar.
# Misma versión que @playwright/test en package.json
FROM mcr.microsoft.com/playwright:v<VERSION>-noble
WORKDIR /app
COPY fonts/ /usr/share/fonts/truetype/proyecto/
RUN fc-cache -f
COPY package*.json ./
RUN npm ci
COPY . .
CMD ["npx", "playwright", "test", "--grep", "@visual"]
6.3 Generar los baselines solo en CI
La variante más limpia que conocemos: nadie genera baselines en su máquina. Cuando hace falta actualizarlos, se lanza un job manual en CI que ejecuta la suite con la bandera de actualización y abre un pull request con las imágenes nuevas. Así hay un único entorno de verdad y el cambio de imágenes pasa por revisión igual que el código.
Es también la forma de evitar la discusión eterna sobre si hay que ejecutar los tests visuales en local. La respuesta práctica: en local se ejecutan dentro del contenedor cuando se está tocando CSS, y nunca como requisito para hacer commit.
7. Checklist de determinismo: cómo matar el flakiness
Si una suite visual falla sin motivo más de una vez a la semana, el equipo deja de confiar en ella. Esta es la lista que repasamos cuando nos encontramos una suite ruidosa, ordenada por frecuencia de la causa:
- Datos no congelados. Fechas relativas («hace 3 horas»), contadores, listados ordenados por aleatorio, stock, precios dinámicos. Solución: fixtures fijas, reloj del navegador congelado con un valor conocido y, si hay algo que no se puede fijar,
mask. - Animaciones y transiciones. Resuelto con
animations: 'disabled'más la hoja de estilos de captura; cuidado con las animaciones implementadas en JavaScript, que no se desactivan por CSS. - Recursos de terceros. Fuentes de Google, mapas, vídeos embebidos, widgets de chat, píxeles de analítica. Se interceptan a nivel de red y se sirven en blanco o se bloquean. Como efecto colateral, la suite deja de depender de que un CDN ajeno esté disponible.
- Imágenes con carga diferida. El
fullPagehace scroll para capturar y dispara cargas a media captura. Hay que forzar la carga previa o desactivar elloading="lazy"durante la captura. - Barras de desplazamiento. Aparecen y desaparecen según el alto del contenido, desplazan todo el layout unos píxeles y afectan a la captura entera. Se ocultan por CSS.
- Viewport y densidad. El tamaño de la ventana y el
deviceScaleFactorse fijan en la configuración del proyecto. Nunca se dejan al criterio del runner. - Estado de foco y hover. Si el test hace clic antes de capturar, el elemento queda enfocado; si mueve el ratón, puede quedar en hover. Son diferencias legítimas que conviene provocar o eliminar de forma explícita, no por accidente.
Un detalle de método que marca mucha diferencia: cuando una captura falla de forma intermitente, no subas el umbral. Ejecuta el mismo test tres veces seguidas en el mismo entorno y mira el diff. Si el ruido se mueve de sitio entre ejecuciones, es flakiness y hay una causa concreta de esta lista. Si el ruido está siempre en el mismo sitio, es una regresión real. Subir el umbral mezcla ambos casos y es la forma más eficaz de convertir la suite en adorno.
8. Herramientas: qué usar según el tamaño del equipo
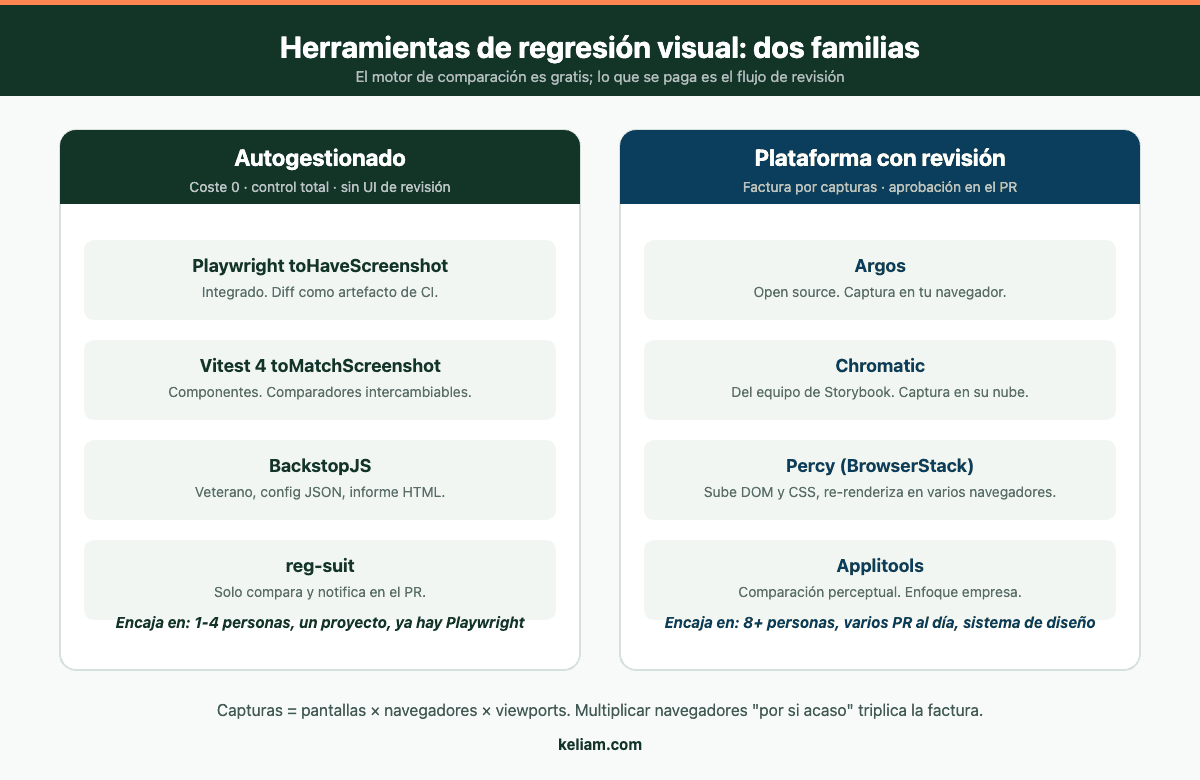
Conviene separar dos cosas que se mezclan siempre: el motor de captura y comparación y la plataforma de revisión. Casi todas las herramientas de pago venden lo segundo; lo primero es comodidad, no tecnología diferencial.
8.1 Autogestionado y gratis
- Playwright
toHaveScreenshot— cero dependencias nuevas si ya usas Playwright. No tiene interfaz de revisión en equipo: el diff se ve como artefacto del pipeline. Es la opción correcta para empezar y para equipos de hasta cuatro o cinco personas. - Vitest 4
toMatchScreenshot— el equivalente para componentes, con comparadores intercambiables. Encaja de forma natural si el proyecto ya testea con Vitest. - BackstopJS — el veterano del ecosistema. Configuración declarativa por JSON, informes HTML autocontenidos y control total de la infraestructura. Su ritmo de desarrollo es muy pausado, así que para proyectos nuevos tiene poco sentido frente a Playwright; para los que ya lo usan, sigue haciendo su trabajo.
- reg-suit — no captura: solo compara, publica el informe y lo notifica en el pull request, con el almacenamiento de imágenes que le pongas (S3 o similar). Útil cuando ya tienes un script de capturas propio y lo que falta es la parte de revisión.
8.2 Plataformas con revisión en la nube
Lo que se compra aquí es una interfaz donde ver todos los diffs de un pull request, aprobarlos con un clic, dejar comentarios y bloquear el merge hasta que alguien revise. Para un equipo de diez personas eso vale dinero, porque el cuello de botella deja de ser técnico y pasa a ser organizativo.
- Argos — de código abierto, se integra con Playwright y Cypress capturando en tu propio navegador y subiendo las imágenes. Modelo de precio por capturas con un plan gratuito, lo que lo hace la opción con menos fricción para dar el salto desde Playwright puro.
- Chromatic — creado por el equipo de Storybook, es la referencia si tu sistema de diseño ya vive ahí. Captura en su propia infraestructura y factura por snapshots, así que el coste crece con el número de viewports y navegadores.
- Percy (BrowserStack) — sube el DOM y el CSS y re-renderiza en su nube en varios navegadores, lo que resuelve la comparación entre navegadores sin que tú mantengas esos entornos.
- Applitools — enfoque de comparación «perceptual asistida» pensado para empresa grande, con contratos anuales. Su argumento es precisamente ignorar el ruido de renderizado que obliga a pelearse con los umbrales.
Los precios de todas ellas cambian con frecuencia y dependen del volumen de capturas, así que la cifra concreta hay que mirarla el día que se decide. Lo que no cambia es la estructura del coste: se factura por capturas, y el número de capturas es el producto de pantallas por navegadores por viewports. Multiplicar por tres navegadores «por si acaso» triplica la factura y, en la práctica, detecta muy pocos fallos extra.
8.3 Criterios de decisión
| Situación | Recomendación |
|---|---|
| Proyecto único, 1-4 desarrolladores, ya hay Playwright | Playwright nativo + Docker. Coste cero. |
| Sistema de diseño en Storybook, varios productos | Chromatic, o Vitest + Argos si se prefiere gastar menos |
| Equipo de 8+ personas, muchos pull requests diarios | Plataforma con revisión (Argos, Chromatic): el ahorro está en el flujo, no en la captura |
| Requisito de comparar en Safari y Firefox reales | Percy o Applitools, o aceptar el coste de mantener esos entornos |
| Agencia con muchos proyectos pequeños de CMS | Playwright nativo con una plantilla reutilizable de configuración |
9. Integración en CI/CD: el flujo que sí se usa
Un detalle de diseño del pipeline que determina si el equipo acepta la suite: los tests visuales no deben estar en el mismo job que los funcionales. Son más lentos, generan artefactos pesados y fallan por motivos distintos. Mezclarlos significa esperar cinco minutos extra para saber si un test unitario ha pasado.
El patrón habitual es etiquetar los tests visuales (@visual en Playwright) y excluirlos de la ejecución estándar con --grep-invert, dejándolos en un job propio que corre en el contenedor.
9.1 Un job separado
visual:
  runs-on: ubuntu-latest
  container:
    image: mcr.microsoft.com/playwright:v<VERSION>-noble
  steps:
    - uses: actions/checkout@v4
    - run: npm ci
    - run: npx playwright test --grep "@visual"
    - if: failure()
      uses: actions/upload-artifact@v4
      with:
        name: visual-diffs
        path: test-results/
        retention-days: 7
9.2 Artefactos y reporte
Cuando un test visual falla, el pipeline debe dejar accesibles las tres imágenes: la referencia, la obtenida y el diff. Un fallo visual sin las imágenes es inútil, porque nadie va a reproducirlo en local para verlo. Publicar el informe HTML de Playwright como artefacto suele ser suficiente; si además lo expones en una URL temporal por pull request, la revisión pasa de diez minutos a treinta segundos.
Esta es, por cierto, la misma lógica que aplicamos al resto de métricas de calidad: si el dato no está delante de quien tiene que decidir, no existe. Lo tratamos con más detalle al hablar de métricas y herramientas de auditoría de rendimiento web, y es un criterio que también guía la auditoría de código profesional.
9.3 Quién aprueba un cambio visual
La pregunta que nadie hace al montar la suite y que la mata a los dos meses. Si la respuesta es «el que haya hecho el cambio», el único control real es su prisa de ese día.
Lo que funciona: el autor del pull request propone la actualización del baseline, y una segunda persona —diseño si existe, otro desarrollador si no— la aprueba. Con una plataforma de revisión esto es un botón. Sin ella, es un comentario en el pull request diciendo «visual revisado» y una regla de protección de rama que exige la aprobación. Lo importante no es la herramienta, es que la aprobación sea de alguien distinto al autor.
10. Cuánto cuesta mantenerlo y cuándo no merece la pena
Siendo honestos sobre el coste: la implantación inicial de una suite de 10-15 capturas con Docker y CI son entre dos y cuatro días de trabajo, dependiendo de lo sucia que esté la web en cuanto a contenido dinámico y terceros. El mantenimiento posterior son unos minutos por pull request que toque interfaz, más una revisión trimestral para quitar capturas que ya no aportan.
El coste oculto está en el contenido dinámico. Una web corporativa con datos estables es barata de cubrir; un portal con contenido que cambia cada hora puede necesitar más trabajo de preparación de datos que de tests. Ese esfuerzo de inventario y saneamiento suele formar parte del trabajo más amplio de detectar y reducir deuda técnica, y no debería imputarse solo a la suite visual.
Y los casos en los que recomendamos no hacerlo:
- Proyectos en rediseño activo. Si el layout va a cambiar entero en seis semanas, todas las capturas serán ruido. Se monta después.
- Interfaces generadas dinámicamente sin estructura estable. Paneles configurables por el usuario, dashboards con widgets arrastrables. Aquí el nivel componente sí vale; el nivel página, no.
- Equipos sin tests funcionales. El orden importa: primero el comportamiento, luego el aspecto.
- Webs que se tocan dos veces al año. El coste de mantener los baselines supera el de revisar a mano cuatro páginas.
Un matiz sobre este último punto: si la web se toca poco pero las dependencias se actualizan solas —algo habitual en WordPress y en cualquier proyecto con actualizaciones automáticas—, la suite visual sí se paga, porque el cambio no lo introduce tu equipo sino un plugin a las tres de la mañana.
11. Plan de implantación en cuatro semanas
Así lo hacemos cuando entramos en un proyecto que no tiene nada:
- Semana 1 — Inventario y entorno. Elegir las 8-15 vistas que cubren el negocio. Levantar el
Dockerfilecon la versión fijada y las fuentes del proyecto. Comprobar que dos ejecuciones seguidas sin cambios dan cero diferencias: si no, no se sigue. - Semana 2 — Determinismo. Fixtures, reloj congelado, bloqueo de terceros, hoja de estilos de captura, máscaras sobre lo que no se pueda fijar. Es la semana que decide el resultado y la que todo el mundo intenta saltarse.
- Semana 3 — Baselines y CI. Generar las referencias dentro del contenedor, versionarlas, montar el job separado con subida de artefactos y dejar el test visual sin bloquear el merge todavía.
- Semana 4 — Gobierno. Documentar cómo se actualiza un baseline y quién lo aprueba, activar la protección de rama y, solo entonces, hacer que el fallo visual bloquee. Una suite que bloquea antes de ser fiable se desactiva en una semana y no vuelve.
El indicador de que ha salido bien no es el número de capturas, es otro: que en el último mes nadie haya ejecutado la actualización de baselines sin mirar las imágenes. Si eso se cumple, la suite está viva. Si no, es un gasto con apariencia de calidad. Esa misma distinción —proceso que se cumple frente a proceso documentado— es la que marca la diferencia en cualquier revisión de calidad de un proyecto, y la que buscamos en una auditoría técnica de software.
Conclusión
El testing de regresión visual es una de esas prácticas donde la herramienta es la parte fácil. Playwright y Vitest ya traen la comparación de capturas integrada, y montar el primer test es cosa de media hora. Lo que separa una suite que protege de una que estorba son tres decisiones que no tienen nada de glamurosa: un entorno dockerizado con la versión fijada, un trabajo serio de determinismo sobre datos, animaciones y terceros, y una regla clara sobre quién aprueba un cambio de baseline.
Si sólo puedes hacer una cosa, empieza pequeño: diez capturas de las plantillas que más dinero mueven, dos viewports, un job propio en CI que no bloquee hasta que sea fiable. Esa suite detecta la mayoría de los fallos de layout que hoy descubre un cliente por teléfono, y cuesta menos de mantener que la siguiente llamada de un viernes por la tarde.
Y si tu proyecto ya tiene una suite visual que el equipo ha aprendido a ignorar, el problema no es la herramienta: es el ruido. Se arregla con la lista del apartado 7, no cambiando de producto.
Preguntas frecuentes sobre testing de regresión visual
¿Hace falta una herramienta de pago para empezar?
No. Playwright y Vitest incluyen comparación de capturas sin coste y resuelven el caso de equipos pequeños. Lo que se compra al pasar a una plataforma de pago es la interfaz de revisión y aprobación de diffs en los pull requests, que empieza a merecer la pena cuando hay varias personas tocando interfaz a diario.
¿Qué umbral debo poner?
Empieza por una tolerancia relativa muy baja —del orden del 0,1% al 0,5% de píxeles— y resuelve los falsos positivos atacando su causa, no subiendo el número. Si necesitas tolerancias altas para que la suite pase, el entorno no es determinista y el umbral solo está tapando el síntoma.
¿Puedo ejecutar los tests visuales en mi Mac si el CI es Linux?
Para desarrollar sí, pero las imágenes de referencia válidas son las del entorno de CI. El renderizado de fuentes de macOS y Linux es distinto y ningún umbral razonable cubre esa diferencia. La práctica recomendada es ejecutar siempre dentro de la imagen Docker, también en local.
¿Los baselines se guardan en Git o en la nube?
En Git mientras el volumen sea manejable: así siempre se sabe contra qué se compara y el cambio de imágenes pasa por revisión de código. Cuando el peso del repositorio empieza a molestar, el paso natural es una plataforma que las almacene y las muestre, no un bucket gestionado a mano.
¿Esto sustituye a los tests de accesibilidad?
No. La regresión visual detecta que un estado de foco o un contraste ha cambiado, pero no evalúa si cumple un criterio. Son capas complementarias: un analizador automático de accesibilidad comprueba reglas, la suite visual avisa de cuándo se rompieron.
¿Cuántas capturas son demasiadas?
No hay número mágico, pero sí una señal: si el equipo tarda más de cinco minutos en revisar los diffs de un pull request normal, hay demasiadas o están al nivel equivocado. Suele arreglarse bajando capturas de página completa a nivel de componente.