Actualizado en octubre de 2026
Este artículo se publicó en febrero de 2026, cuando Opus 4.6 estrenó la ventana de un millón de tokens. Desde entonces la línea Opus ha pasado por cuatro versiones más y el millón de tokens ya es el estándar, no la novedad. El análisis de fondo sigue vigente —lo que cambia cuando un modelo ve el proyecto entero—, y más abajo encontrarás el estado de la línea Opus a día de hoy, los precios actuales y lo que hemos aprendido usándola en producción.
Claude Opus 4.6: el modelo que lo cambia todo
El 5 de febrero de 2026, Anthropic lanzó Claude Opus 4.6 con una ventana de contexto de un millón de tokens. Este no es solo un número impresionante: es la diferencia entre poder analizar un archivo y poder analizar un proyecto entero. Para equipos de desarrollo, esto equivale a tener un compañero que ha leído todo tu código, toda tu documentación y todo tu histórico de tickets antes de empezar a trabajar.
Un millón de tokens en contexto: qué significa en la práctica
Un millón de tokens equivale aproximadamente a 750.000 palabras o 4.000 páginas de texto. En términos de código, estamos hablando de poder cargar un proyecto completo de tamaño medio: todos los archivos fuente, tests, configuración, documentación y README. El modelo puede entonces razonar sobre el proyecto como un todo, identificando dependencias, patrones y oportunidades de mejora que serían imposibles de detectar analizando archivo por archivo.
Para equipos que mantienen plataformas complejas con SuiteCRM, esto significa poder pasar la base de código del CRM junto con los módulos personalizados y pedir al modelo que identifique inconsistencias, vulnerabilidades o código muerto.
Qué ha pasado desde febrero: la línea Opus en 2026
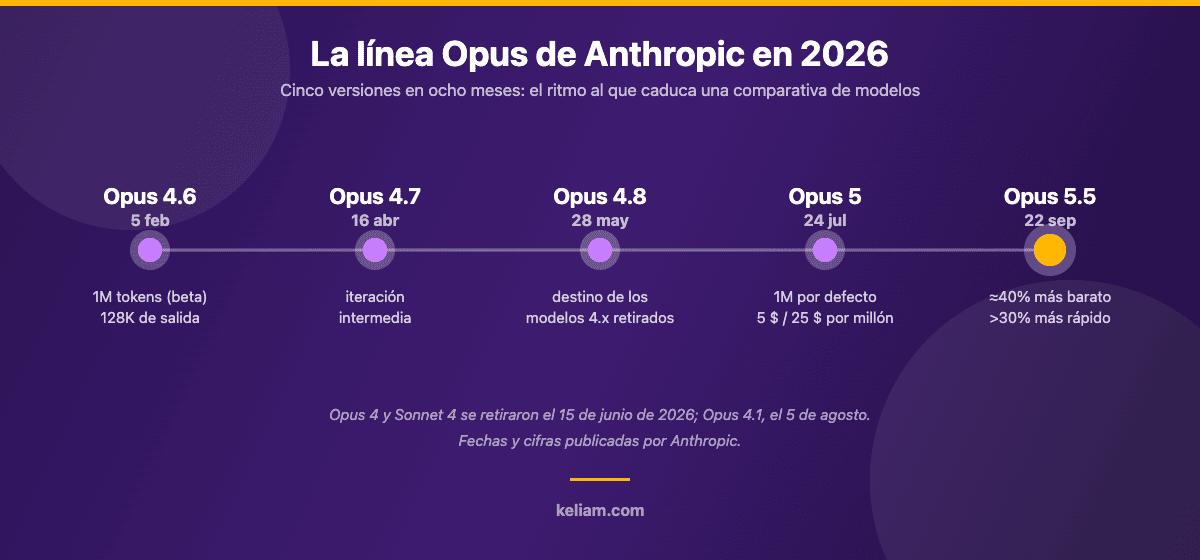
Si hay una lección operativa en este año, es que una comparativa de modelos caduca en semanas. Opus 4.6 fue el modelo que normalizó el millón de tokens, pero no fue el último:
| Versión | Fecha | Lo relevante |
|---|---|---|
| Opus 4.6 | 5 de febrero de 2026 | Ventana de 1M de tokens en beta y 128K de salida |
| Opus 4.7 | 16 de abril de 2026 | Iteración intermedia de la rama 4.x |
| Opus 4.8 | 28 de mayo de 2026 | Modelo de destino recomendado al retirarse Opus 4, Sonnet 4 y Opus 4.1 |
| Opus 5 | 24 de julio de 2026 | 1M de tokens por defecto, 128K de salida, 5 $ / 25 $ por millón de tokens |
| Opus 5.5 | 22 de septiembre de 2026 | Según Anthropic, ~40% más barato y más de un 30% más rápido que Opus 5 |
Dos consecuencias prácticas, y las dos afectan a cualquier integración en producción. La primera: los modelos se retiran. Claude Opus 4 y Sonnet 4 dejaron de estar disponibles el 15 de junio de 2026, y Opus 4.1 el 5 de agosto. Si una integración fija el identificador exacto del modelo en el código —y casi todas lo hacen— llega un día en que la API responde con un error y nadie recuerda quién escribió esa línea. La recomendación es tratar el nombre del modelo como configuración, no como constante, y suscribirse a los avisos de deprecación del proveedor.
La segunda: el precio por token cae mientras la capacidad sube, lo que invierte la lógica de muchas decisiones de arquitectura tomadas en 2025. Flujos que entonces se descartaron por coste —pasar un repositorio entero en cada revisión, analizar toda la documentación en cada consulta— hoy salen a cuenta. Conviene revisar las decisiones que se tomaron «porque era carísimo» antes de dar por buena la arquitectura actual.
Y una tercera, menos comentada: las versiones recientes aplican enrutado por política de seguridad. En Opus 5.5, cierto trabajo sensible de ciberseguridad o de biología se deriva automáticamente a modelos anteriores salvo que la organización pase por un programa de verificación. Para un equipo que construye herramientas de seguridad, eso significa que la calidad de la respuesta puede variar según el tema, no solo según el modelo elegido.
Uso de ordenador: Claude opera aplicaciones
Opus 4.6 trae mejoras dramáticas en la capacidad de usar un ordenador: operar software, navegar navegadores, rellenar formularios y interactuar con interfaces gráficas. Esta funcionalidad, integrada en Cowork, permite automatizar tareas que antes requerían intervención manual y conocimiento de la interfaz específica de cada aplicación.
Cómo usar un millón de tokens sin arruinarte
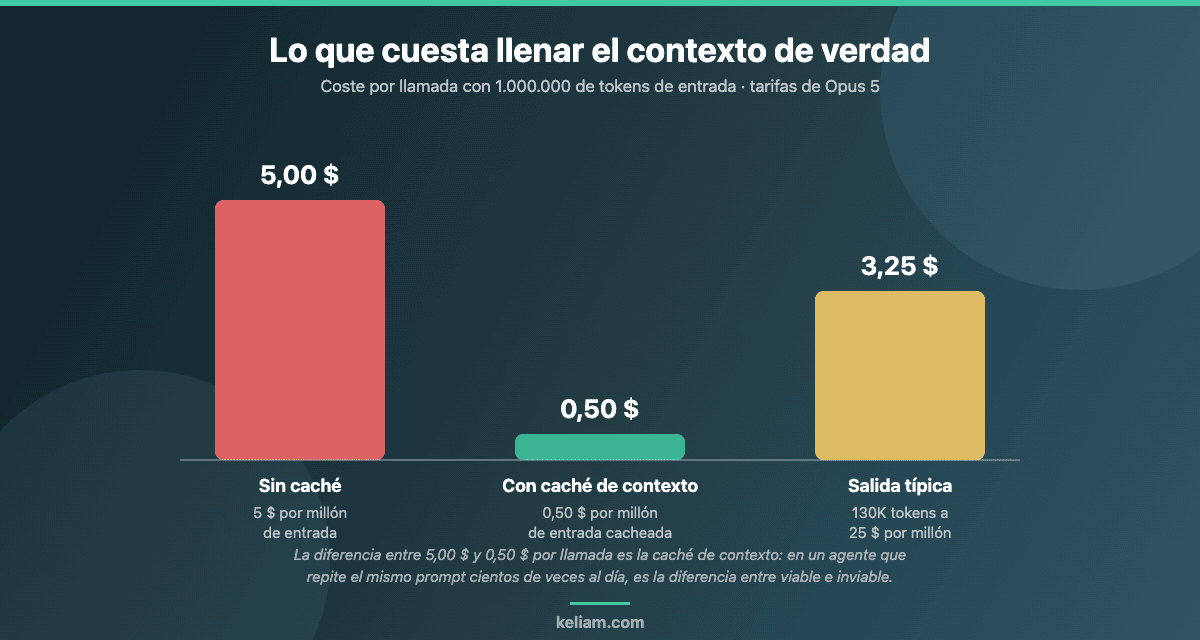
La parte que casi nadie cuenta de una ventana de contexto enorme es la factura. Con las tarifas de Opus 5 —5 $ por millón de tokens de entrada y 25 $ por millón de salida—, llenar el contexto de verdad cuesta cinco dólares por llamada. Una sola. Un agente que repita ese prompt doscientas veces al día son mil dólares diarios, y ahí es donde muchos pilotos de IA mueren sin llegar a producción.
Las tres palancas que lo cambian todo:
- Caché de contexto. El mismo millón de tokens cacheado cuesta 0,50 $: una décima parte. La clave está en ordenar el prompt de forma que la parte estable —código base, documentación, instrucciones del sistema— vaya primero y lo variable al final. Si cada llamada cambia el principio del prompt, la caché no sirve de nada.
- Elegir el modelo por tarea, no por prestigio. Clasificar un ticket, extraer campos de una factura o resumir un correo no necesita el modelo más capaz. Un patrón que funciona bien: Haiku o Sonnet para el 80 % del volumen y Opus solo para lo que de verdad requiere razonamiento largo. La diferencia de coste entre ambas capas es de un orden de magnitud.
- No meter todo «porque cabe». Que un proyecto entre en el contexto no significa que deba entrar. El rendimiento no es uniforme a lo largo de una ventana de un millón de tokens: la información enterrada en el medio se usa peor que la que está al principio o al final. Un contexto de 80.000 tokens bien seleccionados suele dar mejores respuestas que 900.000 sin filtrar.
Ese último punto es la razón por la que RAG no ha muerto con las ventanas grandes: recuperar los diez fragmentos relevantes sigue siendo más barato, más rápido y a menudo más preciso que volcar el corpus completo. La ventana grande no sustituye a la recuperación; elimina la necesidad de trocear artificialmente los documentos que sí hay que leer enteros, como un contrato o un informe anual.
Y para que el modelo acceda a los datos vivos del negocio sin copiarlos al prompt, el camino estándar hoy es conectar las herramientas internas por MCP: el modelo pide lo que necesita cuando lo necesita, en lugar de recibir de entrada un volcado de la base de datos.
Análisis de documentos de nivel empresarial
Con la ventana de contexto ampliada, Opus 4.6 puede procesar documentos empresariales extensos de una sola vez: contratos legales, informes financieros anuales, documentación técnica de APIs y manuales de producto. La capacidad de mantener todo el documento en contexto elimina los errores de resumen que ocurrían cuando el modelo solo podía ver fragmentos.
Mejoras en codificación y razonamiento
Más allá del contexto, Opus 4.6 muestra mejoras significativas en calidad de código generado, capacidad de debugging con stack traces completos, refactorizaciones que mantienen el comportamiento, generación de tests exhaustivos y documentación técnica que refleja fielmente la implementación.
En nuestros proyectos de prototipado con IA, Opus 4.6 ha reducido los tiempos de desarrollo en un 30-40% respecto a modelos anteriores, especialmente en fases de implementación y testing.
Qué significa un millón de tokens en un proyecto real
En los proyectos de mantenimiento de plataformas que llevamos, la ventana grande ha cambiado tres cosas concretas, y ninguna de ellas es «escribir código más rápido».
Revisiones de código con contexto completo
Antes, una revisión automatizada veía el diff y poco más. Con el proyecto entero en contexto, el modelo detecta que el cambio rompe una suposición en un módulo que nadie ha tocado en dos años, o que duplica una función que ya existía con otro nombre. Es exactamente el tipo de hallazgo que se escapa en una revisión humana con prisas, y la razón por la que una auditoría de código profesional apoyada en IA encuentra cosas distintas a una puramente manual. El criterio sigue siendo humano: el modelo propone, el equipo decide.
Documentación que se mantiene sola
Generar documentación técnica a partir del código era inútil cuando el modelo solo veía fragmentos: salía una descripción literal de cada función, sin explicar por qué existe. Con todo el proyecto en contexto, la documentación resultante es de arquitectura, no de sintaxis. Funciona especialmente bien para incorporar a alguien nuevo o para heredar una plataforma sin documentar, que es un caso frecuente en una auditoría de tienda online heredada.
Migraciones y refactors de alcance amplio
Subir una versión mayor de framework, cambiar una librería de acceso a datos o unificar dos módulos duplicados son tareas donde el riesgo está en lo que no has mirado. Con el repositorio completo en contexto, el inventario de puntos afectados es fiable, y eso cambia la conversación de presupuesto: se puede estimar sobre una lista real en lugar de sobre una intuición.
Lo que no ha cambiado: los agentes de IA en empresa siguen necesitando barreras, revisión y métricas. Y el equipo sigue necesitando las habilidades concretas para trabajar con estas herramientas, que no son las mismas que hace dos años. Si lo que buscas es una comparación cabeza a cabeza con la alternativa de OpenAI, la tenemos en nuestro cara a cara entre Claude Opus y GPT-5 para desarrollo de software.
Impacto en equipos y organizaciones
Para organizaciones que gestionan procesos comerciales complejos, Opus 4.6 abre posibilidades que antes no existían: análisis completo de pipelines de ventas con todo el contexto histórico, generación de informes ejecutivos que integran datos de múltiples fuentes, y automatización de procesos documentales que antes requerían horas de trabajo manual. El modelo es lo suficientemente potente como para ser el motor detrás de agentes empresariales realmente útiles.
Checklist para cambiar de modelo sin sobresaltos
Con un ritmo de cinco versiones en ocho meses, actualizar el modelo ya no es un proyecto: es mantenimiento rutinario. Esta es la lista que seguimos cada vez que sale una versión nueva y hay que decidir si entra en producción.
- Tener un banco de pruebas propio. Veinte o treinta casos reales del negocio con la respuesta esperada, guardados en el repositorio. Las puntuaciones públicas de los benchmarks sirven para orientarse, pero no dicen nada sobre si el modelo clasifica bien tus tickets o extrae bien los campos de tus facturas.
- Medir coste y latencia, no solo calidad. Una versión más capaz que tarda el doble puede empeorar un flujo que responde a un usuario en tiempo real, y mejorar uno que corre de noche. Son decisiones distintas para el mismo modelo.
- Desplegar en paralelo antes de sustituir. Mandar un porcentaje del tráfico al modelo nuevo y comparar resultados en caliente durante unos días cuesta poco y evita descubrir una regresión en la factura o en una queja de cliente.
- Revisar los prompts, no solo el identificador. Las instrucciones afinadas a base de prueba y error para una versión concreta pueden volverse contraproducentes en la siguiente. Los prompts son código: van versionados y se revisan igual.
- Documentar el porqué. Dejar escrito en el repositorio qué modelo se usa en cada flujo y por qué se eligió. Es lo que permite, seis meses después, decidir con criterio en lugar de repetir la elección por inercia.
Riesgos y límites que conviene tener sobre la mesa
- El contexto largo no elimina los errores. Reduce los fallos por fragmentación, pero un modelo puede seguir afirmando con aplomo algo que no está en los documentos. Para cualquier uso con consecuencias —legal, financiero, sanitario— la respuesta necesita cita verificable y revisión humana.
- Gobierno del dato. Pasar el repositorio completo o el histórico de clientes a un servicio externo es una decisión de tratamiento de datos, no una decisión técnica. Hay que saber qué se envía, con qué base legal y qué política de retención aplica el proveedor. Si la empresa está en un proceso de certificación ISO 27001, esto entra directamente en el análisis de riesgos y en el control de proveedores.
- Uso de ordenador y permisos. Que un modelo pueda operar aplicaciones es potente y también es una superficie de ataque nueva. La regla práctica: credenciales dedicadas con el mínimo privilegio, nunca las de un administrador, y registro de todo lo que el agente hace. Encaja en la misma disciplina que describimos en nuestra guía de seguridad informática para pymes.
- Dependencia de proveedor. Un flujo construido alrededor de las peculiaridades de un modelo concreto es un flujo que hay que rehacer en cada salto de versión. Aislar las llamadas detrás de una capa propia cuesta unas horas y ahorra semanas.
- Caducidad del conocimiento del modelo. Todo modelo tiene fecha de corte de entrenamiento. Para preguntas sobre precios, versiones o normativa vigente hace falta búsqueda o recuperación: el modelo por sí solo responderá con lo que era cierto hace meses, con total seguridad en el tono.
Preguntas frecuentes
¿Un millón de tokens significa que puedo dejar de usar RAG?
No. La recuperación sigue siendo más barata y, en corpus grandes, más precisa. La ventana grande sirve para documentos que hay que leer enteros y para dar al modelo el contexto completo de un proyecto, no para sustituir una búsqueda bien hecha.
¿Cuánto cuesta en la práctica usar el contexto completo?
A las tarifas de Opus 5, unos 5 $ por llamada con el millón de tokens de entrada, o 0,50 $ si ese contenido va cacheado. La salida se factura aparte, a 25 $ por millón de tokens.
¿Sigue teniendo sentido leer un artículo sobre Opus 4.6 en 2026?
Para elegir modelo hoy, no: usa la tabla de versiones de más arriba. Para entender qué cambia cuando un modelo ve el proyecto entero —que es el fondo del asunto y no ha cambiado—, sí.
¿Puedo seguir llamando a Opus 4.6 por API?
En el momento de esta actualización la rama 4.x reciente sigue disponible, pero Opus 4, Sonnet 4 y Opus 4.1 ya se han retirado. Conviene comprobar el calendario de deprecación del proveedor antes de fijar un modelo en una integración.
¿El uso de ordenador es fiable para automatizar procesos de negocio?
Para tareas acotadas y repetitivas, con credenciales limitadas y supervisión, sí. Para procesos críticos sin revisión, no: una integración por API o por MCP es más predecible y más fácil de auditar que un agente pulsando botones en una interfaz que puede cambiar de un día para otro.
Conclusión
Opus 4.6 marcó el punto en el que la ventana de contexto dejó de ser el cuello de botella. Ocho meses después, con el millón de tokens convertido en estándar y el precio por token a la baja, el cuello de botella se ha movido de sitio: ya no está en lo que el modelo puede leer, sino en qué merece la pena darle, cuánto cuesta cada llamada y qué controles hay alrededor. Esa es la conversación que tenemos hoy con los equipos con los que trabajamos, y es bastante más útil que comparar números de versión.
¿Quieres aplicar estos modelos a tu plataforma sin romper nada?
En Keliam integramos IA en plataformas que ya están en producción: revisión de código asistida, documentación del legado, automatizaciones con permisos acotados y una capa propia para que un cambio de modelo no obligue a rehacer el flujo.
- Auditoría técnica — estado real del código antes de automatizar nada
- Servicios IT — integración y mantenimiento continuo de la plataforma