El equipo técnico de 2026 necesita nuevas habilidades
La inteligencia artificial no va a sustituir a los desarrolladores, pero los desarrolladores que usan IA van a sustituir a los que no la usan. Esta frase, repetida hasta la saciedad, se ha convertido en realidad en 2026. Los equipos técnicos que dominan estas cinco habilidades entregan más rápido, con menos bugs y con mayor capacidad de abordar proyectos complejos.
Nota de actualización — octubre de 2026: este artículo se publicó en abril y la lista de cinco habilidades sigue siendo la correcta, pero el contexto se ha movido mucho en seis meses. Hemos añadido lo que ha cambiado en los modelos, los datos de los informes sectoriales publicados desde entonces y, sobre todo, el apartado práctico que faltaba: cómo entrena un equipo real estas skills sin parar de entregar.
Conviene empezar por una distinción que se pierde en casi todas las conversaciones sobre IA y desarrollo. Una cosa es usar un asistente de código —hoy lo hace prácticamente todo el mundo— y otra muy distinta es tener un equipo que sabe qué delegar, cómo verificarlo y qué hacer cuando el modelo se equivoca con seguridad aparente. Lo primero es una herramienta. Lo segundo es una capacidad de equipo, y es lo que separa a los que han ganado velocidad real de los que solo han ganado volumen de código que revisar.
Qué ha cambiado entre abril y octubre de 2026
El dato más citado viene del informe de DORA sobre desarrollo asistido por IA: alrededor del 90 % de los profesionales técnicos ya usa IA en su trabajo y más del 80 % cree que le ha subido la productividad. En el mismo estudio, un 30 % declara tener poca o ninguna confianza en el código que genera la IA. Esa contradicción —lo uso todos los días, no me fío de ello— es exactamente el hueco que cubren las cinco habilidades de esta lista.
El hallazgo incómodo del mismo informe es que una mayor adopción de IA se asocia a la vez con más throughput de entrega y con más inestabilidad en producción. La IA amplifica lo que ya tenías: si la base técnica es sólida (plataforma interna decente, tests, APIs claras), acelera; si es frágil, acelera también la deuda técnica. No es una herramienta neutra que se pueda enchufar y esperar a que mejore sola la entrega.
En el lado de los modelos, el salto de estos meses ha sido hacia el trabajo largo y autónomo más que hacia la respuesta brillante de una sola vez. Anthropic publicó Claude Opus 5.5 el 22 de septiembre de 2026, orientado explícitamente a programación agéntica y a sesiones largas, con un precio por millón de tokens que baja de 5 a 4 dólares en entrada y de 25 a 20 en salida respecto a Opus 5. OpenAI ha movido su gama en paralelo con GPT-6 y las variantes de la familia GPT-5.6. Para un equipo técnico lo relevante no es el ranking de la semana, sino que el coste por tarea ha bajado lo suficiente como para que revisar código con IA en cada pull request deje de ser un lujo y pase a ser una línea más del presupuesto de CI.
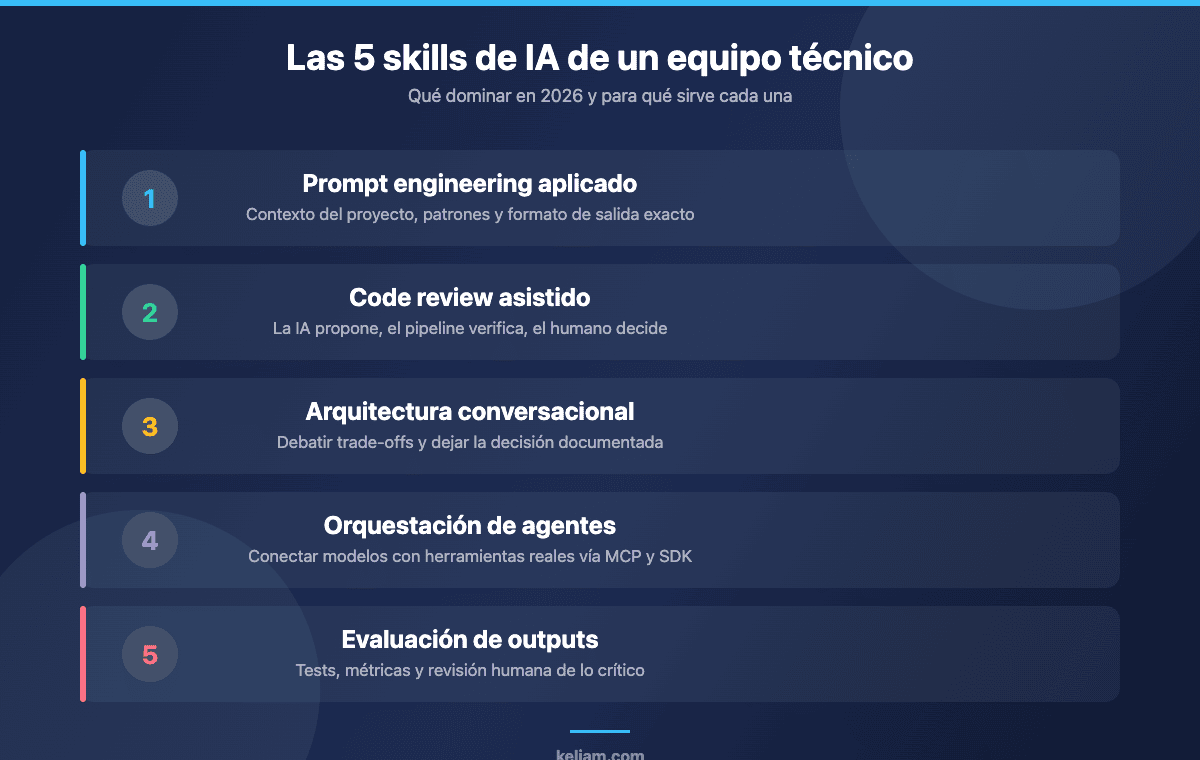
1. Prompt engineering aplicado al desarrollo
No basta con pedir «escribe una función». Los desarrolladores más productivos saben estructurar prompts que incluyen contexto del proyecto, patrones de código existentes, restricciones técnicas y el formato exacto del output esperado. Dominan técnicas como chain of thought, few-shot learning y system prompts específicos tanto para Claude como para GPT.
Esta habilidad se aplica directamente al trabajo con integraciones CRM: un prompt bien diseñado genera código de integración con SuiteCRM API que funciona a la primera, mientras que uno vago produce código que necesita múltiples iteraciones.
Del prompt suelto al contexto del repositorio
La técnica que más ha cambiado en 2026 es dejar de escribir prompts largos y empezar a preparar el contexto una sola vez. Un fichero de instrucciones en la raíz del proyecto —con el stack, las convenciones de nombres, la estructura de carpetas, qué librerías están prohibidas y cómo se escriben los tests— ahorra más tiempo que cualquier plantilla de prompt, porque el modelo lo lee en cada sesión sin que nadie se lo recuerde. Es la diferencia entre explicar el proyecto diez veces al día y explicarlo una vez al mes.
La segunda técnica es dar ejemplos del propio código en lugar de describir el estilo con adjetivos. Pegar dos funciones ya revisadas y pedir «sigue este patrón» produce resultados mucho más consistentes que pedir código «limpio y mantenible», que no significa nada operativo para un modelo. Si quieres profundizar en esto, lo desarrollamos en nuestra guía de prompt engineering para desarrolladores.
Qué pedir y qué no pedir
Un prompt bien planteado delimita el alcance. «Refactoriza este módulo» es una invitación a que el modelo reescriba cosas que funcionaban; «extrae la validación de este método a una función pura, sin tocar la firma pública ni el resto del fichero» es una instrucción verificable. La regla práctica: si no sabes cómo comprobar en treinta segundos que la respuesta es correcta, el prompt está mal acotado.
2. Code review asistido por IA
Claude Code Security ha demostrado que la IA puede encontrar vulnerabilidades que los humanos pasan por alto. Los equipos más avanzados integran revisión de código con IA en su pipeline de CI/CD: cada pull request pasa por un análisis de seguridad con Claude que verifica patrones inseguros, dependencias vulnerables y lógica de negocio inconsistente.
Los datos de 2026 sobre el código que escribe la IA
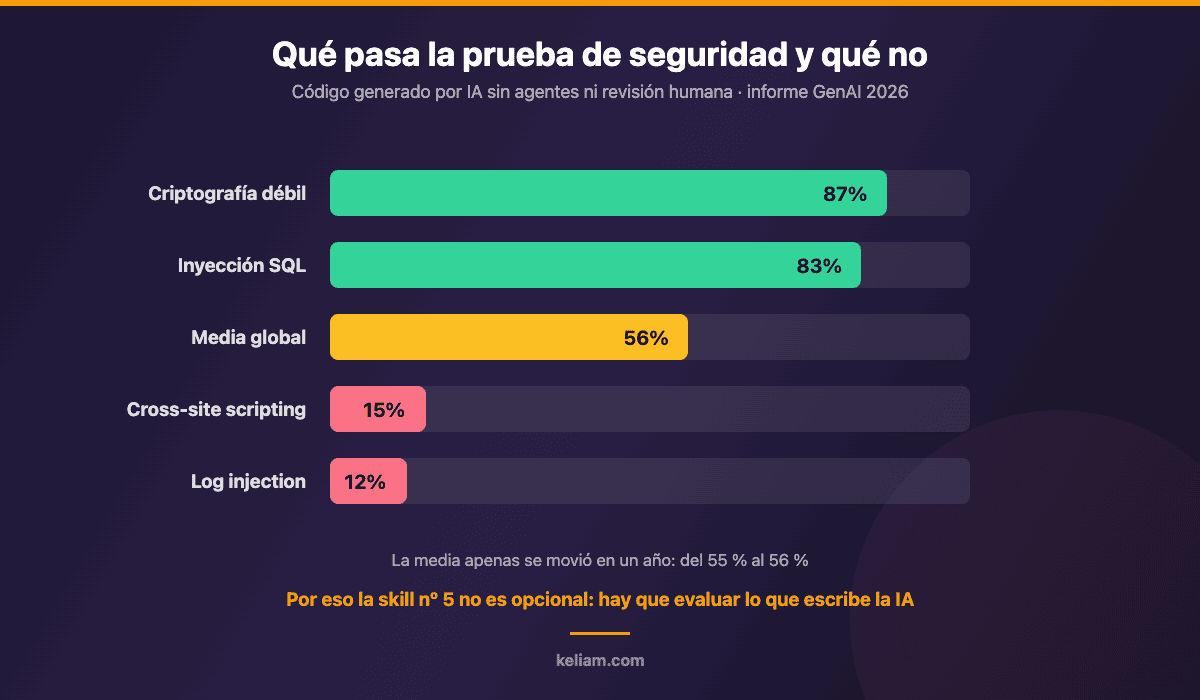
El informe GenAI Code Security de 2026 puso un número a lo que muchos equipos intuían: el código generado por modelos pasa de media el 56 % de las pruebas de seguridad, frente al 55 % de un año antes. Es decir, prácticamente no ha mejorado pese al salto de capacidades generales. El desglose es más útil que la media: la inyección SQL se evita bien (83 %) y la criptografía débil también (87 %), pero el cross-site scripting se cuela en el 85 % de los casos y la inyección en logs en el 88 %. Por lenguaje, Python aprueba el 63 % de las veces y Java solo el 30 %.
Dos matices importantes para no leer mal el dato. El primero es que las pruebas se hacen sobre modelos en crudo, sin agentes, sin guardarraíles y sin revisión humana: mide fallos generados, no fallos que llegan a producción. El segundo es que la diferencia entre modelos es menor de lo que se vende —el mejor de la tanda ronda el 68 %—, así que cambiar de modelo no es una estrategia de seguridad. El pipeline sí lo es.
Dependencias inventadas: el riesgo que casi nadie revisa
Hay un fallo específico del código generado que no aparece en los análisis clásicos: los paquetes que no existen. Un estudio sobre alucinación de paquetes encontró que el 19,7 % de las dependencias recomendadas por modelos de lenguaje no existían, con una diferencia enorme entre modelos abiertos (21,7 % de media) y propietarios (5,2 %), y más de 205.000 nombres de paquete inventados distintos. El riesgo es evidente: basta que alguien registre uno de esos nombres para que el siguiente desarrollador que copie la sugerencia instale código ajeno. La práctica se ha bautizado como slopsquatting y, aunque a mediados de 2026 no se había documentado ningún ataque real con esta técnica, un paquete vacío publicado como prueba con un nombre alucinado acumuló más de 30.000 descargas en tres meses.
La defensa no es dejar de usar IA, es tener control sobre las dependencias y la cadena de suministro: lockfiles, allowlist de paquetes, y una comprobación automática de que cada import nuevo existe y tiene historial. Es una regla de pipeline, no de disciplina individual.
Cómo se integra de verdad en el pipeline
El patrón que funciona en los equipos que hemos visto es el de tres capas: análisis estático de siempre, revisión con IA que comenta el pull request antes de que lo mire un humano, y revisión humana centrada en lo que la IA no puede juzgar (si la decisión de negocio es correcta). Lo que no funciona es poner a la IA a aprobar merges. El informe de DORA lo plantea igual: la recomendación no es sustituir la revisión, es reordenarla para que el feedback llegue al autor antes de ocupar el tiempo de un revisor. Nosotros lo aplicamos cuando hacemos auditoría de código sobre proyectos heredados, donde la IA sirve para barrer volumen y el criterio humano para decidir qué merece arreglarse.
Una señal de que esto empieza a dar resultados medibles: según el testimonio de Deloitte recogido por Anthropic al presentar Opus 5.5, el modelo detectó el 72 % de los bugs conocidos en sus revisiones de código incluso en su configuración de menor esfuerzo, frente al 56 % que lograba la generación anterior trabajando a fondo. La lectura correcta de ese número no es «ya no hace falta revisar», sino que el coste de poner una revisión automática antes de la humana ha caído mucho. Profundizamos en el enfoque en nuestro artículo sobre detección de vulnerabilidades con razonamiento semántico.
3. Arquitectura conversacional
Diseñar la arquitectura de un sistema conversando con un modelo de IA es una skill en sí misma. Los mejores arquitectos de 2026 usan Claude o GPT como sparring partner: presentan requisitos, discuten trade-offs, evalúan alternativas y documentan decisiones, todo en una conversación estructurada que además genera la documentación técnica del proyecto.
Cómo es una sesión de arquitectura útil
Una conversación de arquitectura que sirve tiene una estructura reconocible: contexto y restricciones reales primero (volumen de datos, presupuesto, equipo disponible, plazos), después dos o tres alternativas explícitas, luego los trade-offs de cada una y, al final, una decisión escrita con su motivo. Lo que convierte esto en una skill es la disciplina de no aceptar la primera propuesta: pedir al modelo que defienda la alternativa que ha descartado suele sacar a la luz supuestos que nadie había verbalizado.
El subproducto más valioso es la documentación. Si la conversación está bien llevada, el registro de decisiones sale casi solo, y eso resuelve el problema clásico de que nadie recuerde seis meses después por qué se eligió una cola de mensajes en lugar de llamadas síncronas. Es el mismo principio que aplicamos al generar documentación funcional de proyectos con ayuda de IA.
Dónde no debe entrar
Hay decisiones que no se delegan ni se consultan: las que dependen de información que el modelo no tiene. Cuánto aguanta tu infraestructura actual, qué parte del equipo sabe mantener qué, qué cliente tolera una ventana de mantenimiento y cuál no. Un modelo que no conoce esos límites propondrá siempre la arquitectura de libro, que suele ser más compleja de lo que la organización puede sostener.
4. Automatización de workflows con agentes
Saber conectar modelos de IA con herramientas externas es fundamental. Ya sea usando Claude Agent SDK para construir agentes personalizados, configurando workflows en n8n que incluyen nodos de IA, o integrando GPT via API con sistemas de gestión comercial, la capacidad de orquestar IA + herramientas multiplica el impacto del equipo.
El estándar que ha ordenado el panorama
La pieza que faltaba para que los agentes dejaran de ser demos era un modo estándar de conectarlos con herramientas reales. Eso es lo que ha venido a cubrir el Model Context Protocol, que en 2026 se ha consolidado como la forma habitual de exponer una base de datos, un CRM o un sistema interno a un modelo sin escribir una integración distinta para cada proveedor. Lo explicamos en detalle en nuestro artículo sobre el protocolo MCP para integrar herramientas con IA.
Para un equipo técnico esto cambia la pregunta. Antes era «qué modelo uso»; ahora es «qué herramientas internas expongo, con qué permisos y con qué trazas». La skill consiste en diseñar ese perímetro: un agente con acceso de lectura a producción y de escritura a un entorno de pruebas es útil; el mismo agente con credenciales de administrador es un incidente esperando a ocurrir.
Empezar por el flujo aburrido
Los agentes que sobreviven al primer mes no son los ambiciosos. Son los que automatizan algo repetitivo y acotado: clasificar incidencias entrantes, preparar el borrador de una release note, cruzar un export con una tabla y avisar de las diferencias. Hemos recogido varios de estos casos en agentes de IA en empresa: casos reales, y el patrón se repite: valor claro, alcance pequeño, error reversible.
5. Evaluación y testing de outputs de IA
La skill más subestimada: saber evaluar críticamente lo que produce la IA. Los modelos generan código que parece correcto pero puede contener errores sutiles, sesgos o ineficiencias. Los equipos maduros implementan frameworks de evaluación que incluyen tests automatizados del código generado, benchmarks de calidad de contenido, métricas de precisión para tareas de clasificación y revisión humana de decisiones críticas.
Qué evaluar y con qué
Evaluar outputs de IA no es una actividad nueva ni exótica: es testing con otro nombre y con un matiz. El matiz es que el código generado falla de forma distinta al escrito a mano. Un humano cansado comete errores evidentes; un modelo produce código plausible, bien formateado y con nombres razonables que, sin embargo, ignora un caso límite o repite una consulta dentro de un bucle. Por eso la revisión superficial engaña: todo parece bien escrito.
El mínimo razonable para un equipo son cuatro comprobaciones. Tests automáticos sobre el comportamiento, no sobre la implementación. Un escaneo de seguridad que incluya las clases donde los modelos fallan más —cross-site scripting e inyección en logs a la cabeza, según los datos del apartado anterior—. Una comprobación de rendimiento en los puntos calientes. Y revisión humana obligatoria en lo que toque dinero, datos personales o permisos. Lo desarrollamos a fondo en cómo usar IA en testing y QA.
Medir el impacto, no el volumen
El error de medición más extendido es contar líneas de código o pull requests. Con IA, ese número sube siempre, y no dice nada. Las recomendaciones del informe de DORA van en la dirección contraria: medir tiempo de ciclo, estabilidad en producción, esfuerzo percibido por el equipo y valor entregado. Si la IA está funcionando, el tiempo desde que algo se pide hasta que está en producción baja sin que suban los incidentes. Si solo sube el volumen de código, lo que has comprado es trabajo de revisión.
Cómo desarrollar estas skills en tu equipo
Aquí es donde la mayoría de los equipos se atascan: todo el mundo está de acuerdo en que hay que aprender esto y nadie tiene una hora libre. La forma que mejor nos ha funcionado, tanto internamente como con clientes, es tratar las skills como se trata cualquier otra competencia técnica —con tiempo asignado, un responsable y una revisión— en lugar de esperar a que surjan solas.
Un plan de 90 días que no para la entrega
Semanas 1 a 3: base común. Una persona prepara el fichero de contexto del repositorio principal y lo revisa el equipo. Nadie aprende prompting en abstracto: se aprende sobre el proyecto real. Al final de estas semanas, cualquiera del equipo debería poder abrir una sesión con el asistente y obtener código que respete las convenciones sin explicarlas.
Semanas 4 a 6: revisión asistida. Se activa la revisión automática en los pull requests de un solo repositorio, el que tenga mejor cobertura de tests. El objetivo de estas semanas no es cazar bugs, es calibrar: ver cuántos comentarios del asistente son útiles, cuántos son ruido y ajustar el umbral antes de extenderlo a todo.
Semanas 7 a 9: un agente pequeño. Se elige un flujo repetitivo y sin riesgo, se construye, se mide el tiempo que ahorra y se decide si se queda. Un agente que no se puede justificar con un número a las tres semanas se apaga sin drama.
Semanas 10 a 12: evaluación y cierre. Se revisa qué ha cambiado en tiempo de ciclo y en incidentes, se documentan las prácticas que han cuajado y se decide qué se extiende al resto de repositorios. Es también el momento de revisar si alguna práctica choca con los controles de seguridad que tengáis que cumplir; si trabajáis con un marco formal, conviene mirarlo junto a lo que exige la certificación ISO 27001 en materia de desarrollo seguro.
Reparto de responsabilidades
Una advertencia que recoge el informe de DORA y que coincide con lo que vemos: hay que proteger el desarrollo de los perfiles junior. Un junior que delega en la IA desde el primer día aprende a pedir código, no a escribirlo ni a juzgarlo, y eso se nota a los dos años. La contrapartida razonable es emparejarlos con seniors que revisen con ellos las decisiones de diseño que propone el modelo, y mantener deliberadamente a mano alguna parte compleja. Si estáis incorporando gente, esto también cambia cómo se entrevista: lo tratamos en cómo evaluar desarrolladores.
Cinco errores habituales al introducir IA en un equipo técnico
1. Comprar licencias y llamarlo estrategia. Repartir accesos sin cambiar ni un proceso produce mucha actividad y ningún resultado medible. La herramienta es la parte barata.
2. Medir por volumen. Si el indicador de éxito es cuánto código se escribe, el equipo optimizará para escribir más código. Es el incentivo equivocado.
3. Dejar la seguridad para el final. Con los porcentajes de arriba sobre la mesa, meter código generado en un pipeline sin escaneo específico es asumir una deuda que se paga en incidentes.
4. Dar a un agente más permisos de los que necesita. La automatización que escribe en producción el primer día es la que acaba en un postmortem. Empezar en lectura y ampliar con pruebas.
5. Esperar a tener la herramienta perfecta. Los modelos cambian cada pocas semanas; las prácticas de equipo, no. Lo que se aprende sobre cómo acotar una tarea o cómo verificar una salida sigue sirviendo con el modelo siguiente.
Cómo saber si las skills están calando
Cuatro señales prácticas, sin cuadros de mando complicados. La primera: en las revisiones de código se discuten decisiones de diseño, no erratas, porque las erratas ya las ha filtrado el pipeline. La segunda: cuando alguien pega una respuesta de un modelo en un canal del equipo, la acompaña de cómo la ha comprobado. La tercera: los agentes que están en marcha tienen dueño y se apagan los que no aportan. Y la cuarta, la más difícil: el equipo es capaz de decir que no a usar IA en una tarea concreta y argumentar por qué. Ese no razonado es la prueba de madurez.
¿Quieres meter IA en tu equipo técnico sin romper nada?
En Keliam ayudamos a equipos de desarrollo a incorporar IA donde aporta y a blindar lo que toca: revisión de código, dependencias, pipeline y mantenimiento. Sin discursos, con un plan medible.
- Servicios IT — acompañamiento técnico y refuerzo de equipo
- Auditoría Técnica — estado real del código, las dependencias y el pipeline
- Auditoría de Seguridad y Pentesting — lo que un escaneo automático no ve
- Mantenimiento de Software — soporte continuo sobre lo que ya está en producción
Preguntas frecuentes
¿Hace falta que todo el equipo domine las cinco skills?
No. Lo razonable es que todos tengan la primera y la quinta —saber pedir y saber verificar— y que las otras tres se repartan. La arquitectura conversacional encaja con perfiles senior, la orquestación de agentes con quien lleve integraciones, y la revisión asistida es una práctica de equipo más que una habilidad individual.
¿Qué modelo conviene usar en 2026?
Depende de la tarea, y la respuesta cambia cada pocos meses. Para sesiones largas de refactor o migración, los modelos orientados a trabajo agéntico rinden mejor; para consultas rápidas, uno más barato y pequeño es suficiente. Lo que no recomendamos es atar todo el flujo de trabajo a un único proveedor sin capa de abstracción. Tenemos una comparativa de plataformas de IA para empresas con los criterios de elección.
¿Es seguro usar código generado por IA en producción?
Lo es en la medida en que tu pipeline lo verifique. Los datos de 2026 dicen que el código generado en crudo supera de media el 56 % de las pruebas de seguridad, con clases concretas donde falla casi siempre. Con escaneo automático, tests y revisión humana en lo crítico, el riesgo es manejable; sin eso, no.
¿Cuánto tarda un equipo en notar la diferencia?
Entre seis y doce semanas para ver efectos medibles en tiempo de ciclo, si se asigna tiempo explícito. El error típico es esperar resultados en la primera semana y abandonar en la tercera, justo antes de que las prácticas empiecen a cuajar.
¿Esto sustituye a contratar desarrolladores?
No, y los datos de entrega apuntan en contra: más adopción de IA se asocia también a más inestabilidad cuando la base técnica es débil. Lo que cambia es el perfil que conviene incorporar: menos ejecución pura y más criterio para juzgar lo que produce la máquina.
¿Por dónde empieza una empresa pequeña, sin equipo de plataforma?
Por el fichero de contexto del repositorio y por la revisión automática en un solo proyecto. Son las dos cosas que dan resultado sin infraestructura propia. Lo demás puede esperar. Si además manejáis datos sensibles, merece la pena revisar antes los fundamentos de seguridad informática para pymes.
Conclusión
Las cinco habilidades de esta lista no han cambiado desde abril, pero el motivo para desarrollarlas sí. Hace seis meses el argumento era la velocidad; hoy es el control. Casi todos los equipos ya usan IA, una parte importante no se fía del resultado y los informes muestran que la adopción sin fundamentos sólidos empeora la estabilidad en lugar de mejorarla. La ventaja competitiva ya no está en usar la herramienta: está en saber qué delegarle, cómo comprobar lo que devuelve y cuándo decirle que no.
Si quieres ver cómo se traduce esto a casos concretos de una agencia de desarrollo, puedes seguir por diez usos de IA en una agencia de desarrollo o por nuestro trabajo de prototipado con IA aplicado a proyectos reales.