Cuando una empresa pierde datos, casi nunca es porque no tuviera copias de seguridad. Es porque tenía copias que nadie había restaurado nunca, porque el ransomware cifró también el disco de backup conectado por red, o porque la única copia válida tenía once días y el negocio no podía permitirse perder once minutos. La diferencia entre «hacemos backups» y «tenemos una estrategia de continuidad» se mide exactamente el día del incidente, cuando ya es tarde para arreglarla.
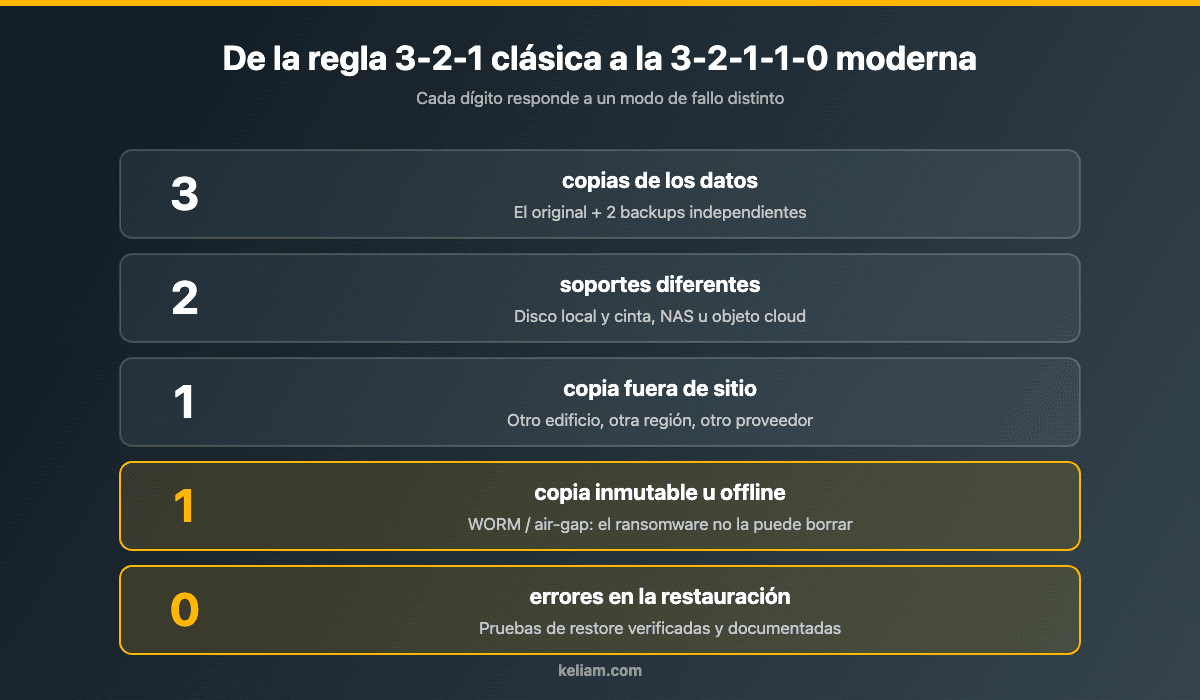
La regla 3-2-1 lleva más de dos décadas siendo la referencia del sector: tres copias de los datos, en dos soportes distintos, con una fuera de las instalaciones. Sigue siendo un excelente punto de partida, pero nació en un mundo sin ransomware profesionalizado, sin SaaS crítico y sin infraestructura efímera. Hoy hace falta una versión ampliada —la estrategia 3-2-1-1-0— que añade la copia inmutable y, sobre todo, la obligación de verificar que las restauraciones funcionan de verdad.
En esta guía repasamos cómo diseñar una política de copias de seguridad empresarial que resista un incidente real: qué significa cada dígito, cómo fijar el RPO y el RTO antes de elegir herramienta, qué hay que copiar además de la base de datos, cómo implementar inmutabilidad sin comprar una cabina de gama alta y cómo montar un calendario de pruebas de restauración que no dependa de la buena voluntad de nadie. Está escrita desde el punto de vista de quien tiene que defender el presupuesto ante dirección y, al mismo tiempo, ejecutar la restauración a las tres de la madrugada.
1. Por qué la regla 3-2-1 sigue vigente (y por qué ya no basta)
La formulación clásica es sencilla de recordar y esa es su gran virtud: 3 copias de los datos, en 2 tipos de soporte diferentes, con 1 copia fuera de la ubicación principal. Cada número responde a un modo de fallo concreto. Tener tres copias protege del borrado accidental y de la corrupción silenciosa. Usar dos soportes distintos protege del fallo sistemático de una tecnología: si los discos de un mismo lote fallan a la vez, la cinta o el almacenamiento de objetos sobrevive. Sacar una copia del edificio protege del incendio, la inundación y el robo.
1.1 Lo que la regla resolvía en su momento
La 3-2-1 se popularizó en un contexto donde el enemigo principal era el fallo de hardware y el desastre físico. Bajo esa premisa funciona muy bien: son eventos independientes, poco correlacionados entre sí, y multiplicar copias reduce la probabilidad conjunta de pérdida a números despreciables. Si tu única preocupación es que se queme un servidor, tres copias en dos soportes con una fuera bastan de sobra.
1.2 Qué ha cambiado: el atacante también busca tus backups
El problema es que el ransomware moderno no es un evento aleatorio, es un adversario con objetivos. Los grupos actuales pasan días o semanas dentro de la red antes de cifrar nada, y durante ese tiempo hacen exactamente lo que haría cualquier atacante competente: localizar el sistema de copias, robar credenciales de administración del backup, borrar los puntos de restauración y solo entonces lanzar el cifrado. Si tus tres copias están accesibles con las mismas credenciales de dominio, no tienes tres copias: tienes una copia replicada tres veces. Lo explicamos en detalle en el artículo sobre cómo funciona el ransomware y cómo protegerse, donde el borrado previo de las copias aparece como fase estándar del ataque.
A esto se suman dos cambios estructurales. El primero es el SaaS: buena parte de la información crítica de una empresa vive hoy en Microsoft 365, Google Workspace, un CRM en la nube o un repositorio de código, y la mayoría de esos servicios ofrecen papelera y retención limitada, no copia de seguridad en el sentido empresarial. El segundo es la infraestructura efímera: contenedores, autoescalado e infraestructura como código han hecho que el estado relevante esté repartido entre volúmenes persistentes, secretos, configuraciones y pipelines, y no en un único servidor que se copia entero.
2. La estrategia moderna: 3-2-1-1-0
La versión actualizada conserva los tres primeros dígitos y añade dos que responden justamente a lo anterior: un 1 adicional para la copia inmutable u offline, y un 0 para los errores en las pruebas de restauración. No es una moda de fabricante: es la traducción directa de lo que falla en los incidentes reales.
2.1 El cuarto dígito: una copia inmutable u offline
Inmutable significa que, una vez escrita, la copia no puede modificarse ni borrarse hasta que expire su periodo de retención, ni siquiera por un administrador. Offline o air-gapped significa que el soporte no es alcanzable desde la red en el momento del ataque. Cualquiera de las dos propiedades rompe la cadena del atacante: por muchas credenciales que tenga, no puede destruir lo que el propio sistema de almacenamiento se niega a borrar.
Este es el control que separa a las empresas que recuperan en horas de las que acaban negociando un rescate. Y, a diferencia de lo que mucha gente asume, no exige una inversión desproporcionada: las opciones razonables van desde el bloqueo de objetos en almacenamiento compatible con S3 hasta instantáneas ZFS o Btrfs en un equipo aislado con credenciales propias.
2.2 El quinto dígito: cero errores en la verificación
El cero es el más incómodo de los cinco porque obliga a trabajar de forma continuada. Significa que las copias se verifican automáticamente —checksums, comprobación de consistencia de la base de datos— y que, además, se ejecutan restauraciones reales de forma periódica con resultado documentado. Una copia que nunca se ha restaurado es una hipótesis, no un respaldo.
Auditando infraestructuras, este es el punto que más veces aparece incumplido: el software de backup marca todos los trabajos en verde durante meses mientras la copia de la base de datos se toma en caliente sin bloqueo consistente y resulta irrestaurable. El verde del panel mide que el trabajo terminó, no que el dato sirva.
3. Antes de elegir herramienta: fija tu RPO y tu RTO
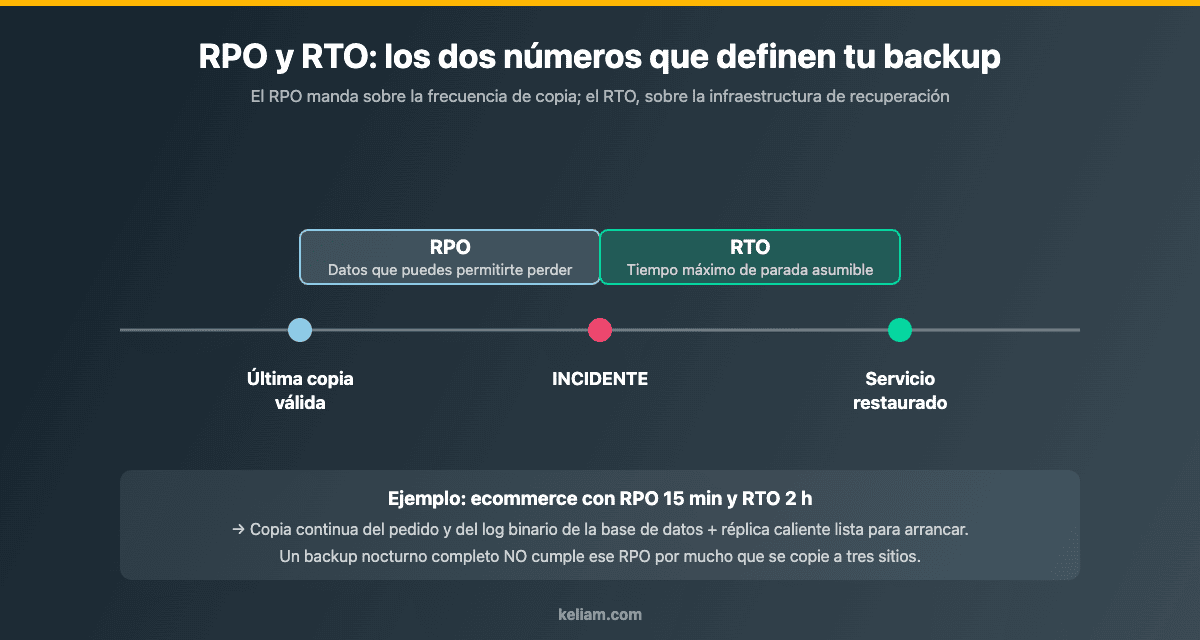
La conversación sobre copias de seguridad casi siempre empieza mal, porque empieza por el producto. La pregunta correcta no es «qué software de backup compramos», sino «cuántos datos podemos permitirnos perder y cuánto tiempo podemos estar parados». Esas dos respuestas son el RPO (Recovery Point Objective) y el RTO (Recovery Time Objective), y de ellas se deduce casi todo lo demás: la frecuencia de copia, la tecnología, la retención y el presupuesto.
3.1 Cómo se calculan sin caer en el «cero y ya»
Si preguntas a un responsable de negocio cuántos datos puede perder, la respuesta espontánea es «ninguno». El ejercicio útil consiste en traducir cada ventana a dinero y a trabajo manual: si perdemos las últimas cuatro horas de pedidos, ¿cuántos son?, ¿se pueden reconstruir desde la pasarela de pago?, ¿cuánta gente hace falta para reintroducirlos y durante cuántos días? Cuando el RPO se expresa así, aparecen números realistas y muy distintos por sistema.
Con el RTO ocurre lo mismo. Una parada de ocho horas en la intranet documental es molesta; ocho horas en la tienda online en plena campaña son una cifra concreta de facturación perdida, y merece la pena hacer ese cálculo antes de una campaña de temporada alta, igual que se hace al dimensionar la arquitectura de una plataforma de negocio. El RTO no mide cuánto tarda en copiarse un fichero: mide cuánto tarda el servicio en volver a dar respuesta útil al usuario, e incluye detectar, decidir, restaurar, validar y reabrir.
3.2 Niveles de servicio por sistema, no uno global
Aplicar el mismo RPO y RTO a toda la infraestructura es caro e innecesario. Lo razonable es definir tres o cuatro niveles y asignar cada sistema a uno:
- Crítico (transacciones, facturación, producción): RPO de minutos, RTO de horas. Requiere replicación o archivado continuo del log de transacciones, además del backup tradicional.
- Importante (CRM, ERP, intranet, correo): RPO de horas, RTO de un día. Copia diaria con retención amplia.
- Estándar (documentación, entornos internos): RPO de un día, RTO de varios días.
- Reproducible (entornos de prueba, artefactos regenerables): puede no necesitar copia si el pipeline los reconstruye, siempre que el pipeline sí esté respaldado.
Documentar esta clasificación tiene además un beneficio de cumplimiento: es exactamente lo que piden marcos como el ENS o la ISO 27001, que tratamos en la guía de controles técnicos de ISO 27001 y en el capítulo de medidas de protección del ENS.
4. Qué hay que copiar de verdad: el inventario que casi nadie hace
Muchas políticas de copia se diseñaron alrededor de «la base de datos y la carpeta de ficheros» y ahí se quedaron. El resultado es una restauración que devuelve los datos pero no el servicio, porque falta todo lo que lo rodea.
4.1 Bases de datos: consistencia por encima de todo
Copiar los ficheros del directorio de datos de MySQL o PostgreSQL con el motor arrancado y sin coordinación produce una copia probablemente corrupta. Las opciones válidas son el volcado lógico (mysqldump, pg_dump) para volúmenes moderados, las herramientas de copia física en caliente del propio motor, o las instantáneas a nivel de almacenamiento coordinadas con el bloqueo del motor. Para RPO bajos, además, hay que archivar el registro binario o el WAL: es lo que permite recuperar hasta un punto en el tiempo concreto —justo antes del borrado accidental— y no solo hasta la última copia completa.
4.2 Ficheros, uploads y contenido generado por el usuario
En un ecommerce o en un WordPress, las imágenes de producto, los adjuntos y los documentos subidos pesan mucho más que la base de datos y cambian constantemente. Conviene separarlos en su propio trabajo de copia, con deduplicación e incrementales, para no arrastrar cientos de gigabytes cada noche. También conviene decidir explícitamente qué NO se copia: cachés, miniaturas regenerables y ficheros temporales solo engordan la ventana de backup.
4.3 Configuración, secretos e infraestructura
Configuración del servidor web, reglas de firewall, certificados, tareas programadas, definiciones de contenedores, variables de entorno y credenciales de servicios externos. Lo ideal es que todo esto viva en un repositorio versionado —infraestructura como código— y que el repositorio esté respaldado, porque entonces la restauración de la plataforma es reproducible en vez de artesanal. Los secretos merecen tratamiento aparte: no deben acabar en claro dentro de la copia, pero tampoco pueden ser lo único que falte el día de la restauración. En el artículo sobre ciberseguridad de servidores con poco presupuesto detallamos cómo ordenar esta parte sin herramientas caras.
4.4 SaaS: lo que el proveedor no te está guardando
Microsoft 365, Google Workspace, los repositorios de código y la mayoría de CRM en la nube funcionan bajo un modelo de responsabilidad compartida: el proveedor garantiza la disponibilidad del servicio, no la recuperación de tus datos frente a un borrado malicioso, una desactivación de cuenta o un error de sincronización pasados los plazos de papelera. Si un buzón se vacía y se detecta dos meses después, la retención por defecto puede no llegar. Existen soluciones específicas de copia para SaaS y merece la pena evaluarlas al menos para correo, ficheros compartidos y código fuente.
5. Tipos de copia y política de retención
Con el inventario y los objetivos claros, la elección técnica se simplifica. Hay tres modalidades básicas y una forma estándar de combinarlas.
5.1 Completa, incremental y diferencial
La copia completa lo copia todo: restauración rápida y sencilla, coste alto en tiempo y espacio. La incremental copia solo lo cambiado desde la copia anterior: muy eficiente, pero la restauración necesita la cadena entera y un eslabón corrupto la rompe. La diferencial copia lo cambiado desde la última completa: crece más que la incremental, pero para restaurar solo hacen falta dos piezas. Los sistemas modernos suelen usar incrementales permanentes con consolidación sintética, que dan lo mejor de ambos mundos a cambio de depender más del software.
5.2 Retención tipo GFS y por qué importa contra el ransomware
El esquema abuelo-padre-hijo (GFS) mantiene copias diarias durante unas semanas, semanales durante unos meses y mensuales o anuales durante años. Frente al ransomware su valor es evidente: si el cifrado o la corrupción se detecta 40 días después —algo habitual cuando el atacante corrompe datos poco a poco—, las diarias ya han rotado, y solo una retención larga permite volver a un estado limpio. La retención no es un capricho de cumplimiento; es la única defensa contra los incidentes que se descubren tarde.
6. Inmutabilidad en la práctica, sin gastar una fortuna
Implementar el cuarto dígito es más asequible de lo que parece. Estas son las vías habituales, ordenadas de menor a mayor complejidad:
- Bloqueo de objetos en almacenamiento S3 compatible: modo compliance o governance con retención definida. Ni una clave robada puede borrar el objeto antes de su vencimiento. Es la opción más directa para la copia externa.
- Instantáneas en ZFS o Btrfs sobre un servidor de backup dedicado, con acceso por una cuenta que no sea la del dominio y con las instantáneas gestionadas localmente. El atacante que compromete el servidor de producción no tiene por qué llegar ahí.
- Repositorios endurecidos con sistema operativo separado, SSH sin acceso de root y el servicio de backup escribiendo con permisos mínimos.
- Cinta o disco extraíble rotado: el air gap más barato y el más ignorado. Para muchas pymes, una rotación semanal de discos guardados fuera del edificio cubre el peor escenario por muy poco dinero.
Sea cual sea la vía, hay dos reglas duras. La primera: el sistema de copias no debe autenticarse contra el mismo directorio que el resto de la infraestructura, porque entonces comprometer el dominio es comprometer el backup. La segunda: el flujo debe ser de empuje desde el origen al repositorio o de extracción desde el repositorio, pero nunca un recurso compartido montado permanentemente en el servidor de producción con permisos de escritura y borrado.
¿Tus copias de seguridad aguantarían un ransomware el lunes que viene?
En Keliam revisamos la estrategia de backup completa: consistencia de las copias, aislamiento del repositorio, retención, cifrado y —sobre todo— una prueba de restauración real con tiempos medidos. Te entregamos el informe con los riesgos priorizados y el plan para cerrarlos.
7. Cifrado y gestión de claves
Una copia fuera de sitio es una copia de todos tus datos en un lugar que no controlas físicamente. Debe ir cifrada, y el cifrado debe ser en origen, antes de salir de tu infraestructura, de forma que el proveedor de almacenamiento nunca vea el contenido en claro. Hasta aquí casi todo el mundo está de acuerdo.
Donde fallan muchas implantaciones es en la gestión de la clave. Guardarla únicamente en el servidor que se copia significa que, si ese servidor arde o queda cifrado, tienes un archivo perfectamente protegido e inútil. Guardarla en un documento compartido de la intranet significa que el atacante que entra en la intranet también se la lleva. Lo correcto es custodiarla en un gestor de secretos con control de acceso propio, más una copia de emergencia en sobre sellado o caja fuerte, con procedimiento de apertura documentado y al menos dos personas capaces de ejecutarlo. Sobre este punto y sobre la rotación de credenciales conviene revisar también nuestras recomendaciones generales de seguridad informática para pymes desde cero.
8. Pruebas de restauración: el dígito que nadie quiere hacer
Si solo puedes implementar una cosa de todo este artículo, que sea esta. Las pruebas de restauración convierten una suposición en una certeza y, de paso, descubren la mitad de los problemas de la política de copias antes de que importen.
8.1 Tres niveles de prueba
- Verificación automática (continua): checksums, montaje automático de la imagen y arranque en un entorno aislado, comprobación de integridad de la base de datos. Muchas suites lo hacen solas si se configura; el problema es que casi nunca se configura.
- Restauración granular (mensual): recuperar un fichero concreto, un buzón o una tabla, cronometrando el proceso. Es el caso más frecuente en la vida real: alguien borró algo.
- Simulacro completo (semestral o anual): levantar el servicio crítico entero en infraestructura alternativa a partir solo de las copias, sin tocar producción, y medir el RTO real de punta a punta. Casi siempre duplica o triplica la estimación teórica la primera vez.
8.2 El runbook de recuperación
La prueba debe ejecutarse siguiendo un documento escrito, no la memoria del administrador que lleva ocho años en la empresa. Ese runbook incluye el orden de restauración de los sistemas y sus dependencias, dónde están las claves, quién decide activar el plan, cómo se comunica a clientes y empleados, cómo se valida que el servicio está correcto antes de reabrir y a quién se notifica. Debe existir en papel o en un sistema independiente: un plan de recuperación almacenado únicamente en la intranet cifrada por el ataque no sirve de nada.
Cada prueba termina con un acta breve: fecha, alcance, tiempos medidos, incidencias y acciones correctivas con responsable y plazo. Esa acta es, además, la evidencia que pedirá cualquier auditoría de certificación ISO 27001 y la que exige la directiva NIS2 a las empresas afectadas.
9. Errores habituales que seguimos encontrando
- El disco de backup montado en el servidor. Si el servidor de producción puede escribir y borrar en el destino, el ransomware también. Es el fallo más común y el más caro.
- Credenciales compartidas con el dominio. Comprometer el Active Directory no debería implicar comprometer las copias.
- Copiar la base de datos sin consistencia. Trabajos en verde durante meses y un volcado que no importa.
- Retención demasiado corta. Catorce días no cubren un incidente detectado a los treinta.
- Olvidar el SaaS. El correo y el repositorio suelen ser los grandes ausentes del inventario.
- No medir el RTO real. Restaurar cuatro terabytes por un enlace de 200 Mbps son horas, y esas horas rara vez están en el plan.
- Documentación no disponible durante el incidente. El runbook dentro del sistema caído.
- Nadie mira las alertas. Los fallos de backup deben escalar como incidencias, no llegar a un buzón que nadie lee.
10. Cuánto cuesta y cómo defenderlo ante dirección
El presupuesto de copias se aprueba cuando se presenta como seguro y no como gasto técnico. La cuenta es sencilla y solo necesita tres cifras que ya deberías tener del ejercicio de RPO y RTO: el coste por hora de parada del sistema crítico, el coste de reconstruir manualmente la ventana de datos perdida y el coste de un incidente completo con pérdida definitiva —que incluye la operativa, pero también las obligaciones de notificación, las sanciones potenciales y el daño reputacional.
Frente a eso, el coste de una estrategia sólida para una pyme suele ser sorprendentemente contenido: almacenamiento de objetos con bloqueo para la copia externa, un servidor de backup dedicado con discos y un contrato de revisión y pruebas. La forma más eficaz de cerrar la conversación es enseñar el resultado del primer simulacro: cuando dirección ve que restaurar el ERP lleva veintidós horas y no las cuatro que todo el mundo daba por hechas, la decisión se toma sola. Si quieres partir de un diagnóstico ordenado, nuestra auditoría técnica incluye precisamente esa medición, y en la guía sobre por dónde empezar en ciberseguridad empresarial encuadramos el backup dentro del resto de prioridades.
11. Plan de implantación en 30, 60 y 90 días
11.1 Primeros 30 días: saber qué tienes
Inventario de sistemas y datos con su clasificación de criticidad; RPO y RTO acordados con negocio y firmados; revisión de la configuración actual de copias, con especial atención a permisos del destino y consistencia de las bases de datos; y una primera restauración granular de prueba. Solo con esto suelen aparecer dos o tres riesgos graves.
11.2 Días 30 a 60: cerrar los agujeros grandes
Separar credenciales del repositorio de copias, implementar la copia inmutable u offline para los sistemas críticos, ajustar la retención al esquema GFS, activar el archivado del log de transacciones donde el RPO lo exija y cifrar en origen con custodia de claves documentada.
11.3 Días 60 a 90: convertirlo en proceso
Escribir el runbook de recuperación, ejecutar el primer simulacro completo midiendo el RTO real, ajustar la política con lo aprendido, configurar alertas que escalen como incidencia y fijar el calendario de pruebas del año siguiente con responsables asignados. A partir de ahí, la estrategia deja de ser un proyecto y pasa a ser una rutina, que es exactamente lo que debe ser.
12. Preguntas frecuentes
¿La replicación o el RAID sustituyen al backup?
No. El RAID protege del fallo de un disco y la replicación protege de la caída de un nodo, pero ambos propagan inmediatamente un borrado o un cifrado. Son mecanismos de alta disponibilidad, no de recuperación: resuelven problemas distintos y se complementan con el backup, no lo reemplazan.
¿Basta con las instantáneas del proveedor cloud?
Ayudan mucho para el RTO, pero suelen vivir en la misma cuenta y bajo las mismas credenciales que la infraestructura. Si la cuenta se compromete o se cierra por un impago o un error administrativo, se van con ella. Deben complementarse con al menos una copia en otra cuenta, otra región u otro proveedor.
¿Cada cuánto hay que probar la restauración?
Verificación automática continua, restauración granular mensual y simulacro completo al menos una vez al año —dos si el negocio depende críticamente de la plataforma o si ha habido cambios de arquitectura relevantes.
¿Cuánto tiempo hay que guardar las copias?
Depende del riesgo y de la normativa aplicable, pero un punto de partida razonable es: diarias 30 días, semanales 3 meses, mensuales 12 meses y anuales según las obligaciones fiscales o sectoriales. Lo importante es que la retención larga sea inmutable.
Conclusión
La regla 3-2-1 sigue siendo el esqueleto correcto de cualquier política de copias, pero hoy solo funciona si se le añaden los dos dígitos que faltaban: una copia que el atacante no pueda borrar y la certeza, verificada con periodicidad, de que las restauraciones funcionan. Todo lo demás —la elección de producto, el tipo de incremental, el proveedor de almacenamiento— son detalles de implementación que se resuelven solos una vez están claros el RPO, el RTO y el inventario de lo que realmente hay que copiar.
El mejor momento para descubrir que tu backup no sirve es un martes por la tarde, en un simulacro, con todo el mundo tranquilo y producción funcionando. El peor es a las tres de la madrugada con la empresa parada. La diferencia entre los dos escenarios no es presupuesto: es haber dedicado unas horas a probarlo.
Si quieres una revisión independiente de tu estrategia de copias —consistencia, aislamiento, retención, cifrado y una prueba de restauración cronometrada—, cuéntanos tu caso y te decimos en qué punto estás realmente.