Cuando una aplicación web empieza a ir lenta, la reacción habitual es mirar el frontend: optimizar imágenes, revisar el JavaScript, añadir caché. Pero en la mayoría de proyectos que auditamos, el verdadero cuello de botella está una capa más abajo: la base de datos. Queries que tardan segundos en vez de milisegundos, índices que nadie revisó desde el lanzamiento, tablas que crecieron veinte veces desde que se diseñó el esquema y una configuración de MySQL que sigue siendo la de fábrica. La aplicación no «va lenta»: está esperando a la base de datos.
Una auditoría de base de datos es el proceso sistemático de revisar índices, queries, esquema y configuración para encontrar exactamente dónde se pierde el tiempo y qué riesgos estructurales acumula el sistema. No es magia ni intuición: es medir con las herramientas adecuadas (slow query log, EXPLAIN, Performance Schema), interpretar los datos y priorizar las correcciones por impacto. La diferencia entre una base de datos auditada y una abandonada se nota en todo: tiempos de respuesta, coste de infraestructura, estabilidad en picos de tráfico y capacidad de escalar sin reescribirlo todo.
En esta guía explicamos cómo hacemos una auditoría de base de datos MySQL/MariaDB en proyectos reales: qué se revisa, con qué herramientas, cómo se interpretan los resultados y qué entregables debería exigir cualquier CTO o responsable técnico que contrate una. Si tu plataforma lleva años en producción y nadie ha mirado la base de datos desde entonces, es casi seguro que aquí hay rendimiento —y dinero— sobre la mesa.
1. Por qué la base de datos es el cuello de botella invisible
Hay una asimetría curiosa en cómo envejecen las aplicaciones web. El código de aplicación se toca constantemente: se despliegan features, se corrigen bugs, se refactoriza. La base de datos, en cambio, solo recibe migraciones incrementales — una columna aquí, una tabla allá — y casi nunca una revisión de conjunto. El esquema que se diseñó para 10.000 registros sigue operando con 10 millones, y las decisiones que entonces eran irrelevantes ahora dominan el rendimiento.
El problema es que la degradación es gradual e invisible. Una query sin índice sobre una tabla de 50.000 filas tarda 40 ms: nadie lo nota. La misma query sobre 5 millones de filas tarda 4 segundos y satura CPU e I/O, arrastrando a todas las demás. Como el deterioro llega poco a poco, el equipo se acostumbra («la web siempre ha ido así») hasta que un pico de tráfico o una campaña lo convierte en caída. Es el mismo patrón de deuda acumulada que vemos en las auditorías técnicas de software: lo que no se mide, se degrada en silencio.
Además, el impacto de la base de datos es multiplicativo. Un endpoint que ejecuta 30 queries de 50 ms no tarda 50 ms: tarda 1,5 segundos. Los ORMs modernos (Eloquent, Doctrine, el propio WordPress) facilitan mucho generar decenas de queries por petición sin que nadie lo vea en el código. Por eso una auditoría de base de datos no mira solo el servidor MySQL: mira el diálogo completo entre aplicación y base de datos.
2. Qué revisa una auditoría de base de datos: las 5 áreas
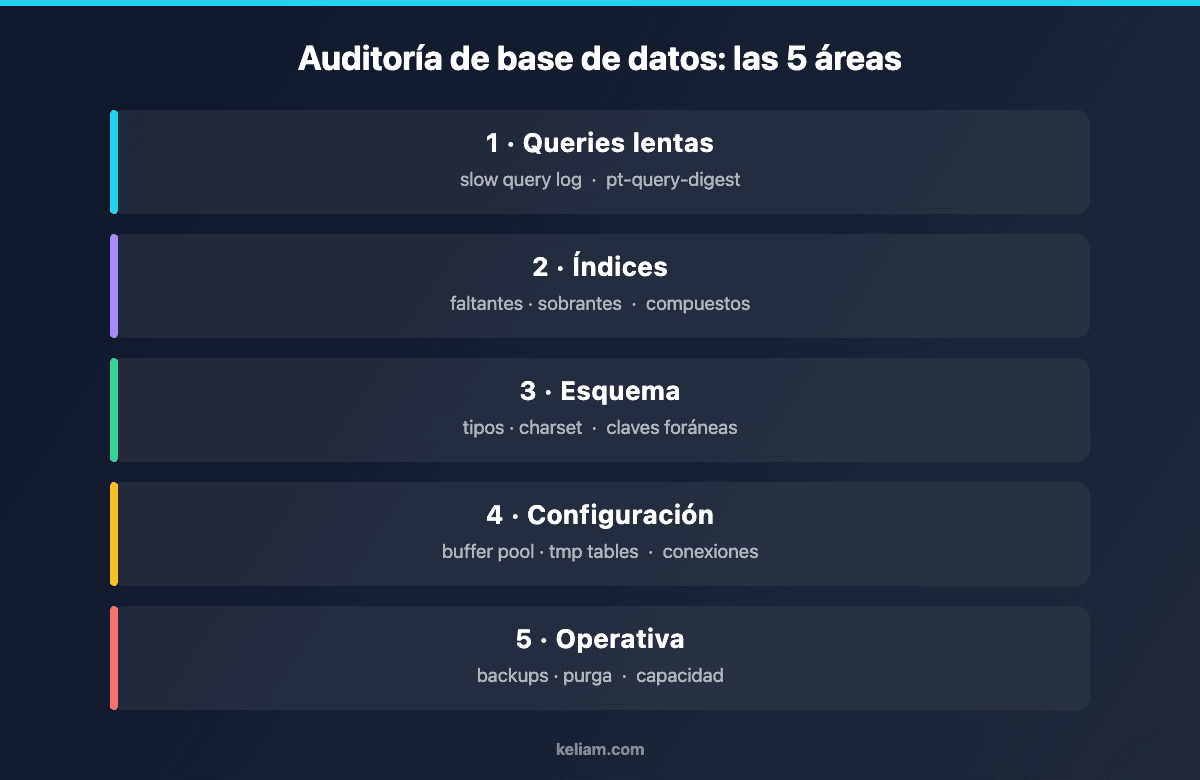
Nuestro proceso cubre cinco áreas, cada una con sus herramientas y sus hallazgos típicos:
- Queries lentas: captura y análisis del slow query log para identificar qué consultas consumen más tiempo agregado, no solo las más lentas individualmente.
- Índices: los que faltan (queries con full table scan), los que sobran (duplicados, no usados, que penalizan escrituras) y los mal diseñados (orden de columnas incorrecto en índices compuestos).
- Esquema: tipos de datos, charset y collation, claves foráneas, normalización o desnormalización según el caso de uso, y tablas problemáticas por diseño (EAV, metadatos clave-valor).
- Configuración del servidor: buffer pool, tablas temporales, conexiones, durabilidad — la configuración por defecto de MySQL no está pensada para tu carga.
- Operativa: backups y su verificación, replicación, crecimiento de tablas, purga de datos históricos y plan de capacidad.
El orden importa: empezamos siempre por las queries lentas porque son la evidencia empírica de dónde duele. Auditar índices o configuración sin datos de carga real es teorizar; con el slow query log delante, cada recomendación tiene un impacto medible detrás.
3. Slow query log: capturar la realidad antes de opinar
3.1 Activar la captura sin miedo
El slow query log es el punto de partida de cualquier auditoría seria. Registra cada consulta que supera un umbral de tiempo, con su duración, filas examinadas y filas devueltas. En producción lo activamos con un umbral inicial de 1 segundo y lo vamos bajando (0,5 s, 0,2 s) según el volumen que genere:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 'OFF'; -- activar solo en ventanas cortas
SET GLOBAL slow_query_log_file = '/var/log/mysql/slow.log';
El overhead de registrar queries lentas es despreciable comparado con el coste de las propias queries lentas. La opción log_queries_not_using_indexes es útil pero ruidosa: la activamos solo en ventanas de captura controladas, porque registra también queries triviales sobre tablas pequeñas donde un full scan es correcto.
Importante: capturar durante un periodo representativo. Un log de dos horas un martes por la mañana no refleja el batch nocturno de sincronización con el ERP ni el pico del viernes. Como mínimo, una semana completa de captura antes de sacar conclusiones.
3.2 Agregar con pt-query-digest: el 80/20 de las queries
El log en bruto es inmanejable — decenas de miles de entradas. La herramienta estándar para agregarlo es pt-query-digest (Percona Toolkit), que normaliza las queries (sustituye valores por comodines), las agrupa y las ordena por tiempo total consumido:
pt-query-digest /var/log/mysql/slow.log > digest-semana.txtEl resultado casi siempre confirma la regla del 80/20: entre 3 y 10 patrones de query concentran la gran mayoría del tiempo de base de datos. Y aquí está el matiz que separa una auditoría útil de una superficial: la query más dañina rara vez es la más lenta. Una consulta de 400 ms que se ejecuta 50.000 veces al día pesa mucho más que el informe de 30 segundos que se lanza una vez por la noche. pt-query-digest ordena por tiempo agregado precisamente por eso.
Con la lista priorizada, cada patrón de query pasa a la siguiente fase: entender por qué es lento con EXPLAIN.
4. EXPLAIN: leer el plan de ejecución
4.1 Qué mirar en un EXPLAIN
Ante cada query lenta, EXPLAIN (o mejor, EXPLAIN ANALYZE en MySQL 8, que ejecuta la query y muestra tiempos reales por etapa) revela cómo el optimizador la resuelve. Los campos clave:
- type: el tipo de acceso.
ALLsignifica full table scan — la señal de alarma clásica sobre tablas grandes.indexrecorre el índice entero (mejor, pero no bueno).range,refyeq_refson los que queremos ver. - rows: estimación de filas examinadas. Una query que examina 2 millones de filas para devolver 20 tiene un problema de índice o de diseño.
- Extra: aquí aparecen los avisos serios:
Using filesort(ordenación fuera del índice),Using temporary(tabla temporal, a menudo en disco) y sus combinaciones. - key y key_len: qué índice se usa y cuántos bytes del índice se aprovechan — esencial para detectar índices compuestos que solo se usan a medias.
4.2 Los patrones que más veces encontramos
Tras años de auditorías, los sospechosos habituales se repiten: funciones sobre columnas indexadas (WHERE DATE(created_at) = '2026-08-04' invalida el índice; se reescribe como rango), SELECT * arrastrando columnas TEXT/BLOB que impiden usar índices covering, ORDER BY ... LIMIT con offsets gigantes en paginaciones (la página 4.000 examina 200.000 filas para devolver 50), JOINs sobre columnas con distinto tipo o collation (conversión implícita = índice inutilizado), y el clásico N+1 del ORM: una query por cada elemento de una lista, invisible en el código y devastador en producción.
Cada uno tiene una corrección concreta y verificable: se reescribe la query o se crea el índice, se vuelve a ejecutar EXPLAIN ANALYZE, y se compara el antes y el después con números. Ese rigor es el mismo que aplicamos en la auditoría de rendimiento web: sin medición previa y posterior, no hay optimización, hay fe.
5. Índices: los que faltan, los que sobran y los mal diseñados
5.1 Detectar índices que faltan
Los índices ausentes se detectan cruzando dos fuentes: los full table scans del slow query log y las vistas de sys schema, que MySQL alimenta con estadísticas reales de uso:
-- Full scans por tabla, ordenados por latencia acumulada
SELECT * FROM sys.schema_tables_with_full_table_scans;

-- Sugerencias directas del propio servidor
SELECT * FROM sys.statements_with_full_table_scans;
La decisión de crear un índice nunca es automática. Cada índice acelera las lecturas que lo usan y penaliza todas las escrituras sobre la tabla (cada INSERT/UPDATE debe mantenerlo). En tablas con mucha escritura — colas, logs, pedidos en horas punta — añadir índices alegremente degrada el sistema por el otro lado.
5.2 Detectar índices que sobran
Igual de frecuente es lo contrario: índices duplicados (un índice sobre (customer_id) cuando ya existe (customer_id, status), que lo cubre como prefijo) e índices que ninguna query usa desde hace meses:
-- Índices redundantes
SELECT * FROM sys.schema_redundant_indexes;

-- Índices sin uso desde el último reinicio
SELECT * FROM sys.schema_unused_indexes;
En una auditoría reciente sobre una tienda con ocho años de historia encontramos 23 índices redundantes acumulados por migraciones y plugins: espacio en disco, RAM de buffer pool y coste de escritura pagados a cambio de nada.
5.3 Índices compuestos: el orden lo es todo
El error conceptual más repetido: creer que un índice sobre (a, b, c) sirve para filtrar por b o por c. Un índice compuesto funciona como una guía telefónica ordenada por apellido y luego nombre: sirve para buscar por apellido, o por apellido y nombre, pero es inútil para buscar solo por nombre. La regla práctica: columnas de igualdad primero, la columna de rango o de ordenación al final. Diseñar bien un índice compuesto puede sustituir a tres índices simples y habilitar covering indexes donde la query entera se responde desde el índice sin tocar la tabla.
6. Auditoría del esquema: los cimientos
Con las queries e índices revisados, la auditoría sube un nivel: ¿el esquema ayuda o estorba? Lo que revisamos:
- Tipos de datos: BIGINT donde bastaría INT, VARCHAR(255) por costumbre en columnas de 20 caracteres, DATETIME almacenados como VARCHAR (adiós índices por rango), decimales monetarios en FLOAT (errores de redondeo además de rendimiento).
- Charset y collation: mezclas de
utf8,utf8mb4y collations distintas entre tablas que se joinean — cada mezcla es una conversión implícita que anula índices. El estándar hoy esutf8mb4con una collation única y consciente. - Claves foráneas e integridad: proyectos enteros sin una sola FK, con huérfanos acumulados que rompen informes y migraciones. La integridad referencial no es opcional en datos de negocio.
- Tablas clave-valor y EAV: el patrón Entity-Attribute-Value da flexibilidad al coste de queries con JOINs múltiples sobre tablas gigantes. Es el talón de Aquiles clásico de los CMS y plataformas ecommerce.
- Datos que nunca se purgan: logs, sesiones, carritos abandonados, revisiones — tablas que solo crecen y que nadie consulta más allá de 90 días, ocupando buffer pool y alargando backups.
Aquí las recomendaciones son más estructurales que las de índices: cambiar un tipo de columna en una tabla de 40 millones de filas requiere estrategia de migración (herramientas como pt-online-schema-change o gh-ost para hacerlo sin downtime), y eso forma parte del plan de acción que entrega la auditoría.
7. Configuración del servidor: MySQL de fábrica no es MySQL para ti
La configuración por defecto de MySQL es deliberadamente conservadora. En servidores con 16 o 32 GB de RAM seguimos encontrando innodb_buffer_pool_size en valores mínimos: la base de datos leyendo de disco lo que debería servir desde memoria. Los parámetros que más impacto tienen en la práctica:
innodb_buffer_pool_size: la caché principal de datos e índices. La referencia clásica es el 60-75% de la RAM en un servidor dedicado a MySQL. Es el parámetro individual más importante.innodb_flush_log_at_trx_commitysync_binlog: el equilibrio entre durabilidad estricta y rendimiento de escritura. Cambiarlos exige entender qué se está sacrificando — forma parte del informe, no de un tuning a ciegas.tmp_table_size/max_heap_table_size: cuando las tablas temporales no caben en memoria, van a disco. El contadorCreated_tmp_disk_tablesdelata el problema.max_connectionsy pooling: subir conexiones máximas no arregla nada si cada conexión está esperando a queries lentas; solo agranda la cola. Primero las queries, luego el pooling (ProxySQL, pooling persistente del framework), y solo entonces el límite.
Herramientas como MySQLTuner o los advisors de Percona Monitoring and Management (PMM) dan una primera foto automatizada, pero sus recomendaciones hay que filtrarlas con criterio: sugieren en función de contadores globales, sin saber si tu carga es un ecommerce con picos o un backoffice plano.
¿Tu plataforma va lenta y sospechas de la base de datos?
En Keliam auditamos bases de datos MySQL/MariaDB en producción: slow query log, índices, esquema y configuración, con un plan de acción priorizado por impacto y sin downtime. Y si quieres, lo ejecutamos contigo.
8. Casos especiales: ecommerce y CMS
8.1 WordPress y WooCommerce: el peso de los metadatos
En WordPress casi todo el dolor de base de datos vive en dos tablas: wp_postmeta y wp_options. La primera es un EAV puro donde cada producto de WooCommerce puede generar decenas de filas de metadatos; con catálogos grandes alcanza millones de registros y las queries de filtrado se arrastran. La segunda acumula opciones con autoload activo que se cargan en cada petición: hemos visto instalaciones cargando 12 MB de opciones por página vista. Precisamente para sacar los pedidos de ese modelo nació HPOS, que analizamos en detalle en nuestra guía de WooCommerce HPOS: tablas dedicadas para pedidos en lugar de posts y metadatos.
8.2 Magento y los catálogos grandes
Magento lleva el modelo EAV a su máxima expresión: un producto se reparte entre decenas de tablas por tipo de atributo. Funciona gracias a sus tablas de índices planos, y por eso una auditoría en Magento presta atención especial al estado de los indexers, los cron que los reconstruyen y el dimensionamiento de MySQL para soportarlos. Lo tratamos a fondo en la guía de optimización de Magento 2 para catálogos grandes.
8.3 APIs y backends a medida
En backends a medida el patrón dominante es el N+1 del ORM y los endpoints de listado sin límite de página. Un endpoint público que permite ?per_page=10000 es a la vez un problema de rendimiento y un vector de denegación de servicio — la frontera entre auditoría de rendimiento y auditoría de seguridad de APIs es más fina de lo que parece.
9. Herramientas: el kit de la auditoría
Resumen del arsenal que usamos, todo open source o incluido en MySQL:
- Slow query log +
pt-query-digest: captura y priorización de queries por tiempo agregado. EXPLAIN ANALYZE: diagnóstico del plan de ejecución con tiempos reales por etapa (MySQL 8+).sysschema y Performance Schema: índices no usados, redundantes, full scans, tablas temporales en disco, todo con datos de uso real.- Percona Toolkit: además del digest,
pt-online-schema-changepara alterar tablas grandes sin downtime ypt-duplicate-key-checkerpara índices duplicados. - MySQLTuner: revisión rápida de configuración con recomendaciones a validar.
- PMM (Percona Monitoring and Management): monitorización continua con Query Analytics — lo que convierte la auditoría puntual en vigilancia permanente.
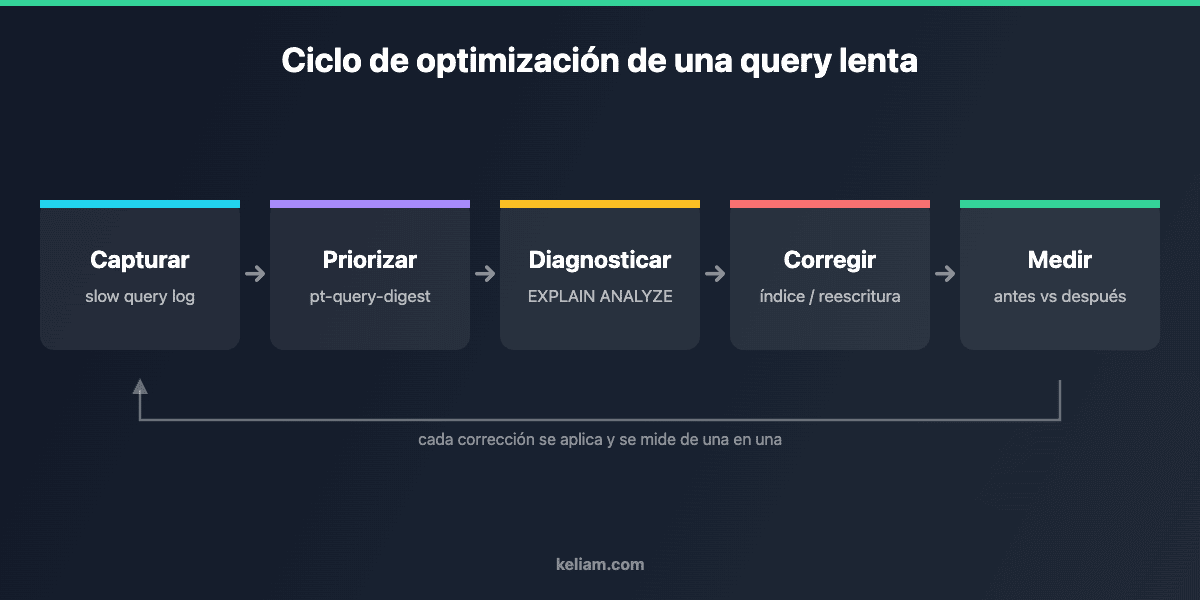
La herramienta importa menos que el método: capturar datos reales, priorizar por impacto agregado, corregir una cosa cada vez y medir el resultado. Una auditoría que entrega un PDF de recomendaciones genéricas de MySQLTuner no es una auditoría: es un formulario.
10. Entregables: qué debe darte una auditoría de base de datos
Si contratas una auditoría de base de datos, esto es lo mínimo exigible como entrega:
- Informe ejecutivo (2-3 páginas): estado general, riesgos principales y ganancias estimadas, en lenguaje de negocio.
- Top de queries problemáticas con su coste agregado, diagnóstico EXPLAIN y corrección propuesta para cada una.
- Plan de índices: índices a crear, a eliminar y a rediseñar, con el impacto esperado en lecturas y el coste en escrituras.
- Hallazgos de esquema clasificados por severidad, con estrategia de migración para los cambios estructurales (online schema change cuando aplique).
- Configuración recomendada del servidor, parámetro a parámetro, con la justificación de cada cambio y su riesgo.
- Plan de acción priorizado: quick wins de la primera semana, mejoras de medio plazo y cambios estructurales, cada uno con esfuerzo estimado.
Y una advertencia de método: los cambios se aplican de uno en uno y midiendo. Aplicar veinte recomendaciones un viernes por la tarde convierte cualquier mejora — o regresión — en imposible de atribuir.
Conclusión
La base de datos es el componente de tu plataforma que más rendimiento esconde y el que menos atención recibe. Una auditoría seria no consiste en ejecutar un script y entregar el resultado: consiste en capturar la carga real con el slow query log, priorizar con pt-query-digest, diagnosticar con EXPLAIN, revisar índices y esquema con datos de uso — no con opiniones — y entregar un plan priorizado que el equipo pueda ejecutar sin sustos.
La buena noticia es que el retorno suele ser inmediato y medible: en la mayoría de auditorías, los quick wins de la primera semana (tres o cuatro índices bien diseñados, dos queries reescritas, buffer pool dimensionado) recortan los tiempos de respuesta de forma visible para el usuario final y liberan capacidad de servidor que estabas a punto de pagar en hardware. Pocas inversiones técnicas tienen un payback tan corto.
Preguntas frecuentes
¿Cada cuánto conviene auditar la base de datos?
Como revisión completa, una vez al año o tras cambios de escala relevantes (duplicar catálogo, migrar de versión, campañas que multiplican tráfico). Entre auditorías, la monitorización continua (PMM, Query Analytics) detecta las regresiones cuando aparecen, no cuando duelen.
¿La auditoría requiere parar producción?
No. La captura (slow query log, Performance Schema) tiene overhead mínimo y el análisis se hace fuera. Las correcciones estructurales sobre tablas grandes se aplican con herramientas de online schema change, sin ventana de mantenimiento en la mayoría de casos.
¿Aplica esto a PostgreSQL o solo a MySQL?
El método es idéntico — capturar, priorizar, diagnosticar, corregir, medir —; cambian las herramientas (pg_stat_statements en lugar del slow query log, EXPLAIN (ANALYZE, BUFFERS), auto_explain). Los patrones de problema (índices ausentes, N+1, configuración de fábrica) son los mismos.
¿Y si mi hosting es gestionado (RDS, cloud)?
Cambia el acceso a la configuración (parameter groups en RDS) pero no el fondo: queries, índices y esquema siguen siendo responsabilidad tuya, y es donde está la mayor parte de la ganancia. De hecho, en cloud cada query lenta se paga dos veces: en experiencia de usuario y en factura.