Durante años, la seguridad del código se ha revisado con herramientas que buscan firmas: patrones de texto que, cuando aparecen, suelen indicar un problema. Funcionan, son rápidas y caben en cualquier pipeline. Pero tienen un techo evidente: solo encuentran lo que alguien escribió antes en una regla. El fallo que nace de la interacción entre dos funciones correctas, o de una comprobación de permisos que existe en cuatro rutas de ejecución y falta en la quinta, no deja firma.
Ese es exactamente el hueco que intenta cubrir una nueva generación de herramientas que no comparan texto, sino que razonan sobre lo que el código hace. Este artículo repasa qué es Claude Code Security, qué encontró en su primera prueba a gran escala, en qué se diferencia del comando /security-review que cualquiera puede usar hoy, qué límites tiene documentados y cómo lo encajamos en un flujo de trabajo real sin convertirlo en un riesgo nuevo.
Claude Code Security: cuando la IA entiende las vulnerabilidades
En febrero de 2026, Anthropic lanzó Claude Code Security, una herramienta de análisis de vulnerabilidades que funciona de forma radicalmente diferente a los escáneres de seguridad tradicionales. Mientras que herramientas como Snyk o SonarQube buscan patrones conocidos, Claude Code Security razona semánticamente sobre el código, entendiendo la intención detrás de cada función y detectando vulnerabilidades lógicas que las herramientas basadas en reglas no pueden encontrar.
Qué cambió exactamente en febrero de 2026
Anthropic presentó la herramienta el 20 de febrero de 2026, y lo hizo en research preview limitada: no como producto general, sino con acceso restringido a clientes de los planes Enterprise y Team, más una vía acelerada y gratuita para mantenedores de proyectos open source. Es un matiz importante, porque buena parte de la cobertura que se leyó esas semanas daba a entender que cualquiera podía enchufarla a su repositorio, y no era el caso.
El motor detrás del análisis fue Claude Opus 4.6, el modelo con ventana de contexto ampliada que permite sostener en memoria módulos enteros en lugar de archivos sueltos. Esa capacidad es justo lo que separa a esta familia de herramientas del análisis estático clásico: para seguir un dato desde el formulario donde entra hasta la consulta donde acaba, hay que poder mirar varios archivos a la vez.
El resultado no se entrega como un listado plano. Cada hallazgo pasa por una verificación multietapa destinada a descartar falsos positivos y sale con dos etiquetas: un nivel de severidad y un nivel de confianza. La primera dice cuánto duele si alguien lo explota; la segunda, cuánto se fía el propio sistema de haber entendido bien el código. Un equipo con poco tiempo empieza por los críticos de alta confianza y deja el resto para una segunda pasada.
Lo que no es: el comando que ya tienes desde 2025
Hay dos cosas distintas con nombres parecidos y conviene no mezclarlas. El comando /security-review existe en Claude Code desde agosto de 2025 y está disponible para cualquier usuario de plan de pago: hace una pasada de reconocimiento sobre las clases de vulnerabilidad habituales (inyección SQL, XSS, fallos de autenticación y autorización, validación y saneado de datos, dependencias con CVE conocidos).
Claude Code Security es el producto de análisis profundo que llegó después, con el objetivo de encontrar lo que no está en ninguna lista. Si en tu equipo alguien dice «ya usamos Claude para revisar seguridad», merece la pena aclarar cuál de los dos, porque las expectativas razonables son muy distintas.
Más de 500 vulnerabilidades descubiertas en código open source
La prueba de fuego fue contundente: el equipo Red Team de Anthropic usó Claude Code Security para analizar repositorios de código abierto en producción y encontró más de 500 vulnerabilidades que habían pasado desapercibidas a revisiones humanas y a herramientas de análisis estático convencionales. Esto incluye vulnerabilidades de inyección SQL en ORMs que parecían seguros, race conditions en código concurrente que solo se manifestaban bajo carga específica, y fugas de información en manejo de errores que exponían datos internos del sistema.
Qué proyectos se analizaron
Los tres casos que Anthropic hizo públicos son reveladores por lo poco glamurosos que son: GhostScript (el intérprete de PostScript y PDF que hay detrás de media industria de la impresión y de infinitos conversores de documentos), OpenSC (la biblioteca que habla con tarjetas inteligentes y tokens criptográficos, incluidos los de firma electrónica) y CGIF (una librería pequeña para generar ficheros GIF).
Ninguno de los tres es un producto comercial con un equipo de seguridad detrás. Son piezas de infraestructura mantenidas en gran medida por voluntarios, incrustadas en sistemas corporativos y en servicios críticos, y que llevaban años sometidas a revisión humana y a millones de horas de fuzzing. Que aún quedara material ahí dice menos del descuido de sus mantenedores que del tipo de fallo que las técnicas tradicionales no alcanzan.
Esto conecta con un problema del que se habla poco en las auditorías: el inventario. Casi ninguna organización sabe de verdad qué librerías de terceros arrastra su aplicación, en qué versión y quién las mantiene. Antes de preocuparte por si una IA puede auditar tu código, conviene saber de qué código estamos hablando: es uno de los primeros puntos de cualquier auditoría técnica seria.
La letra pequeña de la cifra
La cifra de 500 impresiona y conviene leerla con cuidado, porque la propia comunidad de seguridad puso objeciones desde el primer momento. Anthropic no publicó tasa de falsos positivos, ni cuántos de los parches sugeridos acabaron realmente integrados en los proyectos afectados. Varios investigadores señalaron que no todos los hallazgos etiquetados como de alta severidad lo eran en la práctica.
Justin Cappos, profesor de la Universidad de Nueva York y uno de los que recibe este tipo de reportes, lo resumió sin rodeos: junto a los hallazgos buenos llega bastante ruido, con falsos positivos y sugerencias impracticables en un entorno de desarrollo real. Es un coste que recae sobre el mantenedor, que tiene que triar cada reporte aunque no haya pedido ninguno.
La lectura razonable no es «no sirve», sino «no sustituye». La herramienta encuentra cosas que nadie había encontrado, y a la vez genera trabajo de verificación que alguien tiene que hacer. Cualquier plan de adopción que no reserve horas de persona para ese triaje está incompleto.
Razonamiento semántico vs. pattern matching
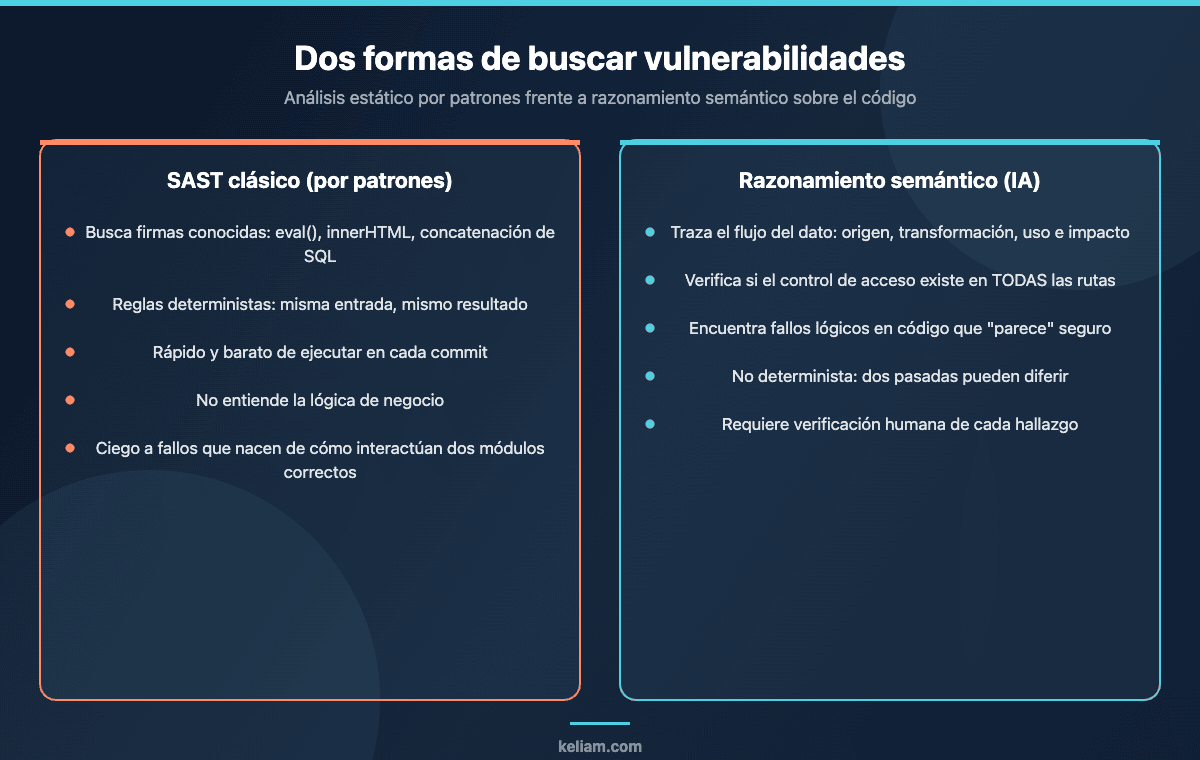
La diferencia fundamental es el enfoque. Un escáner tradicional busca patrones como eval() o innerHTML y los marca como potencialmente peligrosos. Claude Code Security entiende el flujo de datos completo: de dónde viene el input, cómo se transforma, dónde se usa y qué impacto tendría si fuera malicioso. Esto permite detectar vulnerabilidades en código que «parece» seguro porque sigue las mejores prácticas superficialmente pero tiene fallos en la lógica de negocio.
Qué encuentra uno y no el otro
En la práctica, los dos enfoques fallan en sitios distintos y por eso se complementan bien. Un escáner por patrones es imbatible para lo mecánico: dependencias con CVE publicado, secretos commiteados por error, usos de funciones desaconsejadas, configuraciones por defecto peligrosas. Lo hace en segundos, cuesta casi nada y da el mismo resultado siempre.
El razonamiento semántico aporta en el territorio opuesto: fallos de autorización en los que el endpoint comprueba que el usuario está autenticado pero no que el recurso sea suyo; condiciones de carrera que solo aparecen con cierta concurrencia; validaciones que se hacen en el cliente y se asumen en el servidor; y el clásico de los sistemas de gestión, un filtro por organización o por empresa que se aplica en el listado y se olvida en el detalle.
Es el mismo salto conceptual que ya hemos descrito al hablar de IA aplicada a testing y QA: pasar de comprobar que el código cumple una regla a comprobar que el código hace lo que se espera que haga. Y, como allí, el resultado no es un semáforo verde, es una lista de cosas que mirar.
El problema del no determinismo
Hay una limitación que rara vez aparece en los titulares y que decide si puedes usar esto en un entorno regulado: los resultados no son deterministas. Dos pasadas sobre el mismo commit pueden devolver conjuntos de hallazgos distintos. Para un equipo que quiere orientación, eso es tolerable. Para un programa de cumplimiento que necesita evidencias reproducibles y auditables, es un problema de fondo.
La forma práctica de convivir con ello es no usar la revisión por IA como control formal, sino como detección adicional: el control auditable sigue siendo el escáner determinista más la revisión humana documentada, y la IA se añade encima para ampliar cobertura. Si te mueves en un marco como los controles técnicos de ISO 27001, esa distinción entre control y herramienta de apoyo te ahorra una conversación incómoda con el auditor.
La otra limitación documentada es de alcance: ni este producto ni el comando ejecutan la aplicación. No hay pruebas en tiempo de ejecución, así que los fallos que solo se manifiestan con el sistema en marcha —abusos de lógica de negocio, autorización a nivel de objeto y de función— siguen necesitando pruebas ofensivas contra el entorno real. Tampoco siguen bien el flujo de autorización cuando cruza la frontera entre microservicios.
Lo que sí puedes usar hoy: /security-review y la GitHub Action
Mientras el producto grande sigue en preview, hay dos piezas accesibles para cualquier equipo con un plan de pago de Claude Code, y con ellas se cubre buena parte del valor práctico.
Desde la terminal
La primera es el propio comando. Se actualiza el cliente con claude update y se ejecuta /security-review sobre el directorio o el archivo que interese. Devuelve los hallazgos agrupados por severidad, con la explicación de por qué cada uno es un problema y una propuesta de corrección. El flujo natural es revisarlo, descartar lo que no aplica y aplicar a mano lo que sí.
Conviene acotar el alcance. Lanzarlo contra el repositorio entero en un proyecto grande produce un informe que nadie va a leer; lanzarlo contra el módulo que acabas de tocar produce algo accionable en la misma sesión. Es la misma disciplina que recomendamos al trabajar con cualquier asistente de código: contexto pequeño y pregunta concreta funcionan mejor que un volcado completo.
En los pull requests
La segunda pieza es una GitHub Action que revisa automáticamente cada pull request y deja los hallazgos como comentarios en el diff. Necesita permisos de lectura sobre el repositorio y la clave de API guardada como secreto. A partir de ahí se configura: en qué momento se dispara (al abrir el PR, en cada push o solo manualmente), qué umbral de severidad bloquea el merge y qué rutas se excluyen del análisis.
Esa última parte importa más de lo que parece. Excluir vendor/, node_modules/, los ficheros generados y los de prueba evita que el 80% del informe hable de código que no mantienes tú. Y definir patrones permitidos para comportamientos que en tu organización son esperados —un endpoint interno sin autenticación porque vive detrás de la VPN, por ejemplo— es lo que mantiene el ruido a raya a medio plazo.
Si la cantidad de falsos positivos sigue siendo alta después de afinar exclusiones, la causa suele estar en el otro lado: convenciones del proyecto que no están escritas en ningún sitio. Documentarlas sirve para la herramienta y para las personas que entren al equipo.
Aplicación práctica en desarrollo de CRM
Para equipos que desarrollan integraciones con SuiteCRM u otros sistemas que manejan datos de clientes, la seguridad no es opcional. Claude Code Security permite auditar módulos personalizados antes de desplegarlos, verificar que las integraciones API no exponen datos sensibles, revisar workflows automatizados que manejan información personal, y evaluar la seguridad de webhooks y endpoints expuestos.
Qué miramos en un módulo a medida
Cuando entramos a revisar una personalización sobre un CRM, hay un guión que se repite. Primero, el control de acceso por registro: no basta con que el usuario esté dentro, hay que comprobar que ese cliente, esa oportunidad o ese presupuesto son de su equipo. Es el fallo más común y el más silencioso, porque la interfaz nunca lo enseña.
Después, los puntos de entrada que nadie recuerda: endpoints creados para una integración puntual que siguen abiertos dos años después, webhooks sin firma que aceptan cualquier payload, exportaciones a CSV que no filtran por permisos, y adjuntos que se sirven desde una ruta pública adivinable. Casi todos nacen de una urgencia resuelta un viernes.
Y por último, los datos en tránsito y en reposo: qué va al log (más de una vez, el token completo), qué se manda por correo, qué se queda en una tabla temporal sin borrar. Nada de esto es sofisticado, y es exactamente donde se concentran los incidentes reales. Si quieres un punto de partida ordenado para tu caso, el repaso de por dónde empezar en ciberseguridad cubre el orden sensato de prioridades.
En Keliam incorporamos Claude Code Security en nuestro pipeline de CI/CD: cada pull request pasa por un análisis de seguridad antes de poder ser mergeada. Esto ha reducido significativamente los defectos de seguridad que llegan a producción.
¿Quieres saber qué encontraría una revisión de seguridad en tu código?
Revisamos aplicaciones, integraciones y módulos a medida combinando análisis automatizado, revisión manual y pruebas sobre el entorno real. Te entregamos los hallazgos priorizados por riesgo y el plan de corrección, no un PDF de 200 páginas.
Cómo integrarlo en tu flujo de trabajo
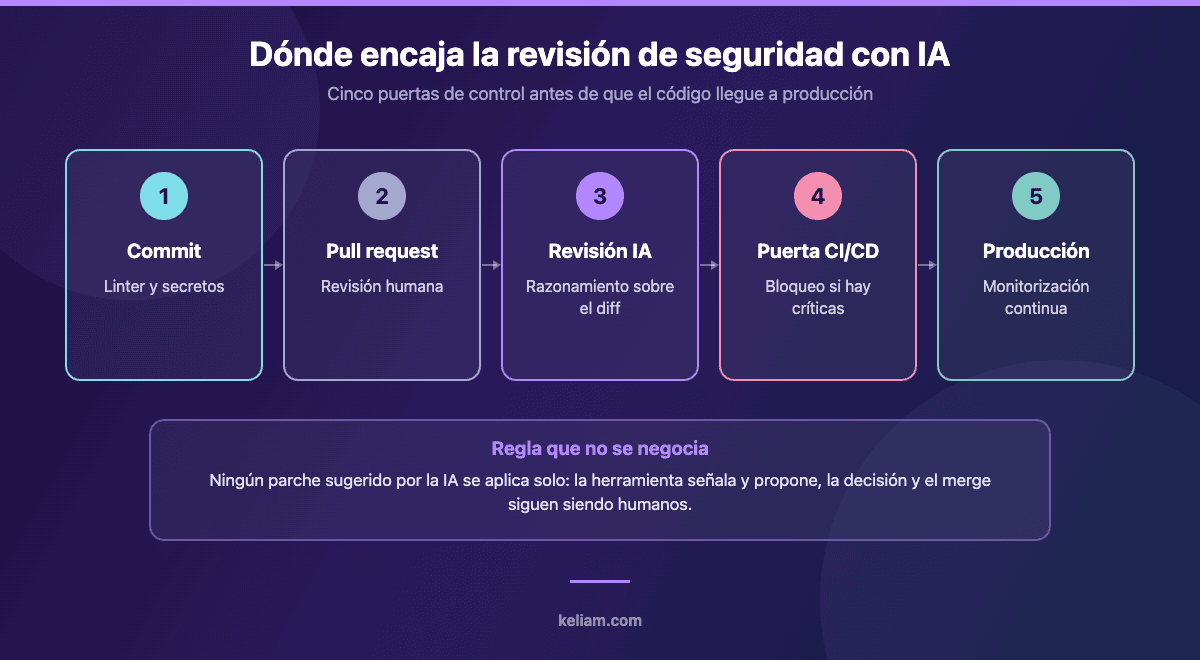
Claude Code Security se usa desde la terminal como parte de Claude Code. El flujo típico es ejecutar el análisis sobre un directorio o archivo específico, revisar los hallazgos clasificados por severidad, y aplicar las correcciones sugeridas. Para equipos, se puede automatizar como paso de CI/CD que bloquea merges si se detectan vulnerabilidades críticas.
Las cinco puertas, una por una
1. Commit. Lo barato y automático: linter, formateo, detección de secretos y comprobación de dependencias. Si algo de esto falla, no debería llegar ni a abrirse el pull request. Son segundos y evitan la mitad de los incidentes tontos.
2. Pull request con revisión humana. Sigue siendo la puerta más valiosa y la primera que se sacrifica cuando hay prisa. Una persona que conoce el dominio detecta en treinta segundos que un cambio en el cálculo de descuentos afecta a un cliente concreto, algo que ninguna herramienta va a inferir.
3. Revisión asistida por IA sobre el diff. Aquí entra el razonamiento semántico, y aquí es donde más rinde: sobre un cambio acotado, con el contexto del módulo cargado, no sobre el repositorio entero. Los hallazgos entran como comentarios, no como bloqueos automáticos.
4. Puerta de CI/CD. El umbral que decide si el merge se bloquea. La recomendación práctica es empezar bloqueando solo por severidad crítica con alta confianza, y endurecerlo cuando el equipo ya se fía de la señal. Al revés —bloquear todo desde el día uno— lo que se consigue es que alguien añada la excepción permanente al pipeline en la segunda semana.
5. Producción con monitorización. Porque el análisis estático es una foto fija y los ataques son una película. Aquí entran los registros, las alertas y la vigilancia de red, el terreno del que hablamos al explicar cómo montar seguridad desde cero en una pyme.
El riesgo de poner un modelo a leer todo tu código
Hay una ironía incómoda en todo esto: una herramienta pensada para reducir riesgo introduce uno nuevo. Conviene mirarlo de frente antes de darle acceso a un repositorio con la propiedad intelectual de la empresa dentro.
Inyección de prompt en el propio pipeline
El vector más concreto está documentado: el contenido de un pull request puede llevar instrucciones dirigidas al modelo que revisa. Si ese proceso tiene permisos sobre el repositorio o sobre el entorno de CI, una contribución externa maliciosa puede intentar aprovecharlos. De ahí la recomendación de restringir la revisión automática a repositorios de confianza y exigir aprobación manual antes de analizar PRs de fuera de la organización.
La regla general es tratar el proceso de revisión como una pieza privilegiada de la infraestructura, con los mismos cuidados que cualquier otra: permisos mínimos, secretos acotados, sin credenciales de producción y sin capacidad de escritura sobre ramas protegidas.
Gobernanza: qué conviene dejar registrado
Si la herramienta va a formar parte del proceso, alguien tiene que poder responder a cuatro preguntas: qué repositorios se analizan, con qué claves, quién puede cambiar la configuración del pipeline y qué se hace con los hallazgos que se descartan. Sin eso, lo que se ha creado no es un control, es una dependencia opaca.
Y hay un punto que se olvida: los hallazgos descartados también son información sensible. Una lista de vulnerabilidades conocidas y no corregidas, con su localización exacta en el código, es exactamente el documento que no quieres que se quede en un comentario público de un PR abierto.
Para organizaciones que trabajan con sistemas de gestión comercial y manejan datos sensibles de clientes, integrar análisis de seguridad con IA en el desarrollo no es un lujo sino una necesidad. En Keliam ayudamos a diseñar pipelines de desarrollo seguros que incluyen IA en todas las fases, desde el prototipado hasta la auditoría de seguridad.
Cómo encaja con ISO 27001 y el ENS
Si tu organización está certificada o va camino de estarlo, la pregunta no es si la herramienta es buena, sino qué evidencia produce. Los marcos de seguridad no piden una tecnología concreta: piden que exista un proceso de desarrollo seguro, que esté documentado y que se pueda demostrar que se aplica.
En ese esquema, la revisión asistida por IA encaja como actividad dentro del proceso, no como el proceso entero. Lo que se audita es que cada cambio pasa por una revisión de seguridad antes de llegar a producción, que los hallazgos se gestionan con un criterio escrito y que las excepciones están justificadas y aprobadas. Quién o qué detecta el fallo es secundario; lo que se revisa es la trazabilidad.
Para ver cómo se traduce esto a requisitos concretos, la guía de certificación ISO 27001 explica la estructura general, y el repaso de desarrollo seguro bajo ISO 27001 y ENS baja al detalle de qué se espera del ciclo de vida del software en ambos marcos. Si la certificación está cerca, merece la pena leer también qué ocurre en la auditoría de certificación antes de rediseñar el pipeline.
Cinco errores al adoptar revisión de seguridad con IA
Tratar el informe como una lista de tareas. Los hallazgos son hipótesis con nivel de confianza, no incidencias confirmadas. Convertirlos directamente en tickets asignados genera trabajo inútil y desgasta la credibilidad de la herramienta en dos sprints.
Aplicar los parches sugeridos sin leerlos. Las correcciones propuestas son un punto de partida. Más de una resuelve el síntoma y rompe un caso de uso legítimo que la herramienta no conocía.
Retirar los escáneres deterministas. Siguen siendo la base: barata, rápida y repetible. La revisión por razonamiento se suma encima, no sustituye.
No reservar tiempo de triaje. Si nadie tiene asignadas horas para revisar los hallazgos, el informe se acumula sin leer y al cabo de un mes la Action se desactiva «temporalmente».
Confundir código seguro con sistema seguro. Un repositorio limpio conviviendo con un servidor sin actualizar, credenciales compartidas por chat y copias de seguridad sin probar no es una organización segura. El código es una capa de varias.
Preguntas frecuentes
¿Está disponible Claude Code Security para cualquier empresa?
No en el momento de escribir esto. Salió como research preview limitada para clientes Enterprise y Team, con acceso acelerado para mantenedores de open source. El comando /security-review y la GitHub Action, en cambio, están disponibles para usuarios de planes de pago desde 2025.
¿Sustituye a un pentest?
No. El análisis es estático: lee el código, no ejecuta la aplicación. Los fallos de autorización a nivel de objeto, los abusos de lógica de negocio y las cadenas de explotación que requieren encadenar varias peticiones solo aparecen probando el sistema en funcionamiento.
¿Cuántos falsos positivos genera?
No hay cifras públicas. La propia comunidad de seguridad lo señaló como el principal dato que falta. En la práctica, el volumen depende mucho de cuánto se afinen las exclusiones y los patrones permitidos del proyecto.
¿Se puede usar en un entorno con requisitos de cumplimiento?
Sí, siempre que no se presente como el control formal. Al no ser determinista, no produce evidencia reproducible; se documenta como herramienta de detección adicional dentro de un proceso cuyo control auditable es otro.
¿Hay riesgo en darle acceso al repositorio?
Sí, y es el que más conviene gestionar: inyección de prompt a través del contenido de los PRs, exposición de propiedad intelectual y acumulación de información sobre vulnerabilidades no corregidas. Permisos mínimos, repositorios de confianza y aprobación manual para contribuciones externas.
¿Merece la pena si somos un equipo pequeño?
El comando desde la terminal, sí: cuesta poco, se usa cuando se quiere y encuentra cosas. La Action con bloqueo de merge tiene más sentido a partir de que haya varias personas tocando el mismo código y revisiones cruzadas de verdad.
Conclusión
Lo interesante de Claude Code Security no es la cifra de 500 vulnerabilidades, que es a la vez impresionante y discutible. Es que marca un cambio de categoría: por primera vez una herramienta automatizada encuentra fallos que no estaban en ninguna regla, en código que llevaba décadas revisado. Eso abre una puerta y, como toda puerta, se puede cruzar en los dos sentidos: quien busca defenderse gana una capa nueva, y quien busca atacar también.
La forma sensata de adoptarlo es sin épica: añadirlo como una puerta más en un pipeline que ya tenga las otras, reservar horas de persona para triar lo que devuelve, mantener los escáneres de siempre y no tocar la regla de que ningún parche entra sin que alguien lo haya leído. Hecho así, es una mejora clara. Hecho como sustituto de la revisión humana, es un riesgo con mejor marketing.